Карточка характеристик SPEC CARD
NVIDIA H100 NVL
94 ГБ HBM3 на карту, связка NVLink на 188 ГБ для двух карт, специализированный ускоритель для инференса LLM уровня 70B, двухслотовый дизайн с воздушным охлаждением 350–400 Вт — удобен для хостинга, в комплекте NVIDIA AI Enterprise, полуфлагман, которого не избежать на вторичном рынке
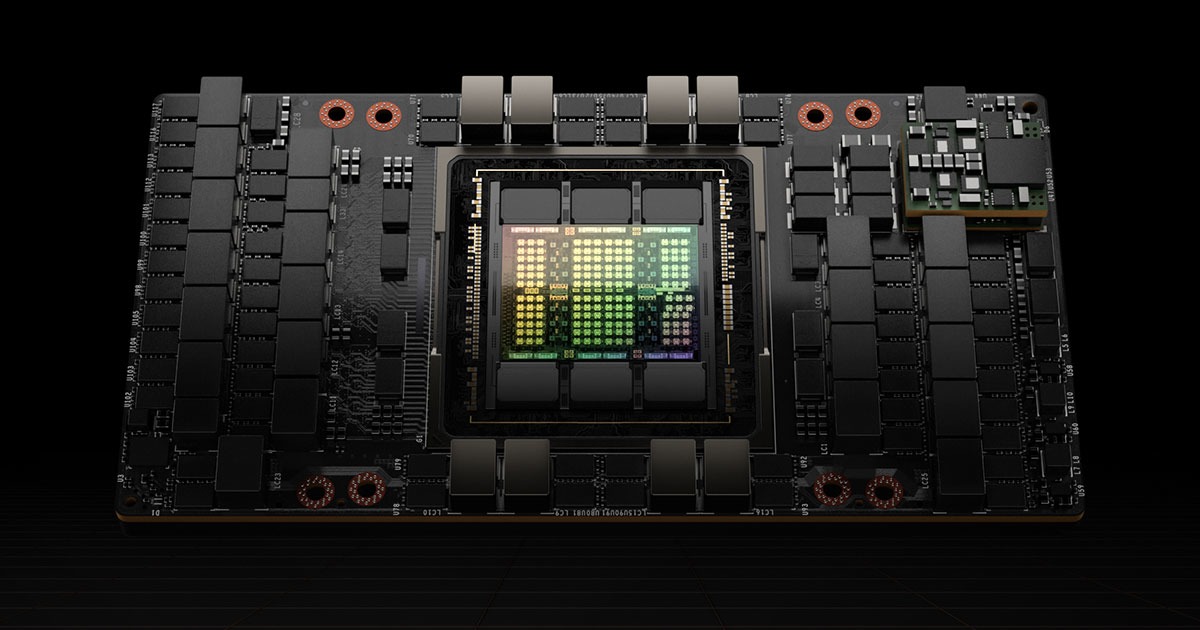
Официальное изображение NVIDIA
Обзор
NVIDIA H100 NVL — датацентровый GPU на архитектуре Hopper в форм-факторе PCIe, позиционируемый как полуфлагман для сценариев инференса с большим объёмом памяти. Одна карта оснащается 94 ГБ HBM3, а при соединении мостом NVLink две карты объединяются в единый пул на 188 ГБ, что подходит для инференса больших языковых моделей. Карта выполнена в двухслотовом дизайне с воздушным охлаждением, TDP настраивается в определённом диапазоне, что упрощает развёртывание в стандартных серверных стойках; межкартовая связь через NVLink обеспечивает двунаправленную пропускную способность интерконнекта 600 ГБ/с, а хостовый интерфейс — PCIe Gen5. В комплекте поставляется программный пакет NVIDIA AI Enterprise, покрывающий корпоративные задачи инференса и развёртывания ИИ.
Ключевые характеристики
| Архитектура | NVIDIA Hopper |
| Память | 94GB |
| Тип видеопамяти | HBM3 |
| Пропускная способность памяти | 3.9TB/s |
| Производительность FP64 | 30 teraFLOPs |
| FP64 Tensor Core | 60 teraFLOPs |
| Производительность FP32 | 60 teraFLOPs |
| Производительность FP8 | 3,341 teraFLOPS |
| Производительность FP16 | 1,671 teraFLOPS |
| Производительность INT8 | 3,341 TOPS |
| TDP, энергопотребление | 350-400W (configurable) |
| Интерконнект | NVIDIA NVLink: 600GB/s | PCIe Gen5: 128GB/s |
| Форм-фактор | PCIe dual-slot air-cooled |
| Разделение MIG | Up to 7 MIGS @ 12GB each |
| Кодеки | 7 NVDEC | 7 JPEG |
Характеристики сверены с официальными материалами (
Официальные бенчмарки , обновлено 2026-10-09) · Фактическая цена определяется предложением продавца
Сценарии применения
- Инференс больших языковых моделей (LLM): после связки двух карт по NVLink 188 ГБ памяти вмещают полные веса модели и оставляют запас под KV-кэш
- Разделение GPU-ресурсов для нескольких арендаторов: технология MIG делит одну карту на 7 экземпляров по 12 ГБ каждый — подходит для инференса малых моделей или изоляции нескольких задач
- Видео- и графические конвейеры: встроенные многоканальные декодеры NVDEC и блоки декодирования JPEG подходят для смешанных визуальных ИИ-нагрузок с инференсом и декодированием
- Развёртывание корпоративных ИИ-платформ: поставляемый в комплекте NVIDIA AI Enterprise даёт поддерживаемый корпоративный программный стек для инференса и дообучения в продакшене
Модели семейства
| Модель | Память | Потребление |
|---|
| NVIDIA T4 Сравнение | 16 ГБ GDDR6 с ECC (включена по умолчанию) | 70 Вт (общая потребляемая мощность платы, по умолчанию) |
| NVIDIA A100 Сравнение | Две версии: 40 ГБ HBM2 / 80 ГБ HBM2e (80 ГБ — дополнительный анонс на SC20 2020-11-16), с ECC | SXM4 400 Вт (одинаково для 40 ГБ/80 ГБ); PCIe-версия: 40 ГБ — 250 Вт / 80 ГБ — 300 Вт |
| NVIDIA H20 Сравнение | 96 ГБ HBM3 (три источника сходятся: Flopper/VipraTech/Новости Tencent) | TDP 400 Вт (три источника: Flopper/таблица спецификаций VipraTech/'тепловой дизайн-пакет 400 Вт' в новостях Tencent; противоречивая цифра 350 Вт из основного текста VipraTech отброшена) |
| NVIDIA GB300 Сравнение | 288 ГБ HBM3e (на один GPU-пакет; 576 ГБ в суперчипе; параллельно существуют значения 2,1 ТБ для платы HGX и 20 ТБ на стойку) | TGP до 1400 Вт |
| NVIDIA A30 Сравнение | 24 GB HBM2 | 165 W |
| NVIDIA GeForce RTX 4090 Сравнение | 24GB GDDR6X | 450 Вт TGP (в среднем в играх 315 Вт, рекомендуемый блок питания 850 Вт) |
Видеообзор VIDEO
Покупка и проверка: на что обратить внимание
- Проверка совместимости корпуса и питания: H100 NVL — двухслотовая PCIe-карта с воздушным охлаждением, TDP настраивается в определённом диапазоне; перед покупкой уточните высоту слотов сервера, организацию воздушных потоков и запас по питанию на карту. Решение с воздушным охлаждением предъявляет к охлаждению и шумоподавлению в серверной меньшие требования, чем вариант SXM с жидкостным охлаждением, но при полной нагрузке всё же необходим достаточный входящий поток воздуха
- Проверка конфигурации моста NVLink: если цель покупки — инференс на двух картах со 188 ГБ памяти, убедитесь в наличии моста NVLink в комплекте или поставке, а также в том, что расстояние между картами на материнской плате позволяет его установить; при использовании одной карты мост не нужен
- Ключевые пункты проверки при покупке на вторичном рынке и со склада: сверьте объём памяти (94 ГБ HBM3 на карту) и серийный номер устройства, протестируйте согласование линков NVLink и PCIe Gen5, убедитесь в работоспособности партиционирования MIG, а также уточните способ передачи лицензии NVIDIA AI Enterprise вместе с картой и оставшийся срок поддержки
Частые вопросы
Чем H100 NVL отличается от обычной версии H100 для PCIe?
H100 NVL — вариант H100 в форм-факторе PCIe; главное отличие — поддержка моста NVLink, позволяющего объединить две карты в общий пул памяти 188 ГБ, что создано специально для сценариев инференса с большой памятью между картами; стандартная PCIe-версия обычно не имеет заводского решения для моста. Обе карты построены на архитектуре Hopper.
Хватит ли 94 ГБ на одной карте для больших моделей? Когда нужна связка двух карт?
Это зависит от количества параметров модели и схемы квантизации. Если памяти одной карты недостаточно для весов модели и накладных расходов вроде KV-кэша, можно связать две H100 NVL через NVLink и получить 188 ГБ общей памяти. После объединения пул памяти соединяется через NVLink с пропускной способностью 600 ГБ/с, что эффективнее по коммуникациям, чем схемы с несколькими картами через PCIe Gen5.
Подходит ли H100 NVL для аренды или хостинга? Зачем нужен MIG?
Да, подходит. Карта выполнена в стандартном двухслотовом дизайне PCIe с воздушным охлаждением, а настраиваемый TDP позволяет развёртывать её в обычных стоечных серверах — порог входа в хостинг относительно невысок. Функция MIG физически делит одну карту на 7 независимых экземпляров по 12 ГБ, изолированных друг от друга, что удобно облачным провайдерам и командам для распределения одной карты между несколькими арендаторами или лёгкими задачами инференса.