Ficha técnica SPEC CARD
NVIDIA H100 NVL
94 GB de HBM3 por placa, 188 GB com ponte NVLink em dupla, placa dedicada à inferência de LLMs na faixa dos 70B, refrigerado a ar de 350-400 W em dois slots fácil de hospedar, NVIDIA AI Enterprise incluído, a quase flagship inevitável no mercado de usadas
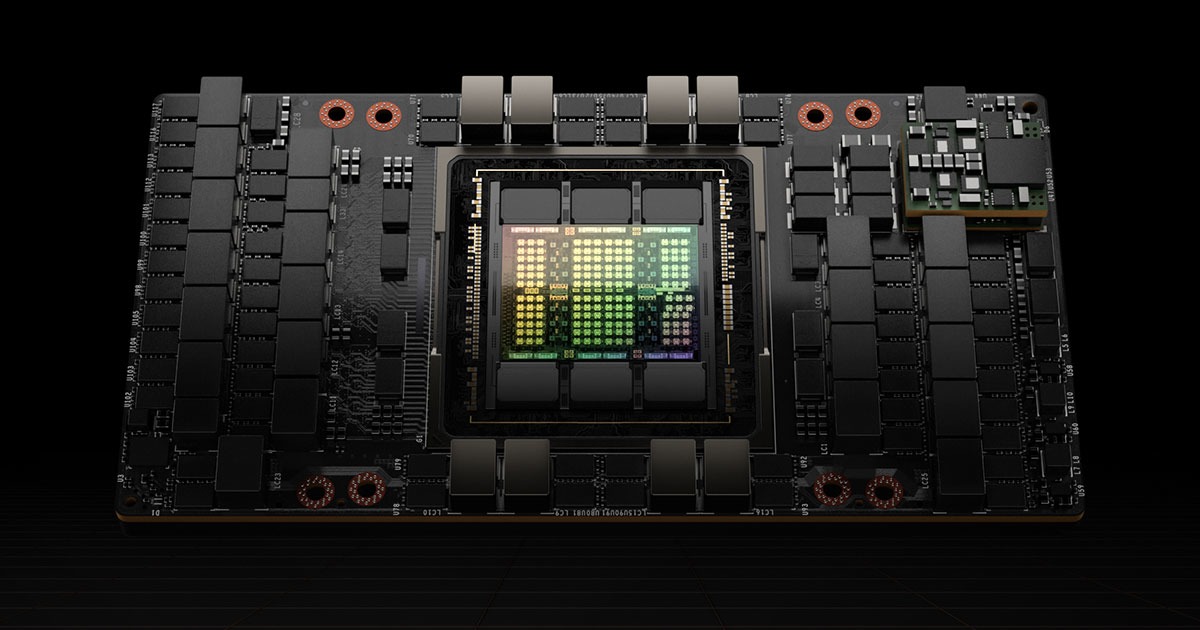
Imagem oficial do fabricante NVIDIA
Visão geral
A NVIDIA H100 NVL é uma GPU de data center em formato PCIe baseada na arquitetura Hopper, posicionada como um produto quase flagship para cenários de inferência com grande capacidade de memória. Cada placa vem com 94 GB de HBM3 e, via ponte NVLink, duas placas podem ser combinadas em um pool unificado de 188 GB, adequado para cargas de inferência de modelos de linguagem de grande porte. A placa adota design refrigerado a ar de dois slots, com TDP configurável dentro de uma faixa, facilitando a implantação em racks padrão; a interconexão NVLink entre placas oferece 600 GB/s bidirecionais, além de interface de host PCIe Gen5. A NVIDIA AI Enterprise acompanha a placa, cobrindo as necessidades de inferência e implantação de IA em nível corporativo.
Especificações principais
| Arquitetura | NVIDIA Hopper |
| Memória | 94GB |
| Tipo de memória | HBM3 |
| Largura de banda de memória | 3.9TB/s |
| Desempenho FP64 | 30 teraFLOPs |
| FP64 Tensor Core | 60 teraFLOPs |
| Desempenho FP32 | 60 teraFLOPs |
| Desempenho FP8 | 3,341 teraFLOPS |
| Desempenho FP16 | 1,671 teraFLOPS |
| Desempenho INT8 | 3,341 TOPS |
| Consumo TDP | 350-400W (configurable) |
| Interconexão | NVIDIA NVLink: 600GB/s | PCIe Gen5: 128GB/s |
| Forma | PCIe dual-slot air-cooled |
| Fatiamento MIG | Up to 7 MIGS @ 12GB each |
| Codecs | 7 NVDEC | 7 JPEG |
Especificações verificadas com base em documentação oficial (
Benchmarks oficiais , atualizado em 2026-10-09) · O preço real está sujeito à cotação do vendedor
Cenários de uso
- Serviços de inferência de LLMs de grande porte: com ponte NVLink em dupla, os 188 GB de memória comportam os pesos completos do modelo com espaço reservado para KV Cache
- Faticionamento de recursos GPU multi-inquilino: com a tecnologia MIG, uma placa pode ser dividida em até 7 instâncias de 12 GB cada, ideal para inferência de modelos menores ou isolamento de múltiplos serviços
- Pipelines de processamento de vídeo e imagem: com múltiplos decodificadores NVDEC e unidades de decodificação JPEG integradas, adequada para cargas de IA visual que misturam inferência e decodificação
- Implantação de plataformas de IA corporativas: com a NVIDIA AI Enterprise incluída, obtém-se uma stack de software corporativa com suporte para inferência e fine-tuning em produção
Modelos da mesma família
| Modelo | Memória | Consumo |
|---|
| NVIDIA T4 Comparar | 16GB GDDR6 com ECC (ativado por padrão) | 70W (potência total da placa, padrão) |
| NVIDIA A100 Comparar | Duas versões: 40GB HBM2 / 80GB HBM2e (a de 80GB anunciada na SC20 em 16/11/2020), com ECC | SXM4 400W (igual para 40GB/80GB); versão PCIe: 40GB 250W / 80GB 300W |
| NVIDIA H20 Comparar | 96GB HBM3 (três fontes consistentes: Flopper/VipraTech/Tencent News) | 400W TDP (três fontes: tabela de especificações Flopper/VipraTech e Tencent News com 'TDP de 400W'; o texto da VipraTech mencionava 350W, valor contraditório descartado) |
| NVIDIA GB300 Comparar | 288GB HBM3e (por encapsulamento de GPU; 576GB no superchip; HGX a nível de placa com 2,1TB / rack com 20TB, coexistindo) | TGP de até 1400W |
| NVIDIA A30 Comparar | 24 GB HBM2 | 165 W |
| NVIDIA GeForce RTX 4090 Comparar | 24GB GDDR6X | 450W TGP (média de 315W em jogos, fonte recomendada de 850W) |
Vídeo explicativo VIDEO
Pontos de compra e inspeção
- Confirme a compatibilidade do chassi e da fonte: a H100 NVL é refrigerado a ar em formato PCIe de dois slots, com TDP configurável dentro de uma faixa; antes da compra, verifique a altura dos slots do servidor, o desenho do fluxo de ar e a margem de alimentação por placa. A solução refrigerado a ar exige menos do gerenciamento térmico e de ruído da sala do que a solução SXM refrigerado a líquido, mas em carga máxima ainda é preciso garantir fluxo de ar frontal suficiente
- Valide a configuração da ponte NVLink: se o objetivo é inferência com 188 GB de memória em dupla, confirme se a ponte NVLink acompanha a placa ou o kit, e se o espaçamento entre placas na placa-mãe permite instalá-la; em uso com uma única placa, a ponte pode ser dispensada
- Pontos de verificação em canais de usadas e estoque: confira a capacidade de memória (94 GB de HBM3 por placa) e o número de série, teste a negociação dos links NVLink e PCIe Gen5, verifique o funcionamento do particionamento MIG e confirme como a licença da NVIDIA AI Enterprise é entregue com a placa e o prazo de suporte restante
Perguntas frequentes
Qual a diferença entre a H100 NVL e a H100 PCIe convencional?
A H100 NVL é uma variante da H100 em formato PCIe, cuja principal diferença é o suporte à ponte NVLink, permitindo combinar duas placas em um pool conjunto de 188 GB, projetada para cenários de inferência que exigem grande memória entre placas; a versão PCIe padrão normalmente não traz solução de ponte de fábrica. Ambas são baseadas na arquitetura Hopper.
94 GB em uma placa bastam para modelos grandes? Quando é preciso a ponte em dupla?
Depende do número de parâmetros do modelo e do esquema de quantização. Se a memória de uma única placa não comportar os pesos do modelo mais os custos de execução como KV Cache, é possível pontear duas H100 NVL via NVLink para obter 188 GB de memória conjunta. Após a ponte, o pool de memória é conectado pelo NVLink a 600 GB/s, com eficiência de comunicação superior a soluções multi-placa via PCIe Gen5.
A H100 NVL serve para aluguel ou hospedagem? Para que serve a MIG?
Sim. Com design refrigerado a ar padrão PCIe de dois slots e TDP configurável, ela pode ser implantada em servidores de rack convencionais, com barreira de hospedagem relativamente baixa. A função MIG permite dividir fisicamente uma placa em até 7 instâncias independentes de 12 GB cada, isoladas entre si, ideal para provedores de nuvem ou equipes que queiram distribuir uma placa entre vários inquilinos ou várias tarefas leves de inferência.
Dados atualizados em 2026-10-09 · Ir para a Ficha em profundidade
Política editorial fluxo