SECTIONS
EDITIONS
NETWORK
스펙 카드 SPEC CARD
NVIDIA H100 NVL
카드당 94GB HBM3, 듀얼 카드 NVLink 브리지로 188GB, 70B급 LLM 추론 전용 카드, 350-400W 공랭 2슬롯으로 호스팅이 용이, NVIDIA AI Enterprise 동봉, 중고 시장에서 피할 수 없는 준플래그십
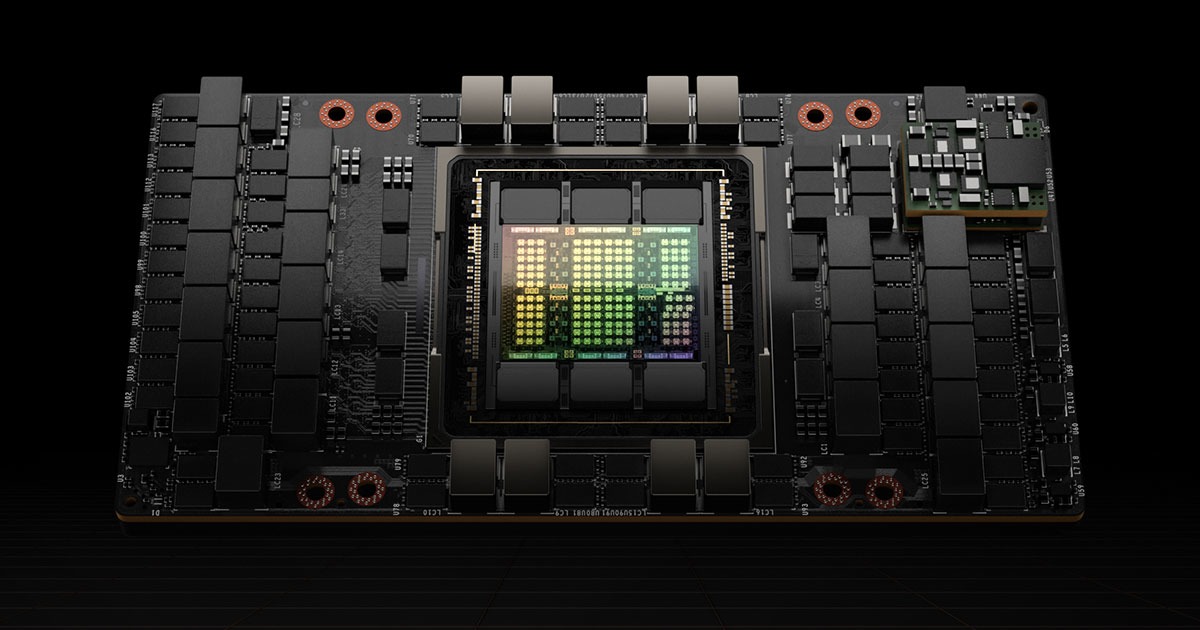
NVIDIA 공식 제조사 이미지
개요
NVIDIA H100 NVL은 NVIDIA가 Hopper 아키텍처 기반으로 출시한 PCIe 폼팩터의 데이터센터 GPU로, 대용량 메모리 추론 시나리오를 위한 준플래그십 제품으로 자리매김합니다. 카드당 94GB HBM3 메모리를 탑재했으며, NVLink 브리지를 통해 두 장의 카드를 188GB 통합 메모리 풀로 구성할 수 있어 대규모 파라미터 언어 모델의 추론 워크로드를 감당하기에 적합합니다. 이 카드는 2슬롯 공랭 설계를 채택했으며 TDP를 일정 범위 내에서 설정할 수 있어 표준 랙 환경에 손쉽게 배포할 수 있습니다. 카드 간에는 NVLink로 양방향 600GB/s 인터커넥트 대역폭을 제공하며, PCIe Gen5 호스트 인터페이스도 지원합니다. NVIDIA AI Enterprise 소프트웨어 스위트가 카드와 함께 제공되어 기업급 AI 추론 및 배포 요구를 충족합니다.
핵심 스펙
| 아키텍처 | NVIDIA Hopper |
| 메모리 | 94GB |
| 메모리 타입 | HBM3 |
| 메모리 대역폭 | 3.9TB/s |
| FP64 연산 성능 | 30 teraFLOPs |
| FP64 Tensor Core | 60 teraFLOPs |
| FP32 연산 성능 | 60 teraFLOPs |
| FP8 연산 성능 | 3,341 teraFLOPS |
| FP16 연산 성능 | 1,671 teraFLOPS |
| INT8 연산 성능 | 3,341 TOPS |
| 전력 소모 TDP | 350-400W (configurable) |
| 인터커넥트 | NVIDIA NVLink: 600GB/s | PCIe Gen5: 128GB/s |
| 폼팩터 | PCIe dual-slot air-cooled |
| MIG 슬라이싱 | Up to 7 MIGS @ 12GB each |
| 코덱 | 7 NVDEC | 7 JPEG |
스펙은 공식 자료 기준으로 검증되었습니다(공식 벤치마크,2026-10-09 업데이트)· 실제 가격은 판매자 제시가 기준
적용 시나리오
- 대규모 파라미터 언어 모델(LLM) 추론 서비스: 듀얼 카드 NVLink 브리지 후 188GB 메모리로 전체 모델 가중치를 수용하고 KV Cache 공간까지 확보 가능
- 멀티 테넌트 GPU 리소스 분할: MIG 기술로 카드당 최대 7개 인스턴스로 분할, 인스턴스당 12GB 메모리로 소형 모델 추론 또는 업무 격리에 적합
- 영상 및 이미지 처리 파이프라인: 다중 NVDEC 디코더와 JPEG 디코딩 유닛 내장, 추론과 디코딩이 혼합된 비전 AI 워크로드에 적합
- 기업급 AI 플랫폼 배포: 동봉된 NVIDIA AI Enterprise를 통해 지원되는 기업용 소프트웨어 스택 확보, 프로덕션 환경의 추론 및 파인튜닝 작업에 활용
동일 계열 모델
| 모델 | 메모리 | 소비 전력 |
|---|---|---|
| NVIDIA T4 비교 | 16GB GDDR6 with ECC (기본 활성화) | 70W (보드 전체 전력, 기본값) |
| NVIDIA A100 비교 | 40GB HBM2 / 80GB HBM2e 듀얼 버전(80GB 버전은 2020-11-16 SC20에서 추가 공개), ECC 탑재 | SXM4 400W(40GB/80GB 공통); PCIe 버전 40GB 250W / 80GB 300W |
| NVIDIA H20 비교 | 96GB HBM3(Flopper/VipraTech/텐센트 뉴스 3개 소스 일치) | 400W TDP(Flopper/VipraTech 사양표/텐센트 뉴스 '열설계전력 400W' 3개 소스; VipraTech 본문의 350W 상충 수치는 기각) |
| NVIDIA GB300 비교 | 288GB HBM3e(단일 GPU 패키지 기준; 슈퍼칩 576GB; HGX 보드 레벨 2.1TB/랙 20TB 병기) | TGP 최대 1400W |
| NVIDIA A30 비교 | 24 GB HBM2 | 165 W |
| NVIDIA GeForce RTX 4090 비교 | 24GB GDDR6X | 450W TGP (평균 게이밍 315W, 권장 시스템 파워 850W) |
영상 해설 VIDEO
심층 읽기 자료:H100 · 심층 항목
구매 및 검수 포인트
- 섀시와 파워 호환성 확인: H100 NVL은 PCIe 2슬롯 공랭 폼팩터이며 TDP를 일정 범위 내에서 설정할 수 있습니다. 구매 전 서버 슬롯 높이, 에어플로 설계, 카드당 전원 여유를 확인해야 합니다. 공랭 방식은 수랭 SXM 방식보다 서버실 냉각과 소음 관리 요구가 낮지만, 풀 로드 시 충분한 전면 흡기 풍량을 확보해야 합니다.
- NVLink 브리지 구성 검증: 듀얼 카드 188GB 대용량 메모리 추론이 구매 목표라면 카드 동봉 또는 별도 제공되는 NVLink 브리지가 구비되어 있는지, 그리고 메인보드의 카드 간 간격이 브리지 설치 조건을 충족하는지 확인해야 합니다. 단일 카드 사용 시 브리지는 생략할 수 있습니다.
- 중고 및 재고 채널 검수 포인트: 메모리 용량(카드당 94GB HBM3)과 장치 시리얼 번호 대조, NVLink 및 PCIe Gen5 링크 협상 상태 테스트, MIG 파티셔닝 기능 정상 작동 확인, NVIDIA AI Enterprise 라이선스의 카드 동봉 전달 방식과 잔여 지원 기간 확인
자주 묻는 질문
H100 NVL과 일반 PCIe판 H100은 어떤 차이가 있나요?
H100 NVL은 PCIe 형태의 H100 변형으로, 주요 차이는 NVLink 브리지 기능을 갖추어 두 장의 카드를 188GB 연합 VRAM 풀로 브리징할 수 있으며, 카드 간 대용량 VRAM이 필요한 추론 시나리오를 위해 설계되었습니다; 표준 PCIe판은 보통 출고 시 브리징 솔루션이 없습니다. 양자는 모두 Hopper 아키텍처 기반입니다.
카드당 94GB로 대형 모델을 구동할 수 있나요? 언제 듀얼 카드 브리지가 필요한가요?
모델 파라미터 수와 양자화 방안에 따라 달라집니다. 단일 카드 메모리로 모델 가중치와 KV Cache 등 런타임 오버헤드를 수용하기 부족하다면, NVLink 브리지로 두 장의 H100 NVL을 연결해 188GB 통합 메모리를 확보할 수 있습니다. 브리지 후 메모리 풀은 NVLink가 600GB/s 대역폭으로 연결하여, PCIe Gen5를 경유하는 멀티 카드 방식보다 통신 효율이 높습니다.
H100 NVL은 임대나 호스팅에 적합한가요? MIG는 어떤 용도인가요?
적합합니다. 이 카드는 표준 PCIe 2슬롯 공랭 설계를 채택했으며, 설정 가능한 TDP 덕분에 일반 랙 서버에 배포할 수 있어 호스팅 진입 장벽이 상대적으로 낮습니다. MIG 기능은 카드 하나를 물리적으로 최대 7개의 독립 인스턴스로 분할할 수 있으며, 인스턴스당 12GB 메모리로 서로 격리되어 클라우드 사업자나 팀이 카드 한 장을 여러 테넌트 또는 여러 경량 추론 작업에 나누어 쓰기에 적합합니다.
심층 읽기:H100-NVL 심층 항목 · 심층 항목H100 vs H100-NVL · 심층 항목H200-NVL vs H100-NVL · 심층 항목NVIDIA A10 · 심층 항목NVIDIA A100 · 심층 항목
자료 업데이트 2026-10-09 · 심층 항목으로 이동 편집 방침 프로세스