Fiche technique SPEC CARD
NVIDIA H100 NVL
94 Go de HBM3 par carte, 188 Go en pont NVLink sur deux cartes, carte dédiée à l'inférence de LLM de classe 70B, 350-400W refroidi par air sur deux emplacements, facile à héberger, NVIDIA AI Enterprise incluse, le quasi-flagship incontournable du marché de l'occasion
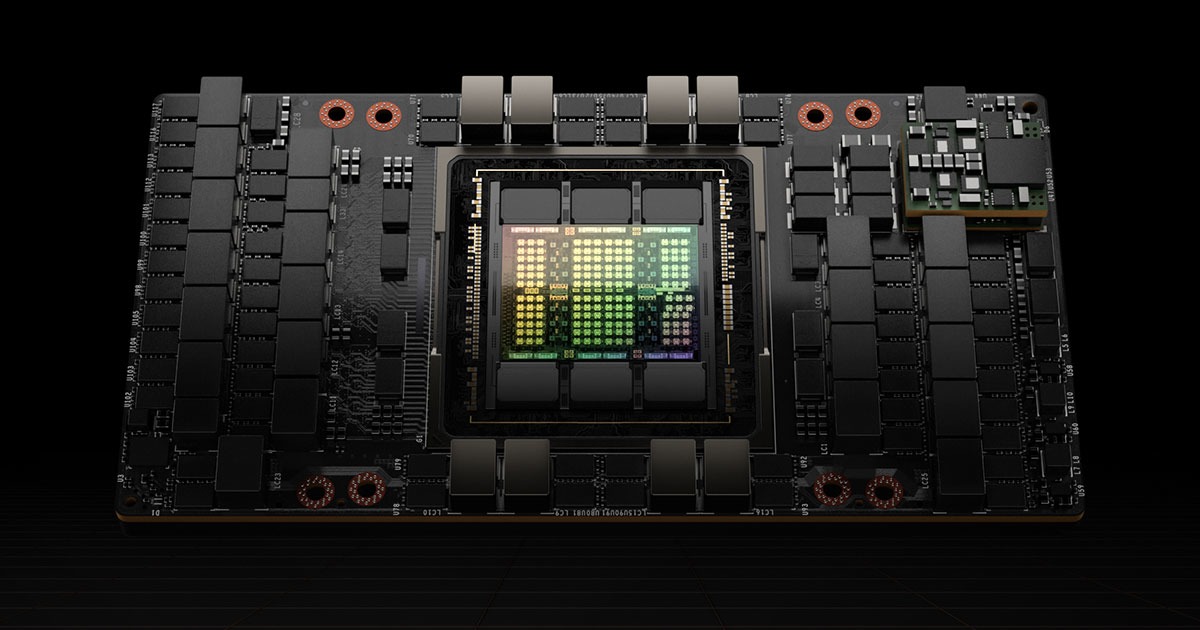
Image officielle du fabricant NVIDIA
Vue d'ensemble
La NVIDIA H100 NVL est un GPU datacenter au format PCIe basé sur l'architecture Hopper, positionnée comme un quasi-flagship pour les scénarios d'inférence à grande mémoire. Chaque carte embarque 94 Go de HBM3, et le pont NVLink permet de combiner deux cartes en un pool de mémoire unifié de 188 Go, adapté aux charges d'inférence de modèles de langage à grand nombre de paramètres. La carte adopte un design bi-slot refroidi par air avec un TDP configurable dans une certaine plage, ce qui facilite le déploiement en environnement rack standard ; l'interconnexion NVLink entre cartes offre une bande passante d'interconnexion bidirectionnelle de 600 Go/s, avec une interface hôte PCIe Gen5. Le NVIDIA AI Enterprise est fourni avec la carte, couvrant les besoins d'inférence et de déploiement IA de niveau entreprise.
Spécifications clés
| Architecture | NVIDIA Hopper |
| Mémoire vidéo | 94GB |
| Type de mémoire | HBM3 |
| Bande passante mémoire | 3.9TB/s |
| Puissance FP64 | 30 teraFLOPs |
| FP64 Tensor Core | 60 teraFLOPs |
| Puissance FP32 | 60 teraFLOPs |
| Puissance de calcul FP8 | 3,341 teraFLOPS |
| Puissance FP16 | 1,671 teraFLOPS |
| Puissance INT8 | 3,341 TOPS |
| Consommation TDP | 350-400W (configurable) |
| Interconnexion | NVIDIA NVLink: 600GB/s | PCIe Gen5: 128GB/s |
| Format | PCIe dual-slot air-cooled |
| Découpage MIG | Up to 7 MIGS @ 12GB each |
| Codecs | 7 NVDEC | 7 JPEG |
Spécifications vérifiées contre les sources officielles (
benchmarks officiels , mise à jour le 2026-10-09) · Le prix réel est soumis au devis du vendeur
Cas d'usage
- Services d'inférence de modèles de langage à grand nombre de paramètres (LLM) : avec le pont NVLink, les 188 Go de mémoire peuvent contenir l'intégralité des poids du modèle tout en laissant de l'espace pour le KV Cache
- Partitionnement des ressources GPU multi-locataires : la technologie MIG permet de diviser une carte en jusqu'à 7 instances de 12 Go chacune, adapté à l'inférence de petits modèles ou à l'isolation de plusieurs charges de travail
- Pipelines de traitement vidéo et d'images : décodeurs NVDEC multiples et unités de décodage JPEG intégrés, adapté aux charges d'IA visuelle mêlant inférence et décodage
- Déploiement de plateformes IA d'entreprise : le NVIDIA AI Enterprise inclus fournit une pile logicielle d'entreprise supportée pour l'inférence et le fine-tuning en production
Modèles de la même famille
| Modèle | Mémoire vidéo | TDP |
|---|
| NVIDIA T4 Comparer | 16 Go GDDR6 avec ECC (activé par défaut) | 70 W (puissance totale de la carte, par défaut) |
| NVIDIA A100 Comparer | Double version 40 Go HBM2 / 80 Go HBM2e (version 80 Go annoncée le 2020-11-16 à SC20), avec ECC | SXM4 400 W (identique en 40 Go et 80 Go) ; version PCIe : 40 Go 250 W / 80 Go 300 W |
| NVIDIA H20 Comparer | 96 Go HBM3 (concordance Flopper/VipraTech/Tencent News) | 400 W TDP (Flopper/tableau VipraTech/'400 W TDP' Tencent News, triple concordance ; les 350 W mentionnés dans le corps du texte de VipraTech, contradictoires, ont été écartés) |
| NVIDIA GB300 Comparer | 288 Go HBM3e (par cœur GPU ; 576 Go pour la superpuce ; 2,1 To au niveau carte HGX / 20 To par baie, deux chiffres coexistant) | TGP jusqu'à 1400 W |
| NVIDIA A30 Comparer | 24 GB HBM2 | 165 W |
| NVIDIA GeForce RTX 4090 Comparer | 24GB GDDR6X | 450 W TGP (335 W en jeu en moyenne, alimentation système recommandée 850 W) |
Présentation vidéo VIDEO
Points d'achat et de vérification
- Vérifier la compatibilité du châssis et de l'alimentation : la H100 NVL est au format PCIe bi-slot refroidi par air avec un TDP configurable dans une certaine plage ; avant l'achat, il faut vérifier la hauteur des emplacements du serveur, la conception du flux d'air et la marge d'alimentation par carte. La solution refroidi par air exige moins en matière de gestion thermique et acoustique de la salle qu'une solution SXM refroidi par liquide, mais un débit d'air frontal suffisant reste nécessaire en pleine charge
- Vérifier la configuration du pont NVLink : si l'objectif est l'inférence à grande mémoire de 188 Go sur deux cartes, il faut confirmer que le pont NVLink est bien fourni avec les cartes, et que l'espacement des cartes sur la carte mère permet son installation ; en usage mono-carte, le pont peut être omis
- Points de contrôle pour les canaux d'occasion et de stock : vérifier la capacité mémoire (94 Go de HBM3 par carte) et le numéro de série, tester la négociation des liens NVLink et PCIe Gen5, confirmer le bon fonctionnement du partitionnement MIG, et vérifier le mode de livraison de la licence NVIDIA AI Enterprise ainsi que la durée de support restante
FAQ
Quelle est la différence entre la H100 NVL et la H100 PCIe standard ?
La H100 NVL est une variante PCIe de la H100 dont la principale différence réside dans la prise en charge du pont NVLink, permettant de combiner deux cartes en un pool de mémoire de 188 Go, conçue pour les scénarios d'inférence nécessitant une grande mémoire inter-cartes ; la version PCIe standard n'est généralement pas livrée avec une solution de pontage en usine. Les deux sont basées sur l'architecture Hopper.
94 Go par carte suffisent-ils pour faire tourner de grands modèles ? Quand faut-il le pontage bi-carte ?
Cela dépend du nombre de paramètres du modèle et de la solution de quantification. Si la mémoire d'une seule carte ne suffit pas à contenir les poids du modèle ainsi que le KV Cache et les autres surcoûts d'exécution, il est possible de ponter deux H100 NVL via NVLink pour obtenir 188 Go de mémoire combinée. Une fois pontées, le pool de mémoire est relié par NVLink à 600 Go/s, avec une efficacité de communication supérieure à une solution multi-cartes passant par PCIe Gen5.
La H100 NVL convient-elle à la location ou à l'hébergement ? À quoi sert MIG ?
Oui. La carte adopte un design PCIe bi-slot refroidi par air standard, et son TDP configurable permet un déploiement dans des serveurs rack classiques, avec un seuil d'hébergement relativement bas. La fonction MIG permet de diviser physiquement une carte en jusqu'à 7 instances indépendantes de 12 Go chacune, isolées les unes des autres, adapté aux fournisseurs de cloud ou aux équipes souhaitant partager une carte entre plusieurs locataires ou plusieurs tâches d'inférence légères.