Ficha técnica SPEC CARD
NVIDIA H100 NVL
94 GB de HBM3 por tarjeta, 188 GB con puente NVLink de dos tarjetas, GPU dedicada a la inferencia de LLM de nivel 70B, refrigerado por aire de doble ranura a 350-400 W, fácil de alojar, con NVIDIA AI Enterprise incluido, el casi tope de gama ineludible en el mercado de segunda mano
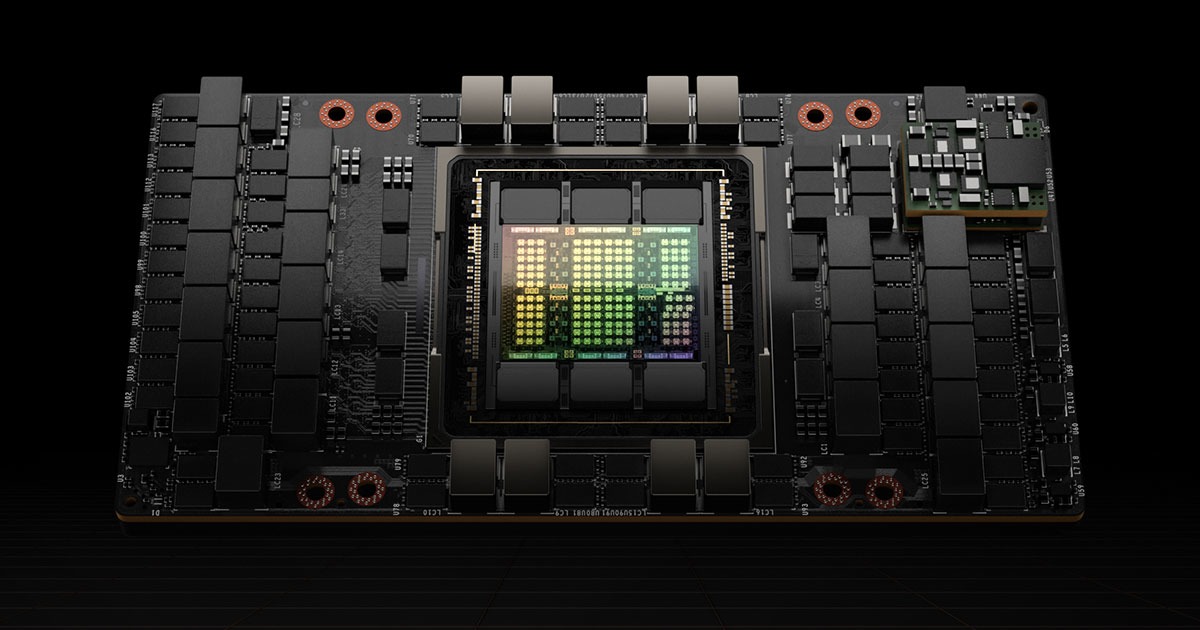
Imagen oficial del fabricante NVIDIA
Resumen
La NVIDIA H100 NVL es una GPU de centro de datos en formato PCIe basada en la arquitectura Hopper de NVIDIA, posicionada como un producto casi tope de gama para escenarios de inferencia con grandes cantidades de memoria. Cada tarjeta cuenta con 94 GB de memoria HBM3 y, mediante un puente NVLink, dos tarjetas pueden combinarse en un único bloque de memoria unificado de 188 GB, ideal para cargas de inferencia de modelos de lenguaje con un gran número de parámetros. La tarjeta adopta un diseño de doble ranura con refrigerado por aire y un TDP configurable dentro de cierto rango, lo que facilita su despliegue en entornos de rack estándar. El NVLink proporciona un ancho de banda de interconexión bidireccional de 600 GB/s entre tarjetas, junto con soporte de interfaz de host PCIe Gen5. Incluye el paquete de software NVIDIA AI Enterprise, que cubre las necesidades de inferencia y despliegue de IA a nivel empresarial.
Especificaciones clave
| Arquitectura | NVIDIA Hopper |
| Memoria | 94GB |
| Tipo de memoria | HBM3 |
| Ancho de banda de memoria | 3.9TB/s |
| Rendimiento FP64 | 30 teraFLOPs |
| FP64 Tensor Core | 60 teraFLOPs |
| Rendimiento FP32 | 60 teraFLOPs |
| Rendimiento FP8 | 3,341 teraFLOPS |
| Rendimiento FP16 | 1,671 teraFLOPS |
| Rendimiento INT8 | 3,341 TOPS |
| Consumo TDP | 350-400W (configurable) |
| Interconexión | NVIDIA NVLink: 600GB/s | PCIe Gen5: 128GB/s |
| Formato | PCIe dual-slot air-cooled |
| Segmentación MIG | Up to 7 MIGS @ 12GB each |
| Códecs | 7 NVDEC | 7 JPEG |
Especificaciones verificadas con documentación oficial (
Benchmarks oficiales , actualizado el 2026-10-09) · El precio real está sujeto a la cotización del vendedor
Casos de uso
- Servicios de inferencia de modelos de lenguaje de gran tamaño (LLM): tras el puente NVLink, los 188 GB de memoria permiten alojar los pesos completos del modelo y dejar espacio para la KV Cache
- Segmentación de recursos GPU multiarrendatario: la tecnología MIG permite dividir una tarjeta en hasta 7 instancias de 12 GB de memoria cada una, adecuada para inferencia de modelos pequeños o para aislar varias cargas de negocio
- Pipelines de procesamiento de vídeo e imágenes: con múltiples decodificadores NVDEC y unidades de decodificación JPEG integradas, apta para cargas de IA visual que combinan inferencia y decodificación
- Despliegue de plataformas de IA empresariales: gracias al NVIDIA AI Enterprise incluido, se obtiene una pila de software empresarial con soporte para tareas de inferencia y fine-tuning en producción
Modelos de la misma familia
| Modelo | Memoria | Consumo |
|---|
| NVIDIA T4 Comparación | 16GB GDDR6 con ECC (activado por defecto) | 70W (potencia total de la placa, por defecto) |
| NVIDIA A100 Comparación | Doble versión: 40GB HBM2 / 80GB HBM2e (la de 80GB se presentó el 16-11-2020 en la SC20), con ECC | SXM4 400W (igual en 40GB/80GB); versión PCIe: 40GB 250W / 80GB 300W |
| NVIDIA H20 Comparación | 96GB HBM3 (coincidencia en tres fuentes: Flopper/VipraTech/Tencent News) | TDP de 400W (coincidencia en tres fuentes: Flopper/tabla de especificaciones de VipraTech/'TDP de 400W' en Tencent News; se descarta la cifra contradictoria de 350W en el texto de VipraTech) |
| NVIDIA GB300 Comparación | 288GB HBM3e (por paquete de GPU; 576GB en el superchip; coexisten 2,1TB a nivel de placa HGX y 20TB por rack) | TGP de hasta 1400W |
| NVIDIA A30 Comparación | 24 GB HBM2 | 165 W |
| NVIDIA GeForce RTX 4090 Comparación | 24GB GDDR6X | TGP de 450W (315W en juegos de media, fuente de alimentación recomendada de 850W) |
Vídeo explicativo VIDEO
Puntos clave de compra e inspección
- Verificar la compatibilidad del chasis y la fuente de alimentación: la H100 NVL es de formato PCIe de doble ranura con refrigerado por aire y TDP configurable dentro de cierto rango; antes de comprar hay que comprobar la altura de las ranuras del servidor, el diseño del flujo de aire y el margen de alimentación por tarjeta. La solución de refrigerado por aire exige menos al enfriamiento y la gestión de ruido del centro de datos que la variante SXM refrigerado por líquido, pero en plena carga sigue siendo necesario garantizar suficiente caudal de aire frontal
- Verificar la configuración del puente NVLink: si el objetivo es la inferencia con 188 GB de memoria en dos tarjetas, hay que confirmar que el puente NVLink venga incluido con la tarjeta o en el kit, y que la separación entre tarjetas de la placa base permita instalarlo; con una sola tarjeta el puente puede omitirse
- Puntos de inspección en canales de segunda mano y stock: comprobar la capacidad de memoria (94 GB de HBM3 por tarjeta) y el número de serie del dispositivo, probar el estado de negociación de los enlaces NVLink y PCIe Gen5, confirmar que la función de partición MIG funciona correctamente, y verificar la forma de entrega de la licencia de NVIDIA AI Enterprise con la tarjeta y el tiempo de soporte restante
Preguntas frecuentes
¿En qué se diferencia la H100 NVL de la versión PCIe estándar de la H100?
La H100 NVL es una variante de la H100 en formato PCIe cuya principal diferencia es que incorpora capacidad de puente NVLink, lo que permite unir dos tarjetas en un bloque de memoria conjunto de 188 GB, diseñada específicamente para escenarios de inferencia que requieren gran memoria entre tarjetas; la versión PCIe estándar normalmente no incluye solución de puente de fábrica. Ambas se basan en la arquitectura Hopper.
¿Basta con 94 GB por tarjeta para ejecutar modelos grandes? ¿Cuándo se necesita el puente de dos tarjetas?
Depende del número de parámetros del modelo y del esquema de cuantización. Si la memoria de una sola tarjeta no basta para alojar los pesos del modelo más los costes en tiempo de ejecución como la KV Cache, se puede unir dos H100 NVL mediante el puente NVLink para obtener 188 GB de memoria conjunta. Tras el puente, el bloque de memoria se conecta por NVLink a 600 GB/s, con una eficiencia de comunicación superior a la de una solución multi-GPU que pase por PCIe Gen5.
¿La H100 NVL es apta para alquiler o alojamiento? ¿Para qué sirve MIG?
Sí. Con su diseño PCIe estándar de doble ranura con refrigerado por aire y su TDP configurable, puede desplegarse en servidores de rack convencionales, con una barrera de alojamiento relativamente baja. La función MIG permite dividir físicamente una tarjeta en hasta 7 instancias independientes de 12 GB de memoria cada una, aisladas entre sí, ideal para que proveedores en la nube o equipos repartan una tarjeta entre varios arrendatarios o varias tareas ligeras de inferencia.