Spec-Card SPEC CARD
NVIDIA H100 NVL
94 GB HBM3 pro Karte, 188 GB per NVLink-Bridge im Duo, dedizierte Karte für LLM-Inferenz im 70B-Klasse-Bereich, 350–400 W luftgekühlt im Dual-Slot-Format und colocationfreundlich, NVIDIA AI Enterprise im Lieferumfang, der Quasi-Flaggschiff-Kandidat, an dem man auf dem Gebrauchtmarkt nicht vorbeikommt
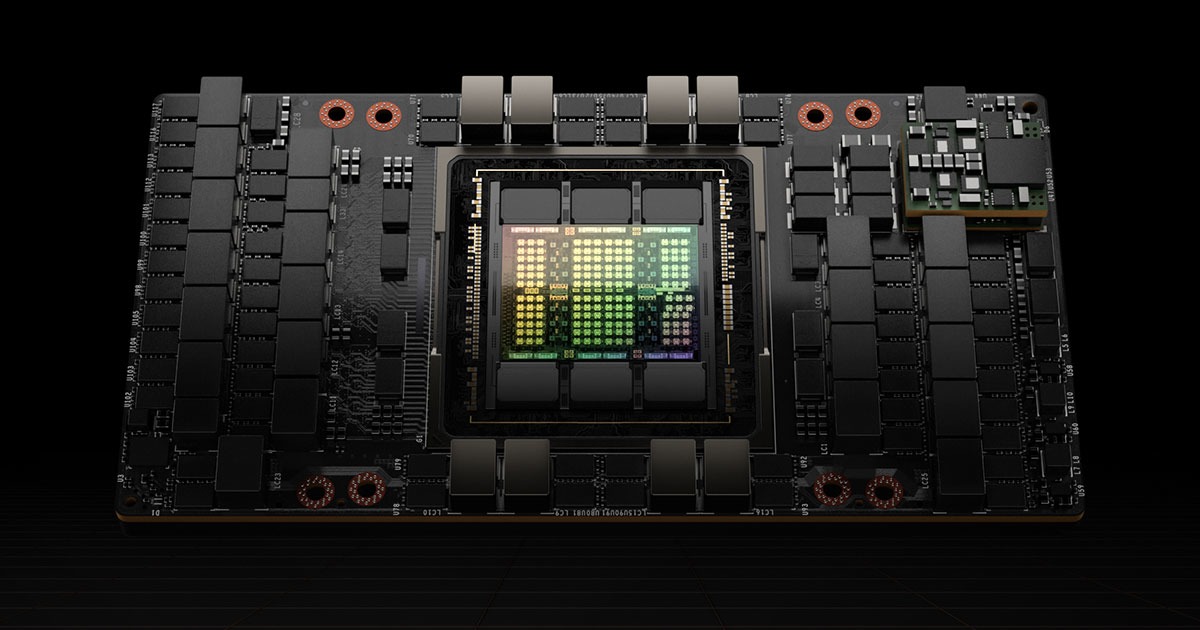
Offizielles Herstellerbild von NVIDIA
Überblick
Die NVIDIA H100 NVL ist ein von NVIDIA auf Basis der Hopper-Architektur entwickelter Datacenter-GPU im PCIe-Format, positioniert als Quasi-Flaggschiff für Szenarien mit großem Videospeicher und Inferenz. Eine einzelne Karte ist mit 94 GB HBM3 ausgestattet; über eine NVLink-Bridge lassen sich zwei Karten zu einem gemeinsamen Speicherpool von 188 GB verbinden, was sie für die Inferenz großer Sprachmodelle mit vielen Parametern geeignet macht. Die Karte ist als luftgekühltes Dual-Slot-Design ausgelegt, die TDP lässt sich in einem gewissen Rahmen konfigurieren, was den Einsatz in Standard-Rack-Umgebungen erleichtert. Zwischen den Karten stehen über NVLink 600 GB/s Interconnect-Bandbreite in beide Richtungen zur Verfügung, zusätzlich unterstützt die Karte PCIe Gen5 als Host-Interface. Im Lieferumfang enthalten ist das NVIDIA-AI-Enterprise-Softwarepaket, das Anforderungen an unternehmensgerechte KI-Inferenz und -Deployment abdeckt.
Kernspezifikationen
| Architektur | NVIDIA Hopper |
| Speicher | 94GB |
| Speichertyp | HBM3 |
| VRAM-Bandbreite | 3.9TB/s |
| FP64-Leistung | 30 teraFLOPs |
| FP64 Tensor Core | 60 teraFLOPs |
| FP32-Leistung | 60 teraFLOPs |
| FP8-Rechenleistung | 3,341 teraFLOPS |
| FP16-Leistung | 1,671 teraFLOPS |
| INT8-Leistung | 3,341 TOPS |
| TDP-Leistungsaufnahme | 350-400W (configurable) |
| Interconnect | NVIDIA NVLink: 600GB/s | PCIe Gen5: 128GB/s |
| Formfaktor | PCIe dual-slot air-cooled |
| MIG-Slicing | Up to 7 MIGS @ 12GB each |
| Codecs | 7 NVDEC | 7 JPEG |
Spezifikationen anhand offizieller Quellen verifiziert (
Offizielle Benchmarks , aktualisiert am 09.10.2026) · Der tatsächliche Preis richtet sich nach dem Angebot des Verkäufers
Einsatzszenarien
- Inferenzdienste für große Sprachmodelle (LLM): Mit 188 GB Speicher im NVLink-Bridgeduo finden die vollständigen Modellgewichte Platz und es bleibt Raum für KV-Cache
- GPU-Ressourcenaufteilung im Multi-Tenant-Betrieb: Per MIG lässt sich eine Karte in bis zu 7 Instanzen mit jeweils 12 GB Speicher unterteilen – ideal für kleine Inferenzmodelle oder die Isolation mehrerer Workloads
- Video- und Bildverarbeitungs-Pipelines: Mehrere integrierte NVDEC-Decoder und JPEG-Dekodiereinheiten machen die Karte geeignet für visuelle KI-Workloads mit gemischter Inferenz und Dekodierung
- Deployment unternehmensnaher KI-Plattformen: Mit der beiliegenden NVIDIA AI Enterprise erhält man einen unterstützten Enterprise-Softwarestack für Inferenz- und Fine-Tuning-Aufgaben in Produktionsumgebungen
Modelle der Familie
| Modell | Speicher | Verbrauch |
|---|
| NVIDIA T4 Vergleich | 16GB GDDR6 mit ECC (standardmäßig aktiviert) | 70W (Gesamtboardleistung, Standard) |
| NVIDIA A100 Vergleich | 40GB HBM2 / 80GB HBM2e in zwei Varianten (80-GB-Variante nachgelegt auf der SC20 am 16.11.2020), mit ECC | SXM4 400W (40GB/80GB identisch); PCIe-Version 40GB 250W / 80GB 300W |
| NVIDIA H20 Vergleich | 96GB HBM3 (konsistent bei Flopper/VipraTech/Tencent News) | 400W TDP (dreifach belegt: Flopper/VipraTech-Datenblatt/Tencent News mit „Wärmeleistung 400W“; widersprüchliche Angabe 350W im VipraTech-Fließtext verworfen) |
| NVIDIA GB300 Vergleich | 288GB HBM3e (pro GPU-Package; 576GB im Superchip; parallel HGX auf Board-Ebene 2,1 TB / Rack 20 TB) | TGP bis 1400W |
| NVIDIA A30 Vergleich | 24 GB HBM2 | 165 W |
| NVIDIA GeForce RTX 4090 Vergleich | 24GB GDDR6X | 450W TGP (Spiele im Schnitt 315W, empfohlenes Netzteil 850W) |
Videoerklärung VIDEO
Wichtige Punkte für Kauf und Prüfung
- Kompatibilität von Gehäuse und Netzteil prüfen: Die H100 NVL ist als luftgekühlte PCIe-Karte im Dual-Slot-Format ausgelegt, die TDP ist in gewissem Rahmen konfigurierbar. Vor dem Kauf sollten Slot-Höhe, Airflow-Design und die Stromreserve pro Karte im Server verifiziert werden. Die luftgekühlte Lösung stellt geringere Anforderungen an Kühlung und Geräuschmanagement im Rechenzentrum als flüssigkeitsgekühlte SXM-Varianten, benötigt aber auch unter Volllast ausreichend Frischluftzufuhr von vorne
- NVLink-Bridge-Konfiguration verifizieren: Ziel ist der Kauf als Dual-Karten-Setup mit 188 GB für Inferenz mit großem Speicher, muss geprüft werden, ob die NVLink-Bridge im Lieferumfang oder Zubehör enthalten ist und ob der Kartenabstand auf dem Mainboard die Montage der Bridge erlaubt; beim Betrieb mit nur einer Karte kann die Bridge entfallen
- Prüfpunkte bei Gebraucht- und Restposten-Käufen: Speicherkapazität (94 GB HBM3 pro Karte) und Seriennummer abgleichen, NVLink- und PCIe-Gen5-Link-Training testen, die MIG-Partitionierung auf Funktion prüfen und klären, wie die NVIDIA-AI-Enterprise-Lizenz mitgeliefert wird und wie viel Supportzeitraum noch verbleibt
FAQ
Was unterscheidet die H100 NVL von der regulären PCIe-Version der H100?
Die H100 NVL ist eine PCIe-Variante der H100; der wesentliche Unterschied liegt in der NVLink-Bridge-Fähigkeit, mit der sich zwei Karten zu einem gemeinsamen Speicherpool von 188 GB verbinden lassen – konzipiert für Inferenzszenarien, die einen großen Speicher über Karten hinweg erfordern. Die Standard-PCIe-Version bietet in der Regel ab Werk keine Bridge-Lösung. Beide basieren auf der Hopper-Architektur.
Reichen 94 GB pro Karte für große Modelle? Wann braucht man die Dual-Karten-Bridge?
Das hängt von der Parameterzahl des Modells und der gewählten Quantisierung ab. Reicht der Speicher einer einzelnen Karte nicht aus, um die Modellgewichte plus KV-Cache und weiteren Laufzeit-Overhead zu fassen, lassen sich zwei H100 NVL per NVLink zu 188 GB gemeinsamem Speicher verbinden. Der so gebildete Speicherpool wird über NVLink mit 600 GB/s angebunden – die Kommunikationseffizienz liegt damit deutlich über der von Multi-Karten-Setups über PCIe Gen5.
Eignet sich die H100 NVL für Vermietung oder Colocation? Wozu dient MIG?
Ja. Die Karte ist als Standard-PCIe-Dual-Slot-Karte luftgekühlt ausgelegt, und die konfigurierbare TDP erlaubt den Einsatz in gewöhnlichen Rack-Servern – die Colocation-Hürde ist relativ niedrig. Per MIG lässt sich eine Karte physisch in bis zu 7 voneinander isolierte Instanzen mit jeweils 12 GB Speicher unterteilen, was für Cloud-Provider oder Teams ideal ist, die eine Karte auf mehrere Mandanten oder mehrere leichte Inferenzaufgaben verteilen wollen.