
H200
概要OVERVIEW
H200(正式名称 NVIDIA H200、「Hopper」シリーズ所属)は NVIDIA が 2023年11月に発表し、2024年6月より出荷が始まったデータセンター向け GPU で、H100 のメモリ強化版にあたります。演算性能は H100 と同等ながら、1枚あたりのメモリ容量は倍増して 141GB HBM3e、帯域幅は 4.8TB/s[1]。
まで向上しました。位置づけは「大容量メモリでの推論とファインチューニング」を担う主力機種です。大規模モデル時代において、メモリ容量は搭載できるモデルの規模を左右します。H200 は H100 と同じ調達・運用エコシステムのまま、ほぼ倍のメモリ空間を提供します——これが今日まで世界の現物市場で量的主力であり続け、「価値の下がりにくい大容量メモリ」として知られる理由です。
中国大陸市場では、H200 は 2025年12月に中国市場向け特別仕様として承認され、2026年7月から本格供給が始まりました。流通価格は供給ペースに伴い大きく変動しています(「相場帯」と「沿革」参照)。
適用シーンFIT
AIXX Index(0–100):当ライブラリは公開スペックに基づく加重推定です——メモリ 40% + インターコネクト 30% + エコシステム 30%、用途に応じて重みを調整。90+ フラッグシップ級 · 75+ 優秀 · 60+ 実用圏 · 60 未満は不向き。算出方法は透明で検証可能ですが、性能の保証ではありません。
沿革HISTORY
2023年11月、NVIDIA が H200 を発表:H100 のメモリ強化版で、HBM3e 141GB・4.8TB/s。2024年半ばの出荷を予告[1]。
2024年6月より世界各国で順次出荷が始まり、急速に大規模モデルの推論・ファインチューニングにおける量的主力機種となりました。
2025年12月、H200 が中国市場向けに承認され、流通モジュール価格は約 140万元/モジュール(メディア報道ベース[2])。初回は数千セット規模。
2026年7月から中国市場への本格供給が始まると、H シリーズの価格は全体的に急落し、H200 は中国大陸の現物市場で最も供給が潤沢なフラッグシップ大容量メモリ機種となりました。
技術仕様SPECIFICATIONS
| 項目 | 仕様 |
|---|---|
| GPU コア | NVIDIA Hopper H200(SXM5) |
| 単体メモリ | 141GB HBM3e |
| メモリ帯域幅 | 4.8TB/s / 枚 |
| 演算性能 | H100 と同等(FP8 約ペタフロップス級、スパース時) |
| GPU間インターコネクト | NVLink 第4世代 · 900GB/s |
| ボード消費電力(TBP/TGP) | 最大 700W(設定可能) |
| 主流のサーバー形態 | HGX H200 8枚搭載ベースボード(空冷 / 液冷) |
| 前世代 / 対抗製品 | HGX H100 80GB / B300(288GB,Blackwell Ultra) |
仕様は NVIDIA 公開資料による[1]。サーバー構成は OEM やロットにより差異があります。
世代比較 · 3世代一望GENERATIONS
| 項目 | H100 80GB | H200 | B300 |
|---|---|---|---|
| 単体メモリ | 80GB HBM3 | 141GB HBM3e | 288GB HBM3e |
| メモリ帯域幅 | 3.35TB/s | 4.8TB/s | 約 8TB/s |
| 演算世代 | Hopper | Hopper(同演算性能) | Blackwell Ultra(FP4) |
| GPU間インターコネクト | NVLink 4 · 900GB/s | NVLink 4 · 900GB/s | NVLink 5 · 1.8TB/s |
| 選定を一言で | 予算最重視 · エコシステム最大 | 大容量メモリ · 量産主力 | フラッグシップ新規購入 · 次世代 |
仕様は NVIDIA 公式公開資料に準拠。B300 列の詳細は同機種項目の比較表を参照。
ファミリー構成FAMILY
HGX H200 ベースボード採用のシステムは複数の OEM から出荷されており、中国大陸の現物市場でよく見られるのは:
冷却と導入COOLING
H200 の主流は空冷 HGX 8 枚構成。700W 級 SXM5 の空冷タワー方式は成熟しており、既存のサーバールームでも導入可能。これが次世代の液冷フラッグシップと異なる最大の導入上の強みです。一部 OEM は液冷バリエーションを提供しており、多くは高密度カスタム案件で見られます。


モデル対応MODEL FIT
| モデル / シナリオ | メモリ必要量(FP8 概算) | H200 の導入 | AIXX Index |
|---|---|---|---|
| DeepSeek R1 フルスペック(671B) | 約 690GB | 8枚 1.128TB ならフル性能の単一ノード展開が可能で、余裕も適切 | 93 |
| R1-Distill 70B クラス | 約 70GB | シングルカード 141GB で展開可能、余裕は十分 | 95 |
| 72B クラスオープンソースモデル | 約 72GB | シングルカード展開、長コンテキストの余裕は大 | 95 |
| 動画生成モデル(10-20B 級) | 約 20-40GB | シングルカードで余裕、量産ラインに最適 | 80 |
メモリは FP8 ウェイト ≈ パラメータ数 × 1 バイトで概算。AIXX Index は本ライブラリの推算基準で、実測に応じて更新されます。
ギャラリーGALLERY


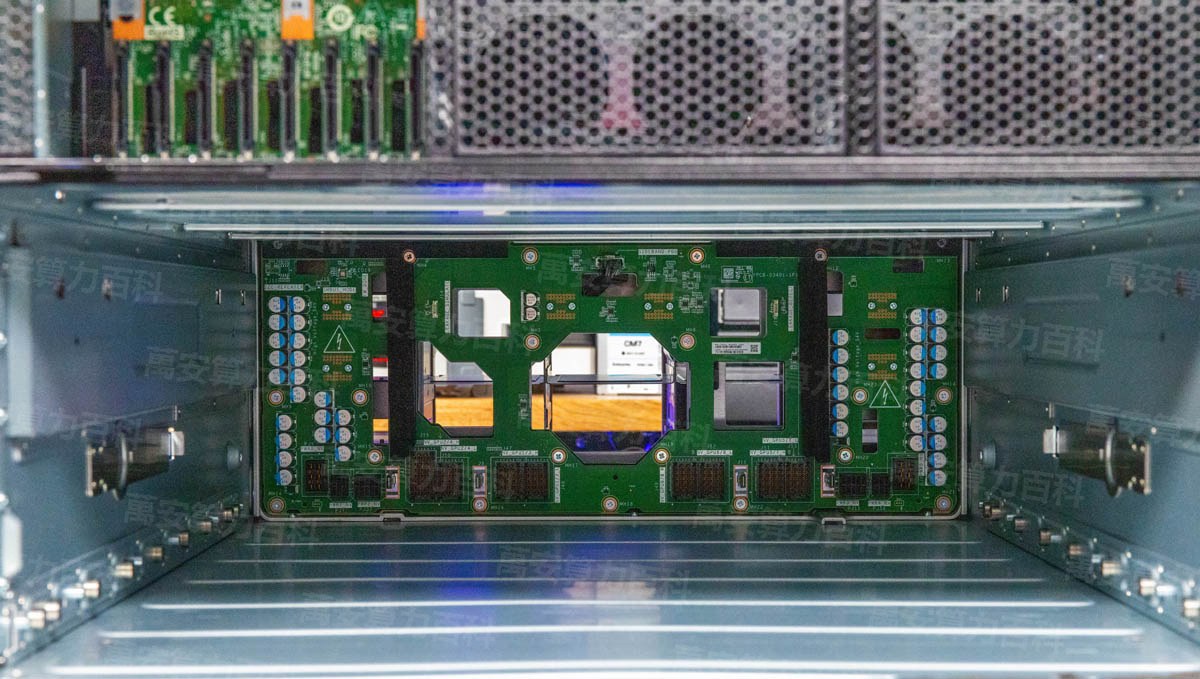
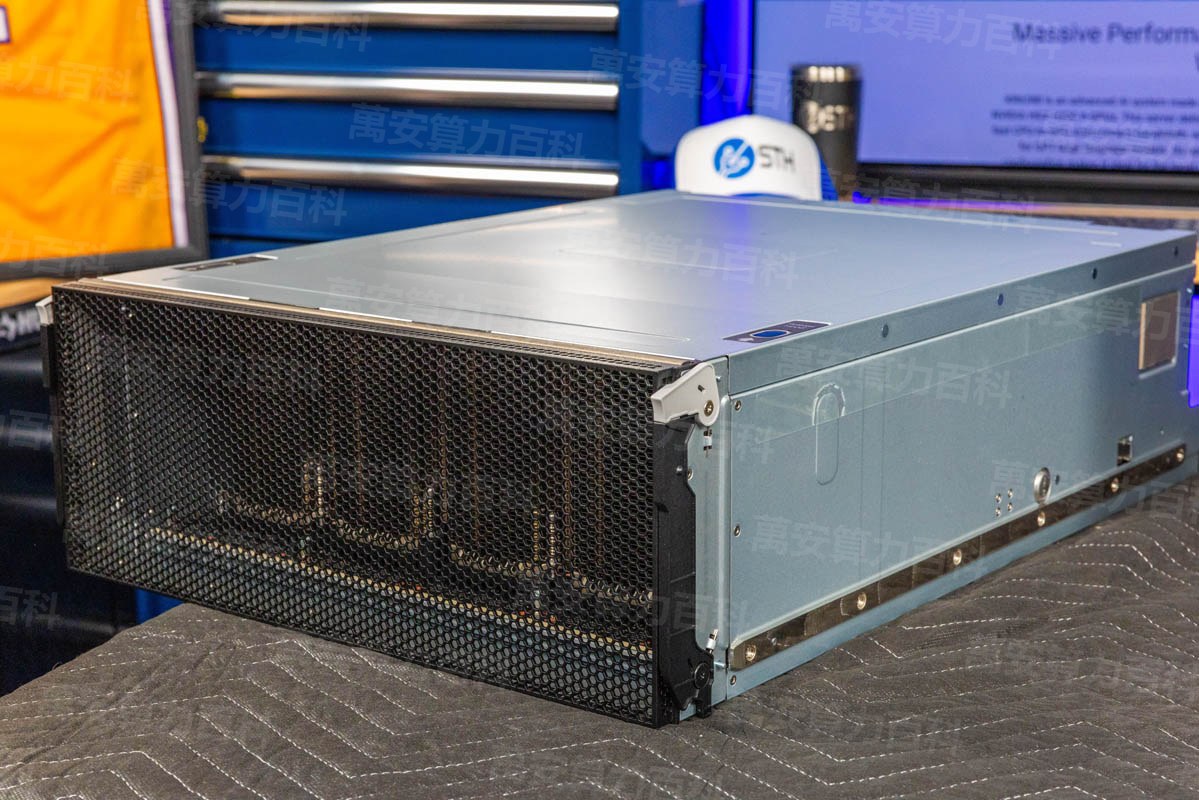
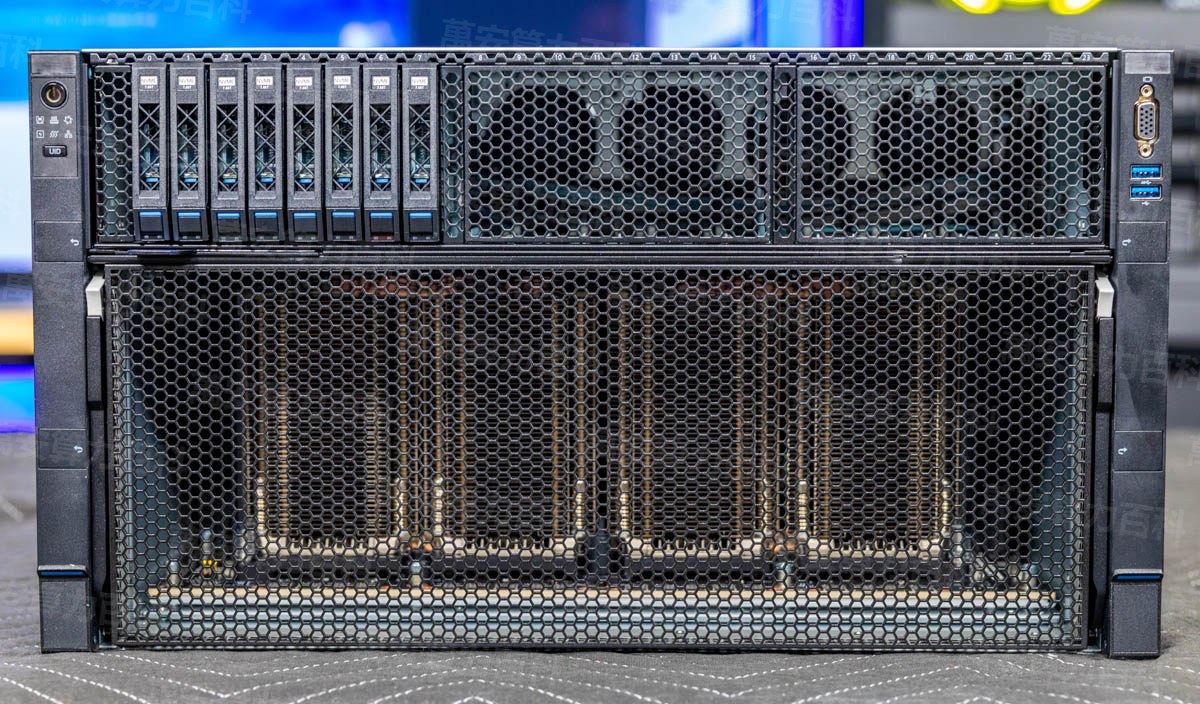
実写画像は検品ロットに合わせて順次追加;AI 生成画像は実写と偽らない。
動画解説VIDEO
コミュニティ実機 · 出典 YouTubeCOMMUNITY HANDS-ON
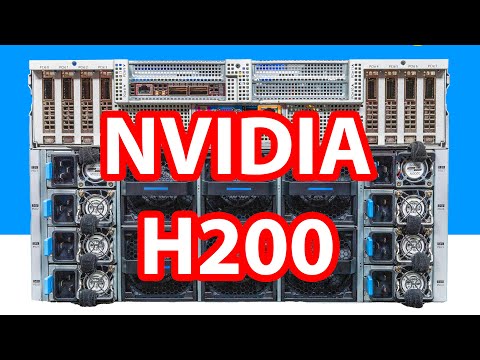
地域によっては直接再生できない場合があります
ソフトウェアとエコシステムECOSYSTEM
| 項目 | 要件 / 現状 |
|---|---|
| CUDA | 12.4 以上(Hopper 完全サポート) |
| ドライバー | 550 系以上 |
| 学習フレームワーク | PyTorch / TensorFlow は公式に Hopper をサポート |
| 推論エンジン | vLLM / SGLang / TensorRT-LLM いずれも対応済み |
| ネットワーク構成 | ConnectX-7 400G または同等のインターコネクトソリューション |
| OS | 主要Linuxディストリビューション(Ubuntu 22.04+ など) |
Hopper エコシステムは3年の蓄積を経て最も成熟。ソフトウェアスタックのバージョンは時期により変化するため、NVIDIA 公式リリースを基準としてください。
調達と検品PROCUREMENT
H200 購入時の検品ポイント(3項目):
完全な6項目ストレステストの判定基準(数値は H200 実測アンカー)は本機種項目を参照「ストレステストの方法」節を参照。
ストレステストの方法BENCH TEST
6項目ストレステスト基準、数値判定はすべて H200 実測アンカー:開梱認識 → シングルカード焼き込みテスト(700W 空冷タワー、85℃以下かつ ECC エラーなしで合格)→ システム全体フルロード → メモリ帯域幅(公称 4.8TB/s、85%以上で合格)→ インターコネクト帯域(nccl-tests 750GB/s 以上)→ 推理スループット(公開ベンチマークの80%以上)。
nvidia-smigpu-burn 3600 または dcgmi diag -r 3 · 30〜60分bandwidthTest(CUDA同梱サンプル)nccl-tests all_reduce ベンチマークvLLM 実モデルを起動して負荷計測基準の説明:合格/優秀ラインは当ライブラリが技術上の一般的基準に基づき整理したもの(帯域は公称値に対する比率、温度はデータセンターの一般的上限)。検品報告書の実測データの蓄積に応じて段階的に校正する。本表はいかなる検収の約束を構成するものではなく、詳細は契約の取り決めによる。当ライブラリの検品報告書の実測項目は本表の基準に従って記録される——NOT_EXECUTED は未実施を意味し、「未測定」そのものも重要な情報である。
輸送と納品LOGISTICS
OEM とバリエーションVENDORS
同一の HGX H200 ベースボードでも、各社のシステムは形状・冷却・サービスが異なります——選定はまず違いを確認:
| 一体機メーカー | 代表形態 | 差別化ポイント | 向いているケース |
|---|---|---|---|
| Supermicro 超微 | SYS-821GE-TNHR(8U 空冷) | 量的主力機種、出荷量と流通網が最も広い | 現調達 · コスパ重視 |
| Dell Dell | PowerEdge 系(HGX H200 8) | 世界的トップティアのサービス網とエンタープライズ級サポート | 越境展開 · サービス重視 |
| Gigabyte 技嘉 | HGX H200 8 システム | 構成の柔軟性が高く、アジア太平洋チャネルに強い | アジア太平洋チャネルでの調達 |
| Aivres | KR6288(8U 空冷) | 専門メディアによる完全レビューがあり、透明性が高い | 公開レビューを確認してから決定したい場合 |
| AMAX などのインテグレーター | 統合プラットフォーム(大学クラスタの事例など) | プロジェクト型の統合納品 | 大量案件 · 入札シーン |
AIXX Index · デプロイ四軸比較AIXX INDEX
| 一体機メーカー | 導入の容易さ | 保守のしやすさ | 性能密度 | 寿命見込み |
|---|---|---|---|---|
| Supermicro 超微 | 90 | 85 | 84 | 82 |
| Dell Dell | 90 | 92 | 84 | 85 |
| Gigabyte 技嘉 | 85 | 80 | 86 | 80 |
| Aivres | 86 | 80 | 85 | 81 |
| AMAX などのインテグレーター | 82 | 80 | 84 | 82 |
AIXX Index は本ライブラリの推定値(0–100、推定根拠=公開されているフォームファクタ・冷却方式・サービス網の差異)で、実機検証に伴い更新されます。調達の約束を構成するものではありません。具体的な型番はメーカー公式発表に依拠します。
用語カードGLOSSARY
HBM3e メモリ
GPU の脇に積まれる高帯域メモリ。H200 は1枚あたり 141GB HBM3e・帯域 4.8TB/s——メモリは世代の中核価値です。
NVLink インターコネクト
第4世代 NVLink。カード間 900GB/s の直接インターコネクトにより、8基の GPU が一つの GPU のように協調動作します。
SXM5 基板直載せ実装
GPU は基板に直接実装(カード差し替え方式ではない)。HGX H200 8枚ベースボードが SXM5 形態。検品時は基板ごと確認が必要です。
FP8 精度
8ビット浮動小数点フォーマット。推論の主流精度。メモリ使用量の概算:FP8 ウェイト ≈ パラメータ数 × 1 バイト。
中国市場適合ロット
H200 は2025年12月に中国市場向けに承認。ロット・通関経路・適合状態は保証と価値維持に直結するため、検品時の必須確認事項です。
限界と論点LIMITS
- 世代の狭間:上は B300(288GB HBM3e + FP4)に及ばず、下は H100 の値下がりに圧迫される——「H200 は H100 のメモリ交換にすぎない」という批判と「H200 を買うことはメモリを買うこと」という擁護が併存しており、本ライブラリは優劣を断定しません。
- 中国市場供給政策リスク:承認・本格供給・その後の割当てはいずれも政策のペースに伴い変動し、流通価格はそれに応じて大きく上下します——H200 を保有する上での最大の外部リスク要因です。
- リフレッシュ・改造リスク:H100 を改造して H200 と偽る事例が現物市場で確認されています(検品機関の通報ベース)。シリアル番号とメモリの実測は必須の手続きです。
- 計算世代をめぐる論争:演算性能は H100 と同等のため、業務のボトルネックがメモリではなく演算にある場合、H200 のコスパ優位は大きく縮小します——選定前に自分のボトルネックがメモリにあるかを確認してください。
相場帯MARKET DATA
| 日付 | 基準 | 地域 | 参考価格帯 | 備考 |
|---|---|---|---|---|
| 2026-10-20 | マーケットリアルタイム | 米国(USD) | $209万 – 226万 | 4件の报价 ›(ロット全体の提示価格ベース) |
| 2026-10-20 | マーケットリアルタイム | 中国本土 | ¥5,850,179万 – 7,007,409万 | 3件の报价 ›(ロット全体の提示価格ベース) |
| 2025-12 | 中国市場流通の参考 | 中国本土 | 約 ¥140万 / モジュール | メディア報道ベース[2] · 中国大陸で販売中 › |
| 2025-09 | 調達事例 | 中国本土 | 一括 263.9万 | 西安交通大学の AMAX H200 プラットフォーム(公開落札情報) |
| 2024-06 | 海外アンカー価格 | 北米 | $172,643 から / カードボード | 流通の公開表示価格(ベアボーン基準) |
算定基準:3地域すべて8基搭載1台構成の統一条件で直接比較可能——中国大陸は2025年12月の対中輸出承認当初からの推算(承認直後は供給不足によるプレミアムが高く、2026年7月の供給増以降は低下、2026年10月時点の在庫実勢にアンカー設定 585〜700万元/台、3台);北米は出荷開始時点からのチャネル定価の緩やかな上昇を遡及計算(2026年10月時点の在庫にアンカー設定 $209.5〜226.8万元/台、4台、チャート内は人民元換算の同一軸);欧州は在庫整机の提示価格にアンカー設定(€318.9万元/台、Dell HGX H200)。その他の市場は当データベースの在庫スナップショット蓄積に伴い順次公開予定。当データベースの価格データ出典:AIXX 取引所(手数料ゼロのマッチング、取引には関与せず、成約価格も把握・推測しないため、データは中立です)。推定帯は推移の参考にのみ供し、実際の価格は出品者の提示価格によります。
価格イベント年表MILESTONES
よくある質問FAQ
演算性能は同等、メモリ容量が倍増:80GB→141GB HBM3e、帯域3.35→4.8TB/s。一言でいえば、H200はH100と同じエコシステムのまま、ほぼ倍のメモリを手に入れたモデルです。
動かせます。R1フルスペック版のFP8ウェイトは約690GBで、H200の8基搭載機は総メモリ1.128TBにより、1台でのフルスペック展開が可能です(十分な余裕あり、詳細は「モデル適合」参照)。
ボトルネックがメモリ容量にあり、予算がシビアならH200。FP4演算性能と次世代インターコネクトが必要ならB300。両者は1世代差で、価格差も桁違いです——まず自分のボトルネックを確認してください(B300エントリとの比較参照)。
供給は対中政策の動向に左右されます:承認→供給増→割当調整と、各段階でチャネル価格が直接書き換わります(「沿革」および年表参照)。当データベースは日々データを記録し、主観的な評価は行いません。
あります。H100を改造してH200と偽る品が現物市場で確認されています。シリアル番号による個別真贋確認+メモリ実測は必須の手順です(「調達と検品」参照)。
関連項目SEE ALSO
機種比較と選定COMPARE
参考文献REFERENCES
- NVIDIA公式サイト — H200製品ページ https://www.nvidia.com/en-us/data-center/h200/
- H200の対中チャネルモジュール価格 約140万元/モジュール(2025-12-24)
- マーケット帯データ — AIXX Exchange(当プラットフォームの販売中の提示価格とチャネル把握区間、毎日更新) /hall.html