AIXX Pedia › Modelleintrag › H200

H200
Überblick OVERVIEW
H200 (vollständiger Name NVIDIA H200, Teil der „Hopper“-Serie) ist ein von NVIDIA am November 2023 vorgestellter und ab Juni 2024 ausgelieferter Datacenter-GPU und die VRAM-erweiterte Version des H100: Die Rechenleistung entspricht dem H100, der VRAM pro Karte verdoppelt sich auf 141GB HBM3e , die Bandbreite steigt auf 4.8TB/s[1]。
Es positioniert sich als Arbeitstier für „Inferenz und Fine-Tuning mit großem VRAM“: Im Zeitalter der großen Modelle bestimmt die VRAM-Kapazität, wie groß ein Modell sein darf – der H200 bietet mit dem Beschaffungs- und Betriebsökosystem des H100 nahezu die doppelte VRAM-Kapazität. Genau deshalb ist er bis heute der Volumen-Favorit auf dem globalen Spotmarkt und für seinen „wertstabilen großen VRAM“ bekannt.
Auf dem chinesischen Festlandmarkt wurde der H200 im Dezember 2025 für China zugelassen und wird seit Juli 2026 in größeren Mengen ausgeliefert; die Kanalpreise schwanken stark mit dem Lieferumfang (siehe „Marktband“ und „Historie“).
Einsatzszenarien FIT
AIXX Index (0–100): Die Datenbank gewichtet öffentliche Spezifikationen – Speicher 40 % + Interconnect 30 % + Ökosystem 30 %, je nach Szenario angepasst. 90+ Flaggschiff · 75+ Ausgezeichnet · 60+ brauchbar · unter 60 ungeeignet. Methodik transparent und überprüfbar, keine Leistungszusage.
Historie HISTORY
November 2023 , veröffentlichte NVIDIA den H200: das VRAM-Upgrade des H100 mit HBM3e 141 GB und 4,8 TB/s, Auslieferung ab Mitte 2024 angekündigt[1]。
Juni 2024 begann die weltweite Auslieferung; schnell wurde er zur Volumen-Hauptkraft für LLM-Inferenz und Fine-Tuning.
Im Dezember 2025 erhielt der H200 die Zulassung für China; der Modulpreis im Kanal lag bei etwa 1,4 Mio. RMB pro Modul (laut Medienberichten[2]), erste Charge im vierstelligen Modulbereich.
Ab Juli 2026 rollte die Auslieferung nach China an; die H-Serie verlor insgesamt stark an Preis, und der H200 wurde zur am besten verfügbaren Flaggschiff-Karte mit großem VRAM auf dem Spotmarkt des Festlands.
Technische Daten SPECIFICATIONS
| Position | Spezifikation |
|---|---|
| GPU-Chip | NVIDIA Hopper H200(SXM5) |
| Speicher pro Karte | 141GB HBM3e |
| VRAM-Bandbreite | 4,8 TB/s pro Karte |
| Rechenleistung | auf H100-Niveau (FP8 im Petabit-Bereich, mit Sparsity) |
| GPU-zu-GPU-Interconnect | NVLink der vierten Generation · 900 GB/s |
| Board-Power (TBP/TGP) | bis zu 700 W (konfigurierbar) |
| Übliche Systemformen | HGX H200 8-Karten-Baseboard (luftgekühlt / flüssigkeitsgekühlt) |
| Vorgänger / Vergleichsprodukt | HGX H100 80GB / B300(288GB,Blackwell Ultra) |
Spezifikationen gemäß offiziellen NVIDIA-Angaben[1]; Systemkonfigurationen variieren je nach OEM und Charge.
Generationenvergleich · drei Generationen im Überblick GENERATIONS
| Position | H100 80GB | H200 | B300 |
|---|---|---|---|
| Speicher pro Karte | 80GB HBM3 | 141GB HBM3e | 288GB HBM3e |
| VRAM-Bandbreite | 3.35TB/s | 4.8TB/s | ca. 8 TB/s |
| Rechenleistungsgeneration | Hopper | Hopper (gleiche Rechenleistung) | Blackwell Ultra(FP4) |
| GPU-zu-GPU-Interconnect | NVLink 4 · 900GB/s | NVLink 4 · 900GB/s | NVLink 5 · 1.8TB/s |
| Auswahl in einem Satz | Budgetknapp · größtes Ökosystem | Großer VRAM · Volumen-Favorit | Flaggschiff-Neukauf · nächste Generation |
Spezifikationen gemäß offiziellen NVIDIA-Veröffentlichungen; die B300-Spalte siehe im zugehörigen Modelleintrag.
Familienmitglieder FAMILY
Komplettsysteme auf Basis des HGX-H200-Baseboards kommen von mehreren OEMs; auf dem Festland-Spotmarkt häufig:
Kühlung und Deployment COOLING
Der H200 ist überwiegend als luftgekühltes HGX-8-Karten-System im Einsatz: Der Kühlkörper-Lösungsansatz für die 700-W-Klasse mit SXM5 ist ausgereift, Bestandsrechenzentren können ihn ohne Umbau aufnehmen – das ist der größte Deployment-Vorteil gegenüber dem flüssigkeitsgekühlten Flaggschiff der nächsten Generation. Einige OEMs bieten flüssigkeitsgekühlte Varianten an, meist für High-Density-Sonderprojekte.


Modellkompatibilität MODEL FIT
| Modell / Szenario | VRAM-Bedarf (FP8-Schätzung) | Deployment auf H200 | AIXX Index |
|---|---|---|---|
| DeepSeek R1 Vollversion (671B) | ca. 690 GB | 8 Karten mit 1,128 TB erlauben ein Volllast-Single-Node-Deployment mit vernünftigem Spielraum | 93 |
| R1-Distill 70B-Klasse | ca. 70 GB | auf einer 141-GB-Karte deploybar, reichlich Reserve | 95 |
| 72B-Klasse-Open-Source-Modelle | ca. 72 GB | Single-GPU-Deployment, großer Spielraum für lange Kontexte | 95 |
| Videogenerierungsmodelle (10-20B-Klasse) | ca. 20-40 GB | Single GPU problemlos, ideal für Batch-Pipelines | 80 |
VRAM geschätzt mit FP8-Gewichten ≈ Parameteranzahl × 1 Byte; der AIXX Index folgt der Schätzweise dieser Datenbank und wird mit Messdaten aktualisiert.
Bildergalerie GALLERY


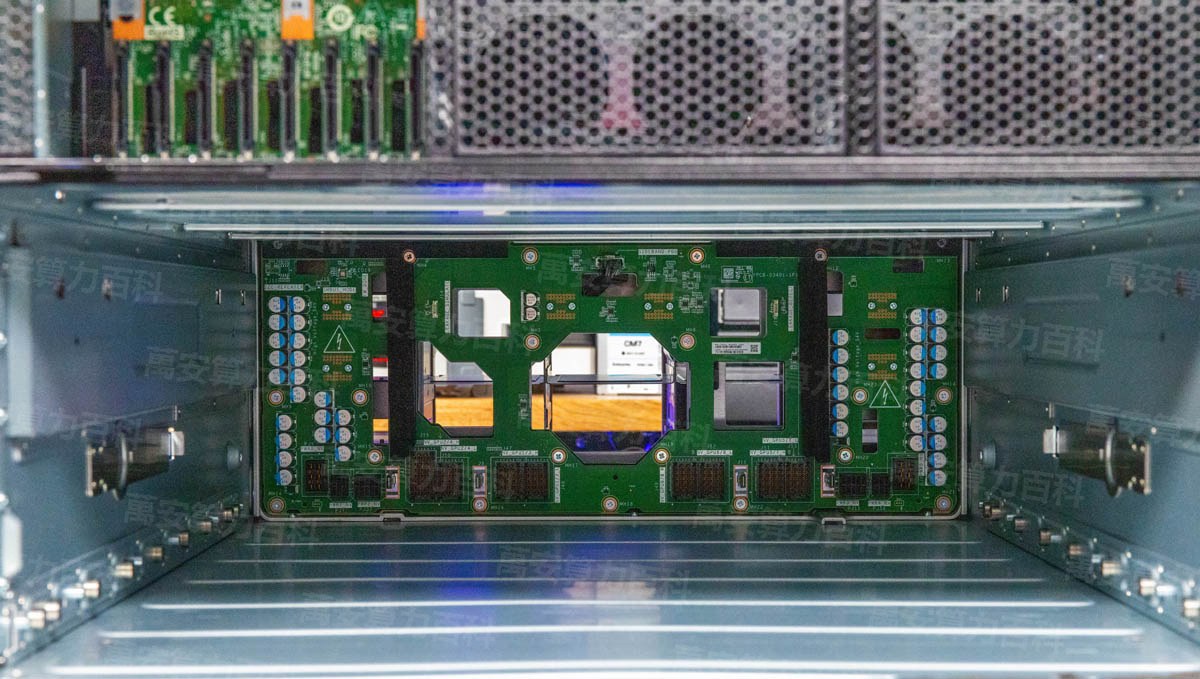
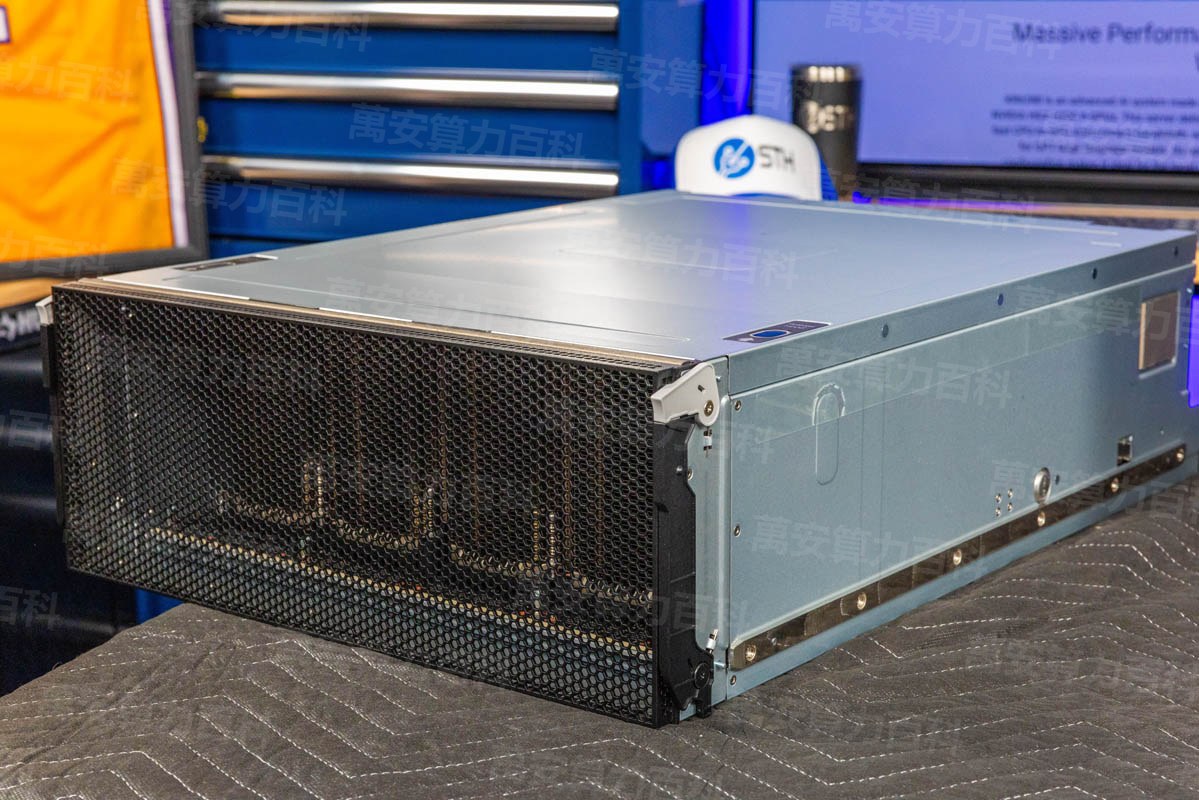
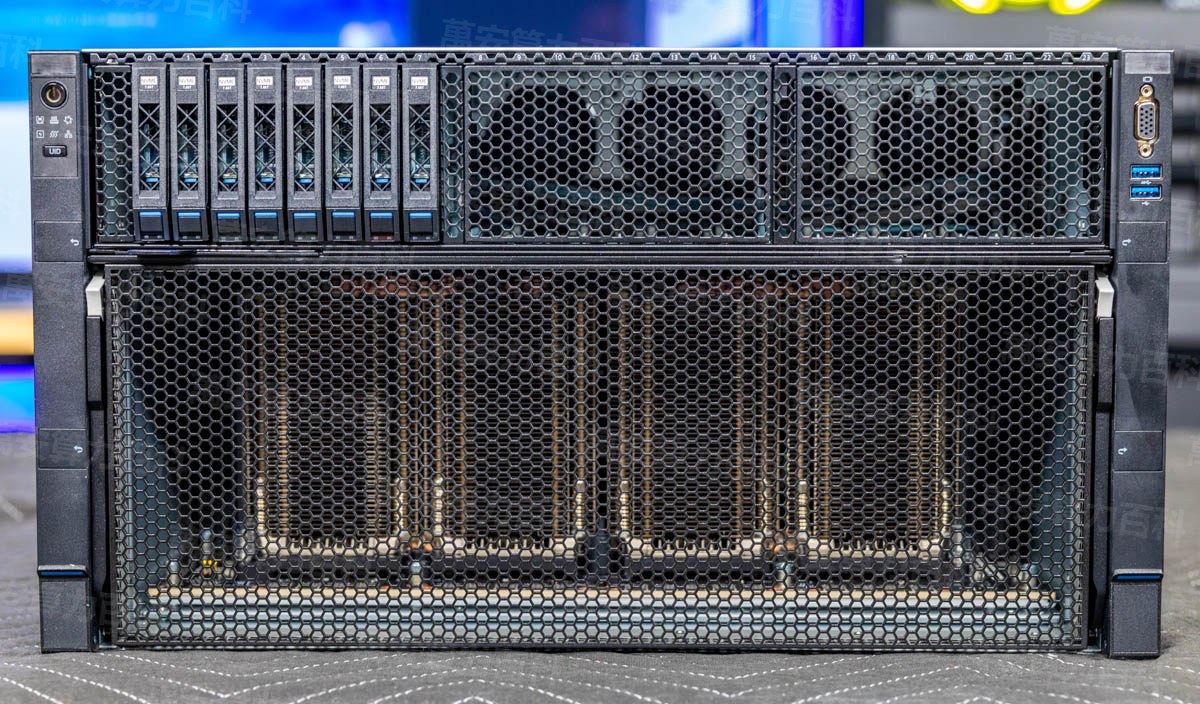
Originalfotos werden laufend mit jeder Prüflieferung ergänzt; KI-generierte Bilder werden nicht als Originale ausgegeben.
Videoerklärung VIDEO
Community-Hardware · Quelle: YouTube COMMUNITY HANDS-ON
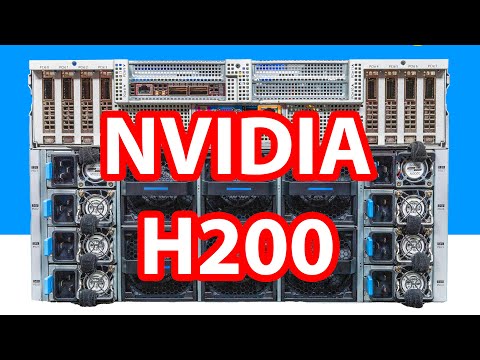
In einigen Regionen ist die Wiedergabe ggf. nicht möglich
Software & Ökosystem ECOSYSTEM
| Position | Anforderung / Status |
|---|---|
| CUDA | 12.4 oder höher (vollständige Hopper-Unterstützung) |
| Treiber | 550-Serie oder höher |
| Trainings-Frameworks | PyTorch / TensorFlow unterstützen Hopper offiziell |
| Inferenz-Engines | vLLM / SGLang / TensorRT-LLM sind alle angepasst |
| Netzwerkausstattung | ConnectX-7 400G oder gleichwertige Interconnect-Lösung |
| Betriebssystem | Gängige Linux-Distributionen (Ubuntu 22.04+ etc.) |
Das Hopper-Ökosystem ist nach drei Jahren am ausgereiftesten; die Software-Stack-Versionen entwickeln sich weiter, maßgeblich sind die offiziellen NVIDIA-Veröffentlichungen.
Beschaffung und Warenprüfung PROCUREMENT
Warenprüfung beim H200-Kauf (drei Punkte):
Die vollständigen sechs Burn-in-Test-Urteile (Werte auf H200-Basis) finden Sie im Abschnitt „Burn-in-Test“ dieses Eintrags.
Stresstests BENCH TEST
Sechs Prüfungen nach diesem Standard, alle Urteilswerte auf H200-Basis: Auspacken und Identifikation → Einzelkarten-Burn-in-Test (700-W-luftgekühlter Kühlkörper, ≤85 °C ohne ECC-Fehler = Bestanden) → Volllast des Gesamtsystems → VRAM-Bandbreite (nominal 4,8 TB/s, ≥85 % = Bestanden) → Interconnect-Bandbreite (nccl-tests ≥750 GB/s) → Inferenz-Durchsatz (≥80 % der öffentlichen Benchmarks).
nvidia-smigpu-burn 3600 oder dcgmi diag -r 3 · 30–60 MinutenbandwidthTest(CUDA-Musterbeispiele)nccl-tests all_reduce-BenchmarkvLLM Echtes Modell unter Last fahrenMethodik-Hinweis: Die Grenzwerte für „Bestanden“/„Ausgezeichnet“ wurden in dieser Bibliothek nach gängigen Ingenieursstandards zusammengestellt (Bandbreite als Anteil des Nennwerts, Temperatur nach branchenüblichen Datacenter-Limits) und werden mit zunehmenden Prübericht-Messdaten schrittweise kalibriert; diese Tabelle stellt keinerlei Abnahmeverprechen dar, maßgeblich sind die vertraglichen Vereinbarungen. Die Messpunkte der Prüfberichte dieser Bibliothek werden nach genau dieser Tabelle erfasst – NOT_EXECUTED bedeutet: Punkt nicht geprüft. Auch das „nicht getestet“ ist eine wichtige Information.
Versand & Auslieferung LOGISTICS
OEM & Varianten VENDORS
Auf demselben HGX-H200-Baseboard unterscheiden sich die Systeme der Hersteller in Formfaktor, Kühlung und Service – die Auswahl beginnt mit den Unterschieden:
| Systemhersteller | Typischer Formfaktor | Unterscheidungsmerkmale | Für wen geeignet |
|---|---|---|---|
| Supermicro | SYS-821GE-TNHR (8U luftgekühlt) | Volumen-Favorit, breiteste Verfügbarkeit und Vertriebskanäle | Spotkauf · Blick aufs Preis-Leistungs-Verhältnis |
| Dell | PowerEdge-Serie (HGX H200 8) | Globales Service-First-Level-Netzwerk mit Enterprise-Support | Grenzüberschreitende Deployments · Serviceorientiert |
| Gigabyte | HGX H200 8-GPU-Komplettsystem | Flexible Konfiguration, starke APAC-Vertriebskanäle | Beschaffung über APAC-Kanäle |
| Aivres | KR6288(8U, luftgekühlt) | Vollständige Tests durch Fachmedien, hohe Transparenz | Erst öffentliche Tests lesen, dann entscheiden |
| Integratoren wie AMAX | Integrierte Plattformen (z. B. Hochschulcluster) | Projektbasierte Integrationslieferung | Großprojekte · Ausschreibungen |
AIXX Index · Vierdimensionaler Deployment-Vergleich AIXX INDEX
| Systemhersteller | Einfache Installation | Wartungsfreundlichkeit | Leistungsdichte | Lebensdauererwartung |
|---|---|---|---|---|
| Supermicro | 90 | 85 | 84 | 82 |
| Dell | 90 | 92 | 84 | 85 |
| Gigabyte | 85 | 80 | 86 | 80 |
| Aivres | 86 | 80 | 85 | 81 |
| Integratoren wie AMAX | 82 | 80 | 84 | 82 |
Der AIXX Index ist eine Schätzgröße dieser Datenbank (0–100, Grundlage der Schätzung: öffentliche Formfaktoren, Kühllösung und Unterschiede im Servicenetzwerk) und wird mit verifizierten Praxistests aktualisiert; er stellt keine Kaufzusicherung dar. Maßgeblich sind die offiziellen Angaben des Herstellers zum jeweiligen Modell.
Glossarkarten GLOSSARY
HBM3e-Speicher
Hochbandbreit-Hauptspeicher, direkt neben der GPU verbaut. Das H200 bietet pro Karte 141 GB HBM3e bei 4,8 TB/s Bandbreite – der Speicher ist der Kernwert dieser Generation.
NVLink-Interconnect
NVLink der vierten Generation mit 900 GB/s direkter Karten-zu-Karten-Verbindung, die acht GPUs wie einen einzigen Verbund arbeiten lässt.
SXM5-Onboard-Bauform
Die GPUs sind direkt auf dem Substrat verlötet (keine Steckkarten); das HGX-H200-8-Karten-Substrat ist in SXM5-Bauform ausgeführt. Bei der Warenprüfung muss das Substrat mit geprüft werden.
FP8-Präzision
8-Bit-Fließkommaformat, der Standard für Inferenz. Grobe Abschätzung des Speicherbedarfs: FP8-Gewichte ≈ Parameterzahl × 1 Byte.
Exportkonforme Chargen für den chinesischen Markt
Das H200 wurde im Dezember 2025 für den chinesischen Markt freigegeben; Charge, Zollweg und Compliance-Status wirken sich direkt auf Garantie und Werterhalt aus und sind bei der Warenprüfung zwingend zu kontrollieren.
Grenzen & Kontroversen LIMITS
- Generationenzwiespalt : In der Leistung von oben durch das B300 (288 GB HBM3e + FP4) überholt, von unten durch Preisnachlässe beim H100 unter Druck – die Kritik, das H200 sei nur ein H100 mit anderem Speicher, steht gleichberechtigt neben der Verteidigung, wer ein H200 kaufe, kaue Speicher. Diese Datenbank nimmt keine Wertung vor.
- Risiko der Exportpolitik für den chinesischen Markt : Freigabe, Verfügbarkeit und spätere Quoten schwanken mit dem politischen Takt, weshalb Kanalpreise stark ausschlagen – dies ist die größte externe Risikogröße beim Halten eines H200.
- Risiko von Refurbishing und Umbauten : Aus H100 umgebaute Geräte, die als H200 deklariert werden, sind bereits im Spot-Market aufgetaucht (Lagebild von Prüfinstituten). Seriennummernprüfung und gemessener Speicherausbau sind Pflicht.
- Kontroversen um die Rechenleistung der Generation : Die Rechenleistung entspricht dem H100. Liegt der Engpass im Workload bei der Compute- statt der Speicherleistung, schrumpft der Preisvorteil des H200 deutlich – vor der Auswahl sollte der eigene Engpass beim Speicher liegen.
Marktlage MARKET DATA
| Datum | Kategorie | Region | Referenzpreisspanne | Anmerkung |
|---|---|---|---|---|
| 2026-10-20 | Marktplatz in Echtzeit | USA (USD) | 2,09–2,26 Mio. $ | 4 Angebote › (Gebotsgröße je Komplettlós) |
| 2026-10-20 | Marktplatz in Echtzeit | Festlandchina | 5.850,179–7.007,409 Mio. ¥ | 3 Angebote › (Gebotsgröße je Komplettlós) |
| 2025-12 | Referenz Kanal chinesischer Markt | Festlandchina | ca. 1,4 Mio. ¥ / Modul | Medienberichte als Grundlage[2] · In Festlandchina erhältlich › |
| 2025-09 | Beschaffungsfall | Festlandchina | Charge 2,639 Mio. ¥ | AMAX-H200-Plattform der Xi'an Jiaotong-Universität(öffentliches Ausschreibungsergebnis) |
| 2024-06 | Internationaler Ankerpreis | Nordamerika | ab 172.643 $ / Karte | Öffentlicher Kanallistenpreis(nacktes System) |
Grundlage: Alle drei Regionen beziehen sich auf 8-GPU-Komplettsysteme und sind direkt vergleichbar —— abgeleitet ab der Freigabe für Festlandchina im Dezember 2025(zu Beginn hohe Knappheitsprämie, Rückgang nach Mengenausweitung im Juli 2026, am Stichtag Oktober 2026 tatsächlich im Handel: 5,85–7,0 Mio. ¥ / System , 3 Systeme);Nordamerika: zurückgerechneter, seit Auslieferung langsam steigender Kanallistenpreis für Komplettsysteme(am Stichtag Oktober 2026 im Handel: 2,095–2,268 Mio. $ / System , 4 Systeme, in der Grafik in CNY auf derselben Achse umgerechnet);Europa: vorhandene Komplettsystem-Angebote( 3,189 Mio. € / System , Dell HGX H200). Weitere Märkte folgen automatisch mit dem Anwachsen der Angebotsdaten dieser Datenbank. Preisdatenquelle: AIXX Börse (provisionsfreie Vermittlung, keine Beteiligung an Transaktionen; Abschlusspreise werden weder erfasst noch geschätzt – daher neutral.)Das Projektionsband dient nur der Trendorientierung; der tatsächliche Preis richtet sich nach dem Angebot des Verkäufers.
Wichtige Preisereignisse MILESTONES
FAQ FAQ
Gleichbleibende Rechenleistung, verdoppelter Speicher: 80 GB→141 GB HBM3e, Bandbreite 3,35→4,8 TB/s. Kurz gesagt: Das H200 bietet mit dem H100-Ökosystem nahezu die doppelte Speicherkapazität.
Ja. Die FP8-Gewichte der R1-Vollversion umfassen rund 690 GB; ein 8-GPU-H200-System mit 1,128 TB Gesamtspeicher kann das Modell auf einer Maschine in voller Größe betreiben, mit vernünftigem Spielraum(siehe „Modellkompatibilität“).
Engpass bei Speicherkapazität, budgetempfindlich: H200. FP4-Rechenleistung und Interconnect der nächsten Generation: B300. Zwischen beiden liegt eine Generation – und der Preisabstand ebenfalls eine Größenordnung. Zuerst den eigenen Engpass klären(siehe Vergleichseintrag B300).
Das Angebot folgt dem Takt der Exportpolitik: Freigabe→Mengenausweitung→Quotenanpassung; jede Runde schreibt die Kanalpreise neu(siehe „Zeitlinie“ und Chronik). Diese Datenbank erfasst die Daten täglich, ohne Wertung.
Ja. Aus H100 umgebaute Geräte, die als H200 deklariert werden, sind bereits im Spot-Market aufgetaucht. Unabhängige Seriennummernverifikation plus gemessener Speicherausbau sind Pflicht(siehe „Beschaffung und Warenprüfung“).
Verwandte Einträge SEE ALSO
Modellvergleich und Auswahl COMPARE
Quellen REFERENCES
- NVIDIA-Website – H200-Produktseite https://www.nvidia.com/en-us/data-center/h200/
- H200-Kanalpreis für China ca. 1,4 Mio. ¥ pro Modul(24.12.2025)
- Marktdatenband – AIXX Börse (Angebote dieser Plattform und Händlerspannen, täglich aktualisiert) /hall.html