AIXX Pedia › Ficha de modelo › B300

B300
Visão geral OVERVIEW
B300 (nome completo NVIDIA B300, pertence à série「Blackwell Ultra」) é a GPU de data center[1]lançada pela NVIDIA em 2025, uma versão aprimorada do B200 de 2024. Memória de vídeo por placa 288GB HBM3e mais de três vezes superior à geração anterior H100 (80GB), potência de inferência FP4 de aproximadamente 1.1 PFLOPS (densa), consumo da placa (TBP/TGP) 1100W[1]。
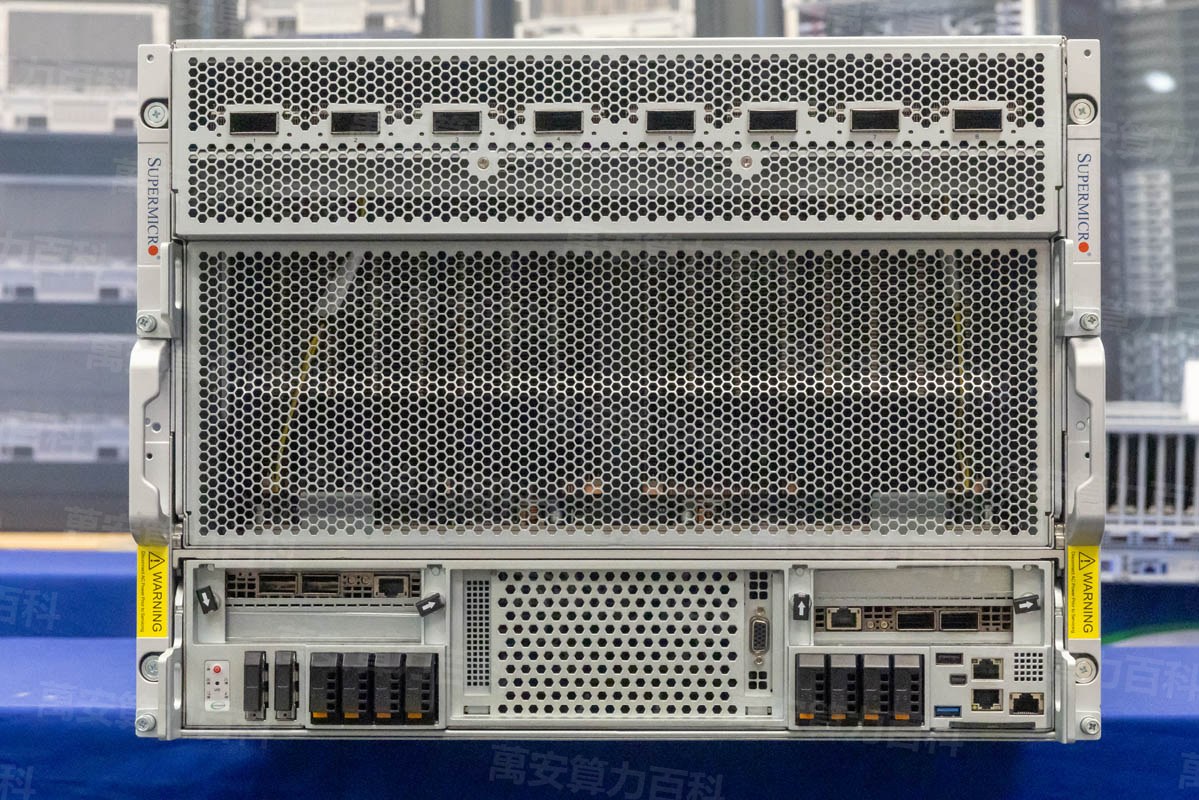
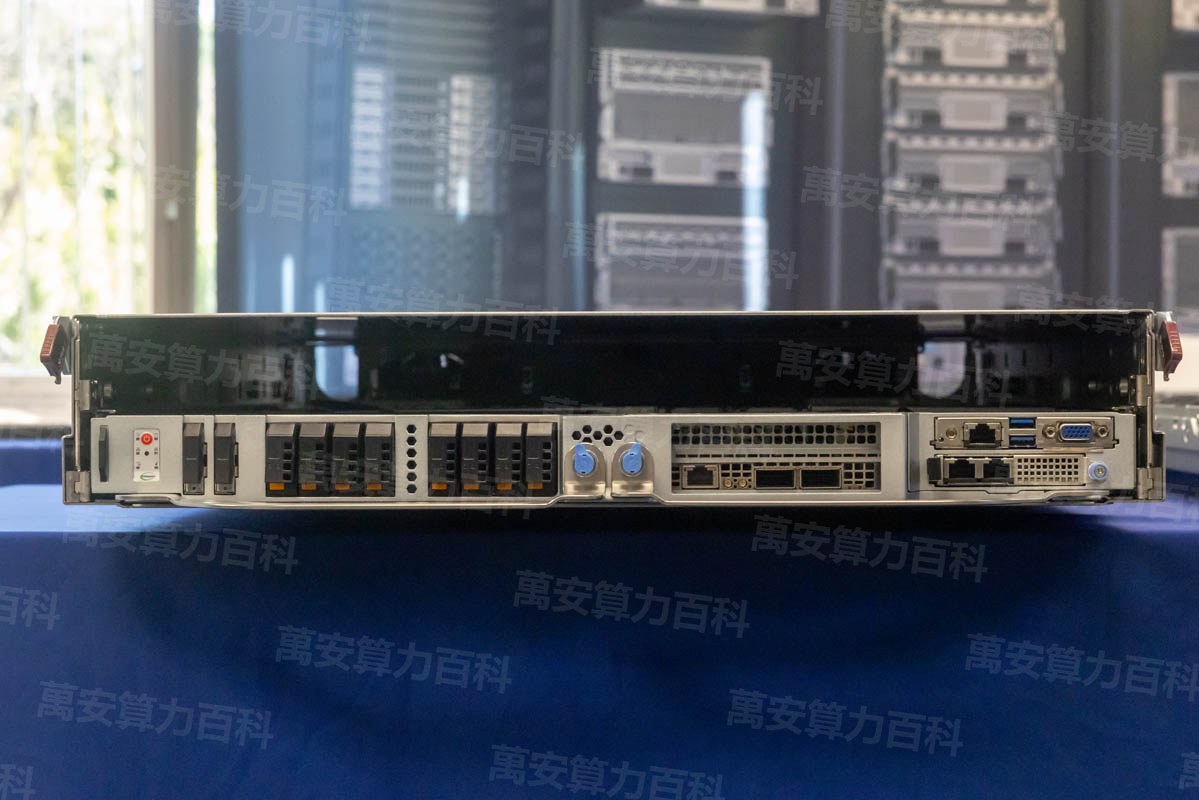
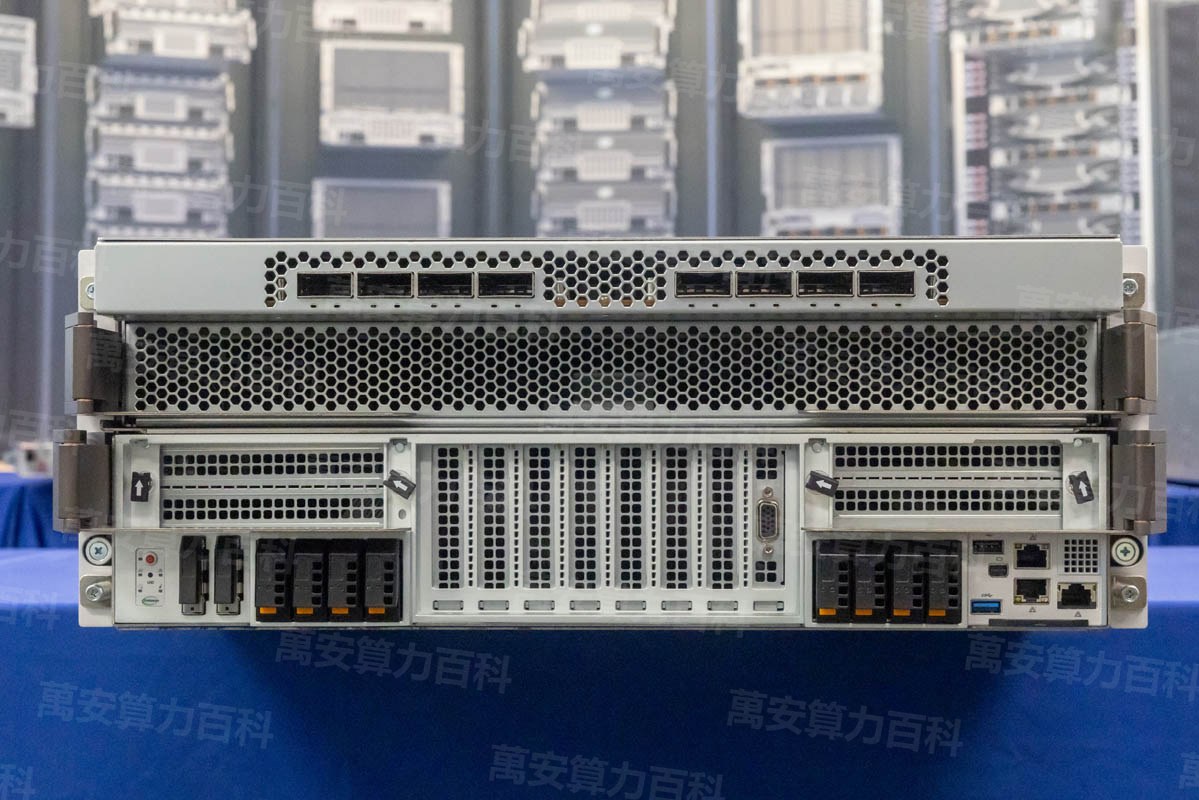
O B300 é vendido principalmente em formatos de máquina completa e placa base : máquina refrigerada a ar de 8 placas (NVL8), base refrigerada a líquido de 16 placas (NVL16) e o formato de superchip combinado com CPU Grace (série GB300)[2]. Entre elas, a máquina refrigerada a ar de 8 placas, por não exigir adaptação do data center à refrigeração líquida, tornou-se o modelo Blackwell Ultra com maior circulação no mercado de estoque disponível da China continental.
Desde a segunda metade de 2025, o B300 na China continental está em escassez de oferta : a capacidade de produção foi reservada pelos grandes provedores de nuvem e clientes de peso, não há preço padrão em canais públicos, e os preços do estoque disponível são significativamente mais altos que os valores de tabela dos canais norte-americanos (dados de mercado no módulo「Faixa de mercado」desta entrada)[3]。
Cenários de uso FIT
AIXX Index (0–100): esta base estima com pesos baseados em especificações públicas — memória de vídeo 40% + interconexão 30% + ecossistema 30%, com pesos ajustados por cenário. 90+ nível flagship · 75+ Excelente · 60+ utilizável · abaixo de 60 não recomendado. Metodologia transparente e verificável, não constitui promessa de desempenho.
Histórico HISTORY
2022 — Lançamento do H100 da arquitetura Hopper da geração anterior, que ocupou por anos a posição de principal GPU de data center.[1]
2024 — Lançamento da arquitetura Blackwell, produção em massa do B200; lançamento da solução de supernó GB200 NVL72.
2025-03 — A NVIDIA anuncia na GTC o「Blackwell Ultra」, ou seja, o B300, com entregas previstas para a segunda metade de 2025[1]。
Segunda metade de 2025 — As máquinas B300 começam a ser entregues, o canal de estoque disponível na China continental inicia a circulação, e os preços se tornam uma caixa-preta.
2026 — A máquina refrigerada a ar B300 NVL8 torna-se uma das máquinas de computação de alto desempenho com maior volume de transações no mercado de estoque da China continental; a escassez de oferta continua.
Especificações técnicas SPECIFICATIONS
| Item | Especificação |
|---|---|
| Núcleo da GPU | NVIDIA B300「Blackwell Ultra」SXM |
| Memória de vídeo por placa | 288GB HBM3e (2,3TB no total das oito placas) |
| Potência de inferência FP4 | Aprox. 1,1 PFLOPS (densa) / por placa |
| Interconexão GPU-GPU | NVLink de quinta geração · 1,8TB/s |
| Consumo da placa (TBP/TGP) | 1100W |
| Formato principal de máquina completa | 8 placas refrigeradas a ar (NVL8) · 16 placas refrigeradas a líquido (NVL16) · série de superchips GB300 |
| Geração anterior / produto equivalente | HGX H100 8 / HGX H200 8 (arquitetura Hopper) |
As especificações seguem os dados oficiais públicos da NVIDIA[1]; as configurações das máquinas completas variam conforme o OEM e o lote.
Membros da família FAMILY
Máquinas completas e formatos de sistema baseados no B300:
Comparativo de formatos de refrigeração AIR vs LIQUID
Ambos na plataforma B300, refrigerado a ar e refrigerado a líquido são duas rotas de implantação — a diferença não está na computação, está no data center 。


| Dimensão | B300 NVL8 refrigerado a ar | HGX B300 NVL16 refrigerado a líquido |
|---|---|---|
| Método de refrigeração | Totalmente refrigerado a ar (parede de ventoinhas do chassi) | Refrigeração líquida por placa fria (requer CDU e tubulação) |
| Requisitos do data center | Data center existente serve, alimentação na faixa de 10kW | Requer tubulação de refrigeração líquida / infraestrutura de CDU e avaliação de carga estrutural |
| Prazo de implantação | Dias (basta energia para rackear) | Semanas a meses (incluindo reforma do data center) |
| Escala de interconexão GPU-GPU | 8 placas full mesh NVLink | 16 placas full mesh NVLink |
| Para quem | Data centers existentes, compras em lotes, entrada rápida em operação | Data center próprio com refrigeração líquida, clusters de treinamento de alta densidade |
AIXX Index · quatro dimensões de implantação
| Índice (0–100) | NVL8 refrigerado a ar | NVL16 refrigerado a líquido |
|---|---|---|
| Facilidade de instalação | 95 | 55 |
| Facilidade de manutenção | 90 | 72 |
| Densidade de desempenho | 70 | 95 |
| Expectativa de vida útil | 82 | 88 |
Fundo dourado claro = itens de diferença central entre os dois formatos. O índice segue o critério de estimativa desta base (método em「Sobre esta base」) e varia conforme os pesos por uso — o AIXX Index combinado difere por cenário, veja「Cenários de uso」.
Compatibilidade de modelos MODEL FIT
Esta tabela responde a uma pergunta: quão grande é o modelo que esta máquina consegue rodar . O uso de memória é um critério estimado (peso ≈ nº de parâmetros × bytes por parâmetro, FP8 ≈ 1B/parâmetro, INT4 ≈ 0,5B/parâmetro, com margem adicional para cache KV e ativações); na implantação real, prevalecem as medições práticas.
| Modelo | Escala de parâmetros | Estimativa de pesos em FP8 | Cabe nos 2,3TB? | AIXX Index | Em uma frase |
|---|---|---|---|---|---|
| DeepSeek R1 | MoE 671B (37B ativados) | ≈690GB | Implantação em máquina única com capacidade total, com margem de sobra | 95 | Um dos destinos preferidos para inferência de grandes modelos |
| Kimi K2 | 1T MoE | ≈1.0TB | Cabe com folga, com margem para suportar alta concorrência | 93 | Plataforma de nível de frota para MoEs gigantes |
| Qwen3 235B | 235B MoE | ≈235GB | Fácil, permite múltiplas instâncias em paralelo | 96 | Carro-chefe de produção em alta concorrência |
| Classe Llama 3 70B | 70B denso | ≈70GB | Uma única placa já basta | 88 | Várias placas servem sobretudo para escalar a concorrência |
| Modelos de vídeo open source | Classe 10–20B | ≈10–20GB | Uma única placa resolve | 72 | Configurar placas conforme a necessidade de throughput, com grande redundância de desempenho |
As especificações dos modelos evoluem rápido; esta tabela foi compilada com base em dados públicos de outubro de 2026. A memória dos modelos MoE é estimada considerando todos os parâmetros carregados na VRAM. Faixas: 90+ nível flagship · 75+ Excelente · 60+ utilizável · abaixo de 60, não recomendado. Encontrou algo desatualizado? Avise-nos pelo canal de correções por favor.
Galeria GALLERY
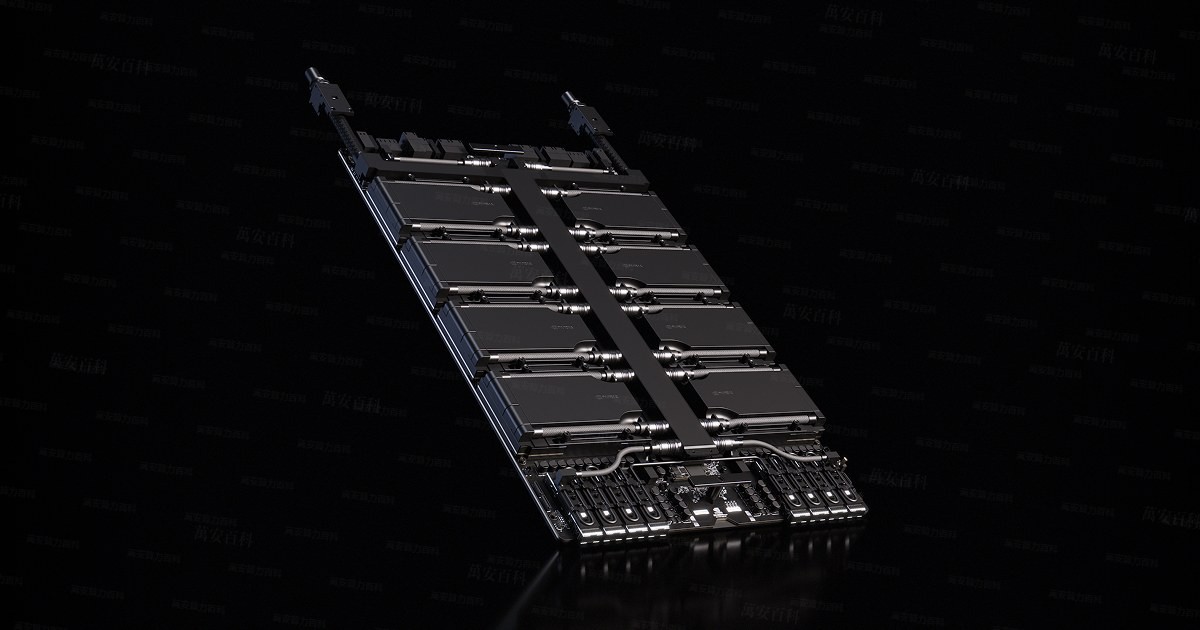

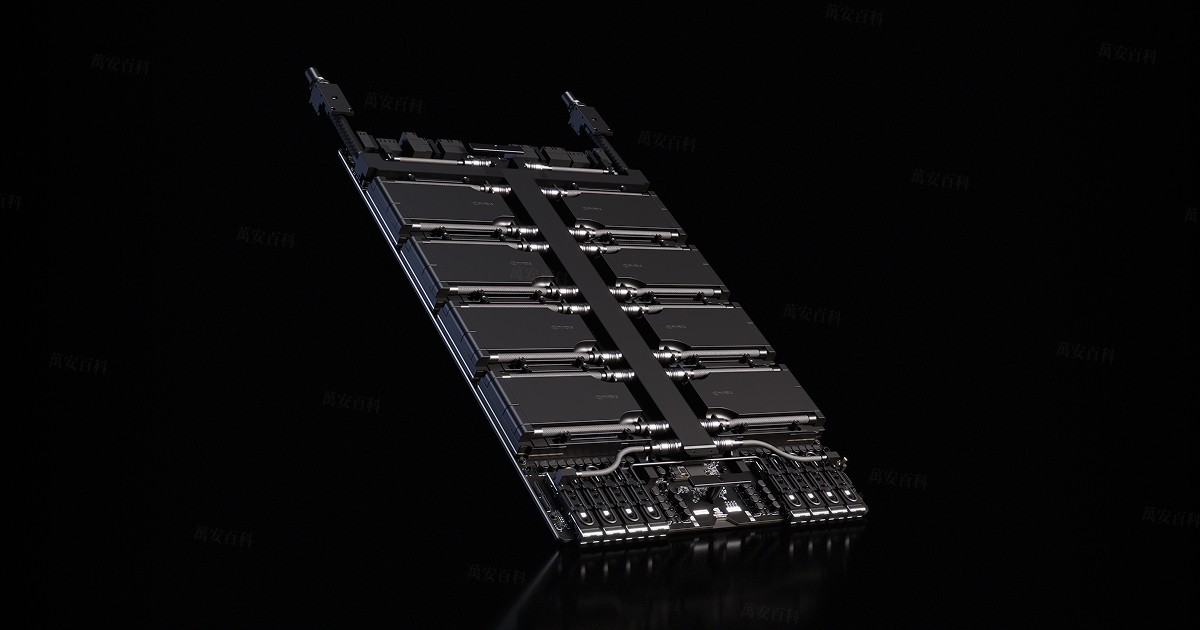

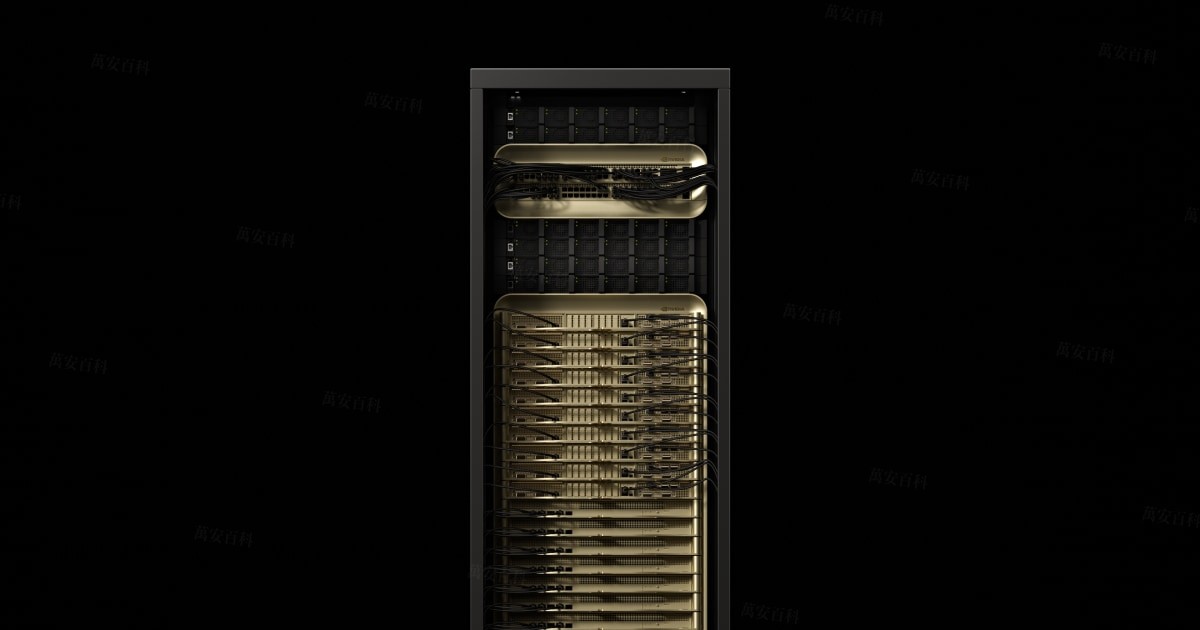
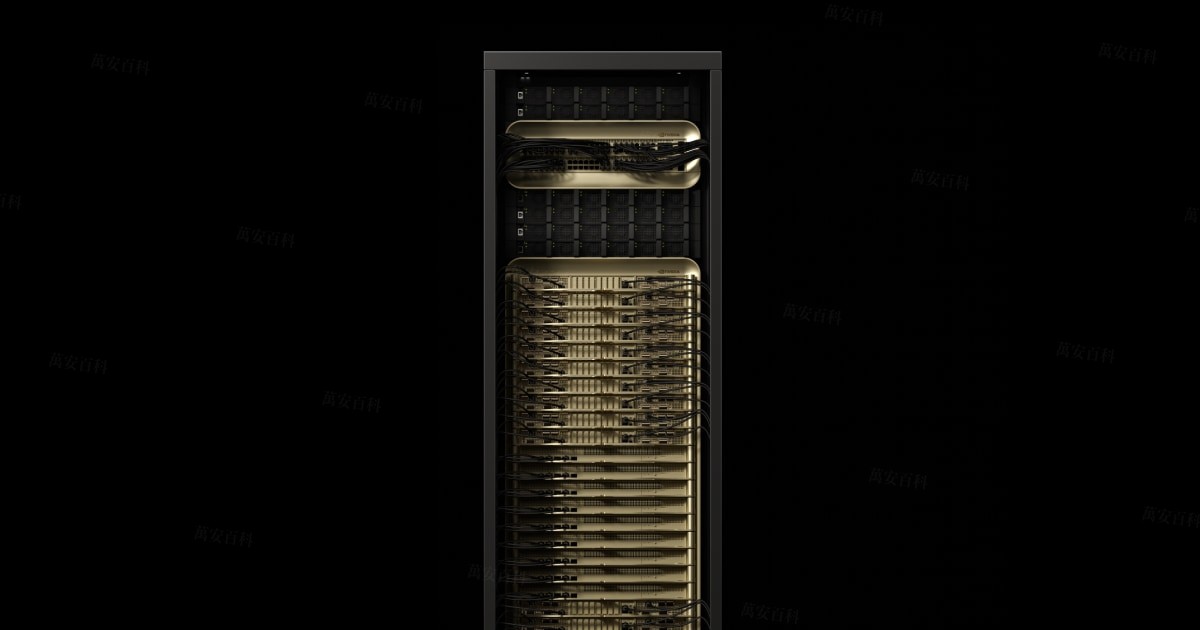
Vídeo explicativo VIDEO
Máquina real da comunidade · fonte: YouTube COMMUNITY HANDS-ON
Em algumas regiões pode não ser possível reproduzir diretamente
Software e ecossistema ECOSYSTEM
A primeira milha depois de comprar a placa: drivers, frameworks e rede de interconexão.
| Item | Requisitos / situação atual |
|---|---|
| CUDA | 12.8 ou superior (requisito mínimo da geração Blackwell) |
| Driver | NVIDIA série 570 ou superior |
| Framework de treino | PyTorch / TensorFlow com suporte oficial à arquitetura Blackwell |
| Motores de inferência | vLLM / SGLang / TensorRT-LLM já adaptados |
| Infraestrutura de rede | Sistemas de 8 placas exigem interconexão de 800G: placa ConnectX-8 + switching Quantum-800 / Spectrum-X |
| Sistema operacional | Distribuições Linux mainstream (Ubuntu 22.04+, etc.) |
As versões da stack de software evoluem com o tempo; prevalece o que a NVIDIA publicar oficialmente. A compatibilidade entre driver e versão do CUDA é a armadilha mais comum da primeira milha.
Práticas de compra e armadilhas PROCUREMENT
Na inspeção de equipamentos de alto valor, a prática do setor é colocar estas sete perguntas na frente:
Os três golpes mais comuns
Para compras de equipamentos de alto valor, recomenda-se incluir inspeção por terceiros, verificando a consistência entre relatório e número de série.
Como fazer stress test BENCH TEST
O "novo" do mercado de pronta entrega precisa de respaldo por medição real. Todas as ferramentas são gratuitas e públicas: o driver traz consigo o nvidia-smi , o pacote oficial de diagnóstico da NVIDIA DCGM , o burn-in open source gpu-burn , o teste de interconexão nccl-tests , e os exemplos que acompanham o CUDA bandwidthTest . Nos seis cartões de referência abaixo, cada um traz "o que usar / qual número observar / quanto é Aprovado · Excelente · Fiasco":
nvidia-smigpu-burn 3600 ou dcgmi diag -r 3 · 30–60 minutosbandwidthTest(exemplo nativo do CUDA)nccl-tests benchmark all_reducevLLM rodar um modelo real com cargaNota metodológica: as linhas de Aprovado/Excelente foram compiladas por este banco segundo critérios de engenharia usuais (largura de banda como proporção do valor nominal, temperatura no limite comum para data centers) e serão calibradas progressivamente com dados medidos dos relatórios de inspeção; esta tabela não constitui qualquer compromisso de aceitação, prevalecendo o acordado em contrato. Os itens medidos no relatório de inspeção deste banco são registrados conforme esta tabela — NOT_EXECUTED indica que o item não foi executado, e o próprio «não testado» também é informação relevante.
Transporte e entrega LOGISTICS
| Etapa | Pontos-chave |
|---|---|
| Forma e peso | Sistema de 8 placas em cerca de 8U, peso total geralmente entre 100–170kg (dependendo do OEM e da configuração, estimativa) |
| Embalagem | Caixas de madeira originais com suportes antivibração, identificação contra umidade e tombamento |
| Conformidade transfronteiriça | Item sujeito a controle de exportação: despacho aduaneiro em conformidade e qualificação de importação são pré-requisitos; transbordo por terceiros é conduta de alto risco |
| Seguro | Segurar 100% do valor da mercadoria é prática padrão do setor |
| Sequência de recebimento | Primeiro inspecionar aparência e lacres, conferir números de série e só então energizar — a verificação prévia ao ligamento é inegociável |
OEM e variantes VENDORS
Na mesma placa-base HGX B300, as diferenças entre os sistemas completos estão na forma, refrigeração, densidade e serviços — ao escolher, comece pelas diferenças:
| Fabricante | Formato representativo | Diferenciais | Para quem |
|---|---|---|---|
| Oficial NVIDIA | DGX B300 | Entrega integrada oficial, software full-stack e suporte corporativo | Quem quer treinar logo de caixa e respaldo do fabricante |
| Supermicro | Formato duplo: 8U refrigerado a ar / 4U refrigerado a líquido | Mais variedade de formatos, forte em prazo e custo-benefício, garantia via canal | Data center próprio, foco em custo-benefício |
| Gigabyte | Série G893 (8U refrigerado a ar / 4U refrigerado a líquido) | Até 32 placas por rack, orientado a densidade, configuração por pedido | Quem busca densidade por rack |
| Dell | PowerEdge XE9712 (refrigeração líquida em nível de rack) | Arquitetura NVL72 em nível de rack + rede de serviços global de primeira linha | Implantações multinacionais, quem precisa de rede de serviços |
| HPE / Lenovo | Integração de linhas corporativas (predomina refrigerado a líquido) | Serviços corporativos e soluções financeiras maduros, formatos conservadores | Clientes corporativos, operação terceirizada |
AIXX Index · Comparação de implantação em quatro dimensões AIXX INDEX
| Fabricante | Facilidade de instalação | Facilidade de manutenção | Densidade de desempenho | Expectativa de vida útil |
|---|---|---|---|---|
| Oficial NVIDIA | 95 | 90 | 80 | 85 |
| Supermicro | 88 | 82 | 85 | 82 |
| Gigabyte | 85 | 80 | 92 | 80 |
| Dell | 90 | 92 | 88 | 86 |
| HPE / Lenovo | 86 | 90 | 84 | 85 |
O índice usa a metodologia de estimativa deste banco (0–100, mesmas dimensões dos quatro eixos de implantação dos «cenários de uso»); a pontuação baseia-se nas diferenças públicas de formato, solução de refrigeração e rede de serviços de cada fabricante, e é atualizada com validação em equipamento real e dados de lotes, não constituindo compromisso de compra. Consulte sempre o lançamento oficial de cada fabricante para o modelo específico.
Cartões de terminologia GLOSSARY
Memória HBM3e
Memória de alta largura de banda empilhada junto à GPU, o «celeiro» do treinamento de IA. A B300 tem 288GB por placa, somando 2.3TB nas oito.
Interconexão NVLink
Canal dedicado de alta velocidade entre placas (quinta geração, 1.8TB/s), que faz oito GPUs trabalharem como uma só.
SXM / NVL8
SXM é o encapsulamento com GPU montada diretamente na placa (não é placa encaixável); NVL8 designa o formato de placa-base com interconexão total das oito placas, o núcleo de computação dos servidores HGX.
Refrigeração líquida por placa fria / CDU
A placa fria encosta no chip e absorve o calor; o líquido refrigerante o transporta pelos tubos, e a CDU (unidade de distribuição) cuida da distribuição e circulação — infraestrutura essencial do data center líquido.
FP8
Formato de ponto flutuante de 8 bits, a precisão dominante em inferência e treinamento de IA; ao estimar o uso de memória do modelo, pesos ≈ nº de parâmetros × 1 byte.
MoE (Mixture of Experts)
Arquitetura de modelo grande com «ativação esparsa»: muitos parâmetros no total (como os 671B do DeepSeek R1), mas cada inferência ativa apenas uma parte (37B). Na implantação, todos os parâmetros ainda precisam estar na memória.
Limitações e controvérsias LIMITS
- Caixa-preta de preços e diferencial China–EUA : nos canais da América do Norte, o preço público de tabela é de cerca de US$ 497 mil (≈¥3,58 milhões, capturado em 2026-10), enquanto o mercado à vista da China continental geralmente cotado em ¥15–17 milhões — uma diferença de mais de 4 vezes entre sistemas completos da mesma especificação, um dos maiores prêmios entre os principais modelos de computação do mundo. O prêmio é a soma de três fatores: demanda muito acima da oferta (gigantes em fila, capacidade priorizada para os grandes, compradores avulsos esperando longamente), o endurecimento da lei americana de restrições à oferta regular para a China e a posição dominante da NVIDIA como vendedora única que dita preços (a Huawei e outras ainda têm um longo caminho de perseguição). Para as sobretaxas e prêmios de risco do reexportação por canais cinzentos, ver o item seguinte e a cronologia. As partes divergem nas atribuições; este banco apenas registra os dados diariamente.
- Disputa pela alocação de capacidade : a capacidade é priorizada para grandes clientes já alocados, e o período de espera de compradores médios e pequenos se conta em anos; «pagar mais para furar a fila» e vazamentos por canais internos são citados com frequência pela imprensa do setor, e a NVIDIA nunca publicou regras de alocação — a opacidade na alocação é a maior controvérsia de governança desta linha de produtos.
- Caos de canais e risco de recondicionadas : o mercado à vista registra casos de B200 vendidos como B300, memória superdimensionada no anúncio e placas recondicionadas passadas por novas (relatos de organismos de inspeção; nota deste banco: qualquer sistema completo «novo» de origem incerta deve ter número de série e relatório de inspeção verificados). Conferir estado e autenticidade é procedimento obrigatório na compra, não opcional.
- Consumo e barreiras de implantação : 1100W por placa e sistemas de 8 placas na casa dos 10kW, exigindo na maioria das instalações existentes adaptações elétricas e térmicas; no formato refrigerado a ar, o limite de refrigeração é o limite de desempenho, e ambientes de alta altitude e alta temperatura exigem operação com redução de potência.
- Controle de exportação e variável geopolítica : a B300 está sujeita ao controle de exportação dos EUA para a China, e a legalidade do canal depende de qualificação de importação; cada ajuste na política de controle reestrutura diretamente o sistema de preços (a aprovação do H200 para a China em 2026-07 derrubou imediatamente os preços da série H) — a política geopolítica é a maior variável de risco isolada deste modelo.
Faixa de mercado MARKET DATA
| Data | Critério | Região | Faixa de preço de referência | Observação |
|---|---|---|---|---|
| 2026-10-20 | Faixa de mercado deste banco | China continental | ¥12,57M – 16,62M | Faixa de cotações à venda (87 pontos) |
| 2026-10-06 | Snapshot medido | China continental | ¥10,72M – 15,02M | Faixa de cotações à venda (30 pontos) |
| 2026-10-07 | Snapshot medido | China continental | ¥10,72M – 15,02M | Faixa de cotações à venda (31 pontos) |
| 2026-10-08 | Snapshot medido | China continental | ¥10,72M – 15,02M | Faixa de cotações à venda (31 pontos) |
| 2026-10-09 | Snapshot medido | China continental | ¥10,72M – 15,06M | Faixa de cotações à venda (33 pontos) |
| 2026-10-04 | Preço âncora | China continental | ¥15,80 milhões – 17,00 milhões | Duas configurações, A/B |
| 2026-10-05 | Preço de tabela no canal de exportação | América do Norte | A partir de $496.728 | Preço inicial público do canal[3] |
| 2026-10 | Faixa apurada pelo mercado | China continental | ¥15,00 milhões – 17,00 milhões | Apurado junto a canais, sem verificação desta base |
Outras faixas de mercado em tempo real GLOBAL
| Mercado | Faixa em tempo real | Ir ao salão de negociação |
|---|---|---|
| Singapura (SGD) | 5,92 milhões – 7,90 milhões | 106 ofertas › |
| Europa (EUR) | 2,88 milhões – 3,94 milhões | 101 ofertas › |
| Japão (JPY) | 648,72 milhões – 902,40 milhões | 95 ofertas › |
| Oriente Médio (AED) | 14,31 milhões – 18,96 milhões | 92 ofertas › |
| China continental (CNY) | 12,57 milhões – 16,62 milhões | 87 ofertas › |
| Zona do dólar (USD) | 2,10 milhões – 2,94 milhões | 82 ofertas › |
Faixas em tempo real à venda em cada mercado (na moeda original, atualizadas ao carregar a página); clique em «N ofertas» para ir direto ao salão de negociação, com a região já selecionada.
Metodologia: a partir de 06-2025, faixa estimada (retrossimulada a partir do cronograma oficial de entrada do B300 no mercado, com amplitude = variação de estado/configuração); a partir de 10-2026, registros diários de testes reais (ver tabela acima); para a América do Norte, preço de tabela do canal convertido em yuan, com faixa estimada retrossimulada pela alta da escassez de estoque desde o lançamento (aprox. o dobro), ancorada em 10-2026 no preço de tabela de canal de $496.728. Fonte dos preços desta base: Bolsa de Cálculo AIXX (intermediação sem comissão, não participa de transações, não conhece nem especula preços de fechamento, o que garante neutralidade dos dados). As faixas estimadas dos demais mercados são retrossimuladas com aproximadamente o dobro desde o lançamento, ancoradas no snapshot real à venda do dia. A faixa de referência serve apenas para acompanhar a tendência, não constitui oferta de negociação; O preço real está sujeito à cotação do vendedor.
Marcos históricos de preço MILESTONES
Novidades e eventos relacionados TIMELINE
Perguntas frequentes FAQ
Sim. Os pesos em FP8 somam cerca de 690GB; com 2,3TB de memória total, é possível uma implantação completa em servidor único com folga (ver «Compatibilidade de modelos»).
A versão NVL8 refrigerado a ar foi projetada justamente para salas existentes, bastando alimentação na faixa de 10kW; a versão refrigerado a líquido exige infraestrutura adequada (ver «Comparação de formas de refrigeração»).
Confire a serigrafia e o relatório de firmware oficial, e valide o número de série por canais independentes; as duas gerações são muito parecidas visualmente, fotos não são confiáveis (ver «Práticas de compra e como evitar armadilhas»).
Primeiro, a demanda supera em muito a oferta — as big techs disputam os estoques, a capacidade prioriza os grandes clientes e compradores avulsos enfrentam longas filas; segundo, o governo americano impôs leis de proibição extremamente rigorosas à China, tornando o produto inacessível por canais regulares; terceiro, a NVIDIA domina sozinha o mercado com uma vantagem técnica inconcorrente (a Huawei e outras ainda têm um longo caminho de recuperação). Somando os três fatores, o diferencial de preço à vista ultrapassa 4 vezes (ver «Limitações e controvérsias» e a faixa de mercado, dados de 10-2026).
Está em produção, com demanda superior à oferta: a capacidade é priorizada para os grandes clientes, e o prazo de espera para compradores médios e pequenos conta-se em anos.
Entradas relacionadas SEE ALSO
Comparação e escolha de modelos COMPARE
Referências REFERENCES
- Site oficial da NVIDIA — páginas do produto Blackwell Ultra / HGX B300 https://www.nvidia.com/en-us/data-center/hgx/
- NVIDIA Newsroom — lançamento da plataforma Blackwell Ultra https://nvidianews.nvidia.com/news/nvidia-blackwell-ultra-ai…
- Cotações com dados — Bolsa de Cálculo AIXX (preços à venda nesta plataforma e faixas conhecidas pelos canais, atualizadas diariamente) /hall.html
- Comunicado do Departamento de Justiça dos EUA — California Man Arrested for Smuggling More Than $300 Million in Export-Controlled Computer Servers (10-2026) https://www.justice.gov/opa/pr/california-man-arrested-smugg…