
B300
概要OVERVIEW
B300(正式名称 NVIDIA B300、「Blackwell Ultra」シリーズに属する)は NVIDIA が 2025 年に発表した データセンター GPU[1]で、2024 年の B200 の強化版にあたります。ボードあたりのメモリ容量は 288GB HBM3eで、前世代の H100(80GB)の 3 倍以上。FP4 推論性能は約 1.1 PFLOPS(デンス時)、ボード消費電力(TBP/TGP)は 1100W[1]。
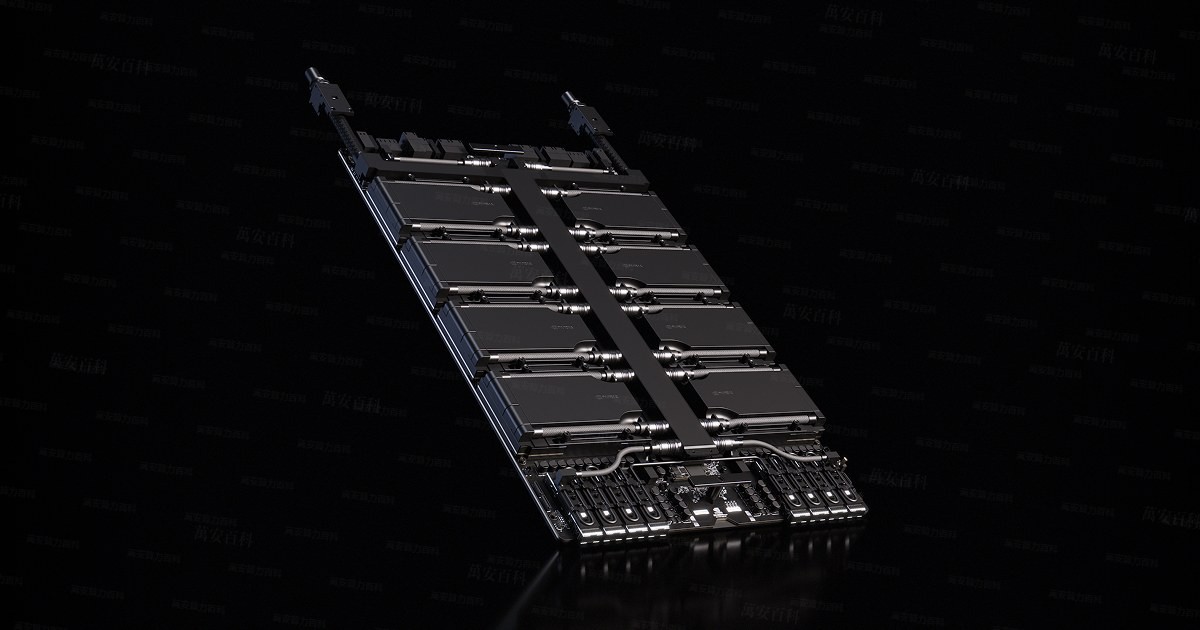
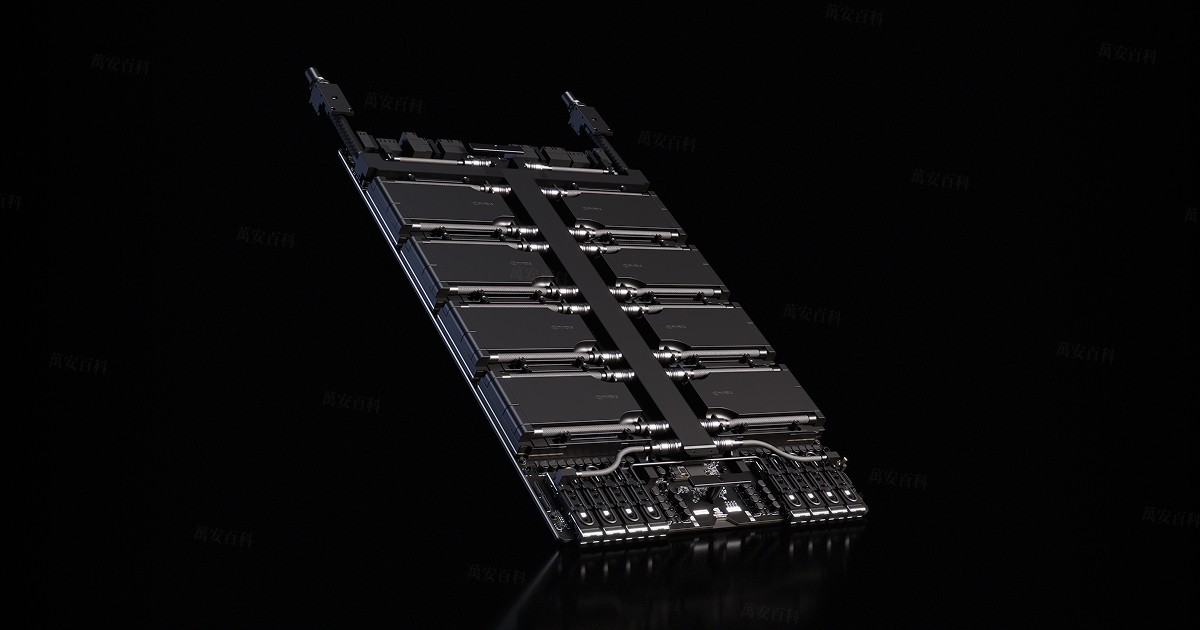
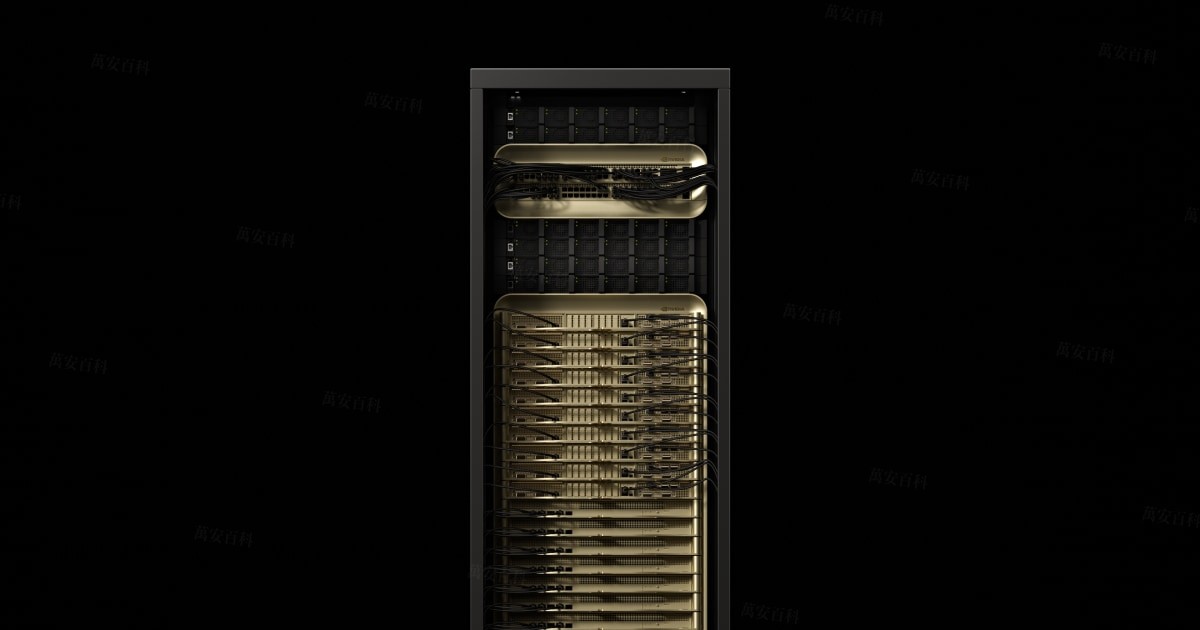
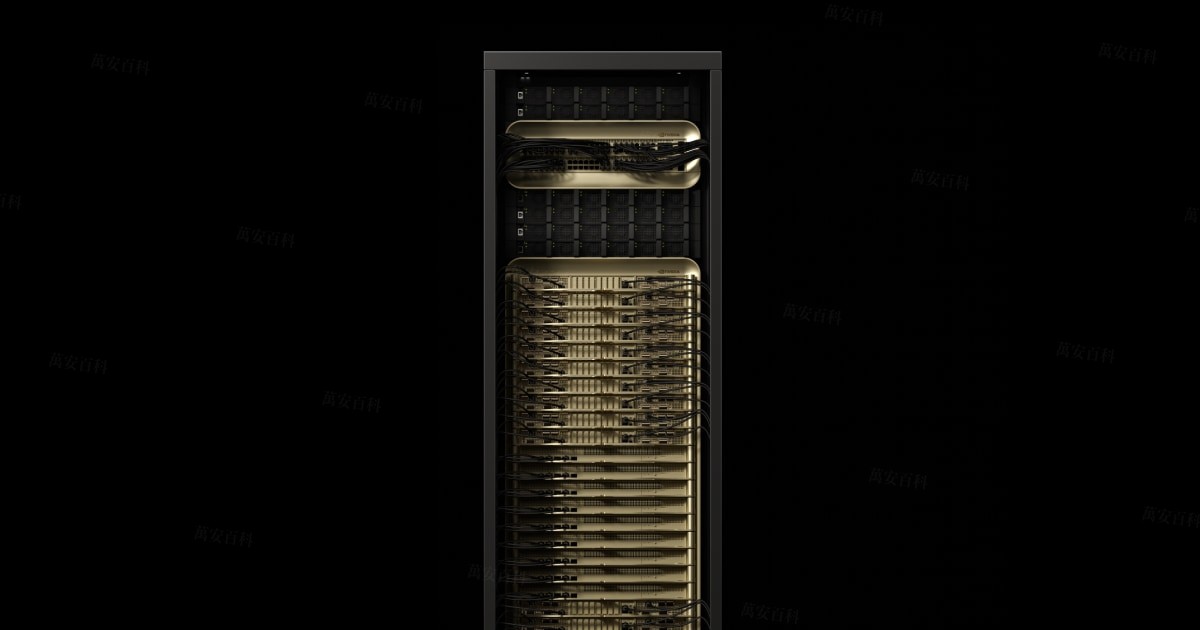
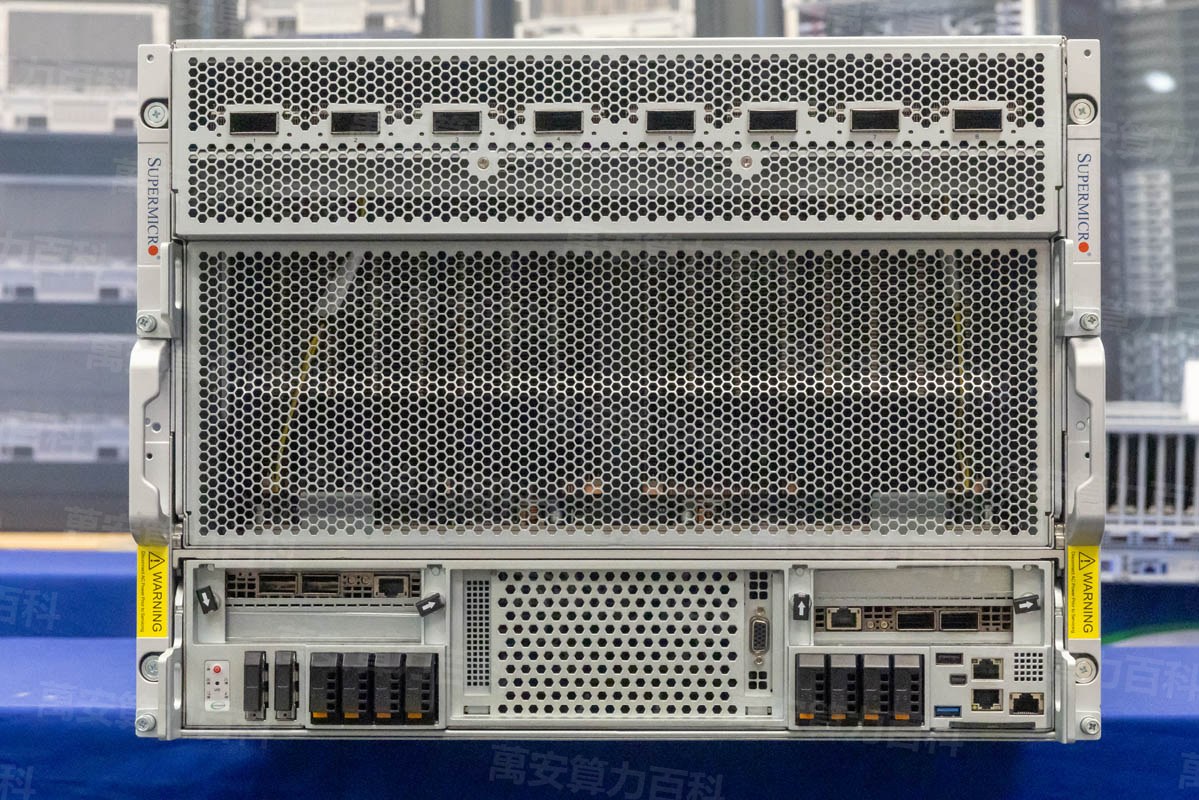
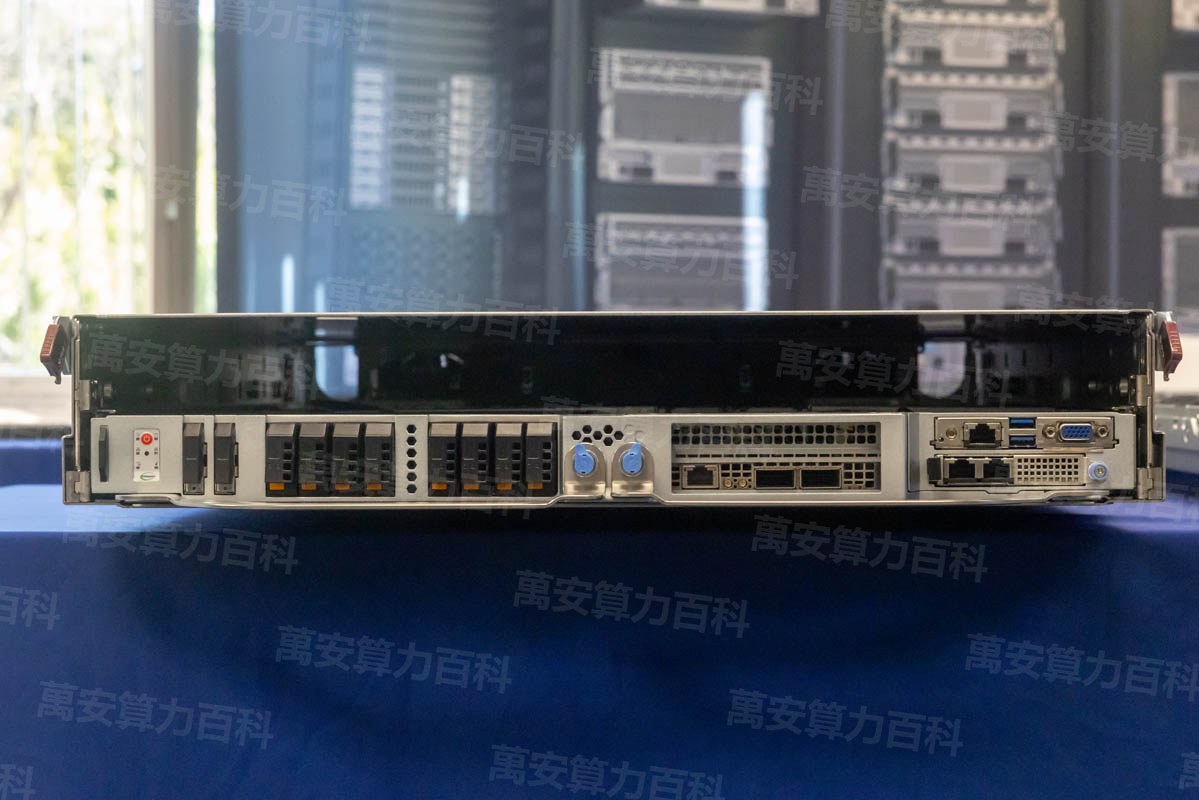
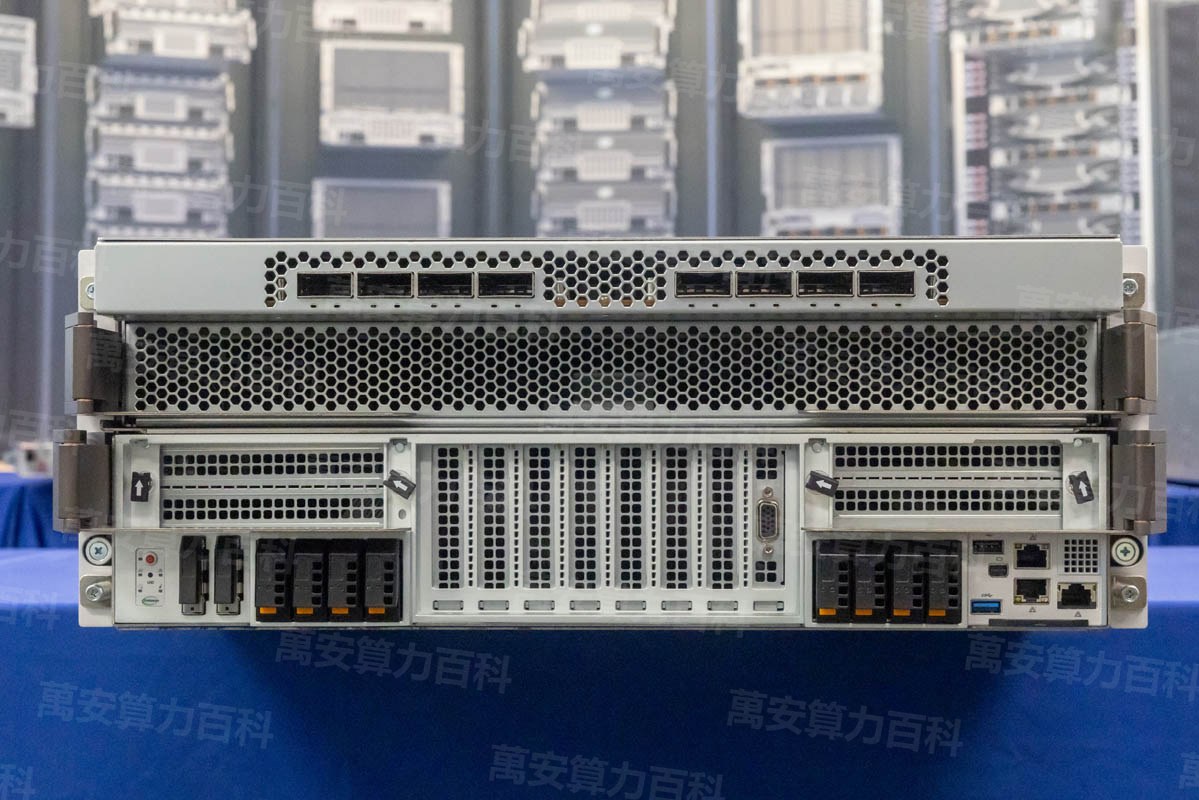
B300 は完成品サーバーおよび基板形態での販売が中心です:8 枚構成の空冷サーバー(NVL8)、16 枚構成の液冷ベースボード(NVL16)、さらに Grace CPU と組み合わせたスーパーチップ形態(GB300 シリーズ)[2]。このうち 8 枚構成の空冷サーバーは液冷対応のデータセンター改修が不要なため、中国本土で現物流通量が最大の Blackwell Ultra 機種となっています。
2025 年下半期以降、B300 は中国本土で供給不足が続いています:生産能力は大手クラウド事業者と大口顧客の予約に抑えられ、公開チャネルには標準価格がなく、現物価格は北米チャネルの定価を大幅に上回っています(相場データは本項目の「相場帯」モジュールを参照)[3]。
適用シーンFIT
AIXX Index(0–100):当ライブラリは公開スペックに基づく加重推定です——メモリ 40% + インターコネクト 30% + エコシステム 30%、用途に応じて重みを調整。90+ フラッグシップ級 · 75+ 優秀 · 60+ 実用圏 · 60 未満は不向き。算出方法は透明で検証可能ですが、性能の保証ではありません。
沿革HISTORY
2022 — 前世代の Hopper アーキテクチャ H100 が発表され、長年にわたりデータセンター GPU の主力ポジションを占めました。[1]
2024 — Blackwell アーキテクチャが発表され、B200 が量産開始。GB200 NVL72 スーパーノード構成が登場。
2025-03 — NVIDIA が GTC で「Blackwell Ultra」すなわち B300 を発表し、2025 年下半期の出荷を表明。[1]。
2025 下半期 — B300 サーバーの納品が進み、中国本土の現物チャネルで流通が始まり、価格はブラックボックス化。
2026 — B300 NVL8 空冷サーバーが中国本土の現物市場で取引量最大級のハイエンド算力機種となり、供給不足が継続。
技術仕様SPECIFICATIONS
| 項目 | 仕様 |
|---|---|
| GPU コア | NVIDIA B300「Blackwell Ultra」SXM |
| 単体メモリ | 288GB HBM3e(8 枚合計 2.3TB) |
| FP4 推論性能 | 約 1.1 PFLOPS(デンス)/ 枚あたり |
| GPU間インターコネクト | NVLink 第五世代 · 1.8TB/s |
| ボード消費電力(TBP/TGP) | 1100W |
| 主流のサーバー形態 | 8 枚空冷(NVL8)· 16 枚液冷(NVL16)· GB300 スーパーチップシリーズ |
| 前世代 / 対抗製品 | HGX H100 8 / HGX H200 8(Hopper アーキテクチャ) |
仕様は NVIDIA 公開資料による[1]。サーバー構成は OEM やロットにより差異があります。
ファミリー構成FAMILY
B300 ベースのサーバー・システム形態:
冷却形態の比較AIR vs LIQUID
同じ B300 プラットフォームでありながら、空冷と液冷は二つの異なる導入ルートです——差は演算性能ではなく、機械室にある。


| 比較項目 | B300 NVL8 空冷 | HGX B300 NVL16 液冷 |
|---|---|---|
| 冷却方式 | 全空冷(シャーシファンウォール) | コールドプレート液冷(CDU と配管が必要) |
| 機械室要件 | 既存の機械室で可、10kW 級の給電 | 液冷配管 / CDU の整備と耐震・耐重評価が必要 |
| 導入期間 | 日単位(電源確保後すぐラック搭載可) | 週〜月単位(機械室改修を含む) |
| GPU間インターコネクト規模 | 8 枚 NVLink フルメッシュ | 16 枚 NVLink フルメッシュ |
| 向いているケース | 既存機械室の活用、分割調達、迅速な稼働 | 自社液冷機械室、高密度学習クラスタ |
AIXX Index · 導入の 4 指標
| 指数(0–100) | 空冷 NVL8 | 液冷 NVL16 |
|---|---|---|
| 設置の手軽さ | 95 | 55 |
| 保守のしやすさ | 90 | 72 |
| 性能密度 | 70 | 95 |
| 寿命見込み | 82 | 88 |
淡い金の背景 = 両形態の中核的な差異項目。指数は当ライブラリの推定基準です(方法は「本ライブラリについて」を参照)。用途による重み付けで変動します——総合的な AIXX Index はシーンごとに異なるため、「適用シーン」を参照。
モデル対応MODEL FIT
この表が答えるのは一つの問いです:このマシンはどれだけ大きなモデルを載せられるか。メモリ使用量は推定基準です(重み ≈ パラメータ数 × 1 パラメータあたりバイト数、FP8 ≈ 1B/パラメータ、INT4 ≈ 0.5B/パラメータ。さらに KV キャッシュと活性化用の余裕が必要)。実際の導入時は実測を優先してください。
| モデル | パラメータ規模 | FP8 重み推定 | 2.3TB に収まるか | AIXX Index | ひとこと |
|---|---|---|---|---|---|
| DeepSeek R1 | 671B MoE(37B アクティブ) | ≈690GB | フルスペックで 1 台構成に収まり、余裕も十分 | 95 | 大規模モデル推論の有力な選択肢の一つ |
| Kimi K2 | 1T MoE | ≈1.0TB | 収まり、余裕が高並行処理を支える | 93 | 超大規模 MoE の輸送級キャリア |
| Qwen3 235B | 235B MoE | ≈235GB | 余裕で、複数インスタンスの並列運用も可 | 96 | 高並行本番運用の主力 |
| Llama 3 70B クラス | 70B デンス(Dense) | ≈70GB | 1枚のGPUで運用可能 | 88 | 複数枚は主に同時実行の拡張用 |
| オープンソース動画モデル | 10〜20B クラス | ≈10–20GB | 1枚で十分 | 72 | スループット需要に応じて構成、性能に大きな余裕あり |
モデル仕様の更新が速いため、本表は2026年10月時点の公開情報に基づき整理。MoEモデルのVRAMは全パラメータを実装した場合で試算。ランク分け:90以上 フラッグシップ級 ・ 75以上 優秀 ・ 60以上 実用 ・ 60未満 非推奨。古い情報を見つけたら、ぜひ訂正窓口ご指摘ください。
ギャラリーGALLERY


動画解説VIDEO
コミュニティ実機 · 出典 YouTubeCOMMUNITY HANDS-ON
地域によっては直接再生できない場合があります
ソフトウェアとエコシステムECOSYSTEM
購入後の第一歩:ドライバー、フレームワーク、インターコネクトネットワーク。
| 項目 | 要件 / 現状 |
|---|---|
| CUDA | 12.8 以上(Blackwell世代の最低要件) |
| ドライバー | NVIDIA 570 系以上 |
| 学習フレームワーク | PyTorch / TensorFlow ともに Blackwell アーキテクチャを公式サポート |
| 推論エンジン | vLLM / SGLang / TensorRT-LLM いずれも対応済み |
| ネットワーク構成 | 8枚トータルシステムには800Gインターコネクトが必要:ConnectX-8 NIC + Quantum-800 / Spectrum-X スイッチ |
| OS | 主要Linuxディストリビューション(Ubuntu 22.04+ など) |
ソフトウェアスタックのバージョンは時期により変動するため、NVIDIA公式リリースを基準にしてください。ドライバーとCUDAのバージョン不一致は、最初の一歩で最もよくあるつまずきポイントです。
調達実務と注意点PROCUREMENT
高額装置の検品では、業界の慣例として次の7つの質問を先に確認します:
三大よくある詐欺
高額装置の調達では第三者検品を導入し、検証レポートとシリアル番号の整合性を確認することを推奨。
ストレステストの方法BENCH TEST
現貨市場での「新品」には実測による裏付けが必要。ツールはすべて無料公開:ドライバー同梱の nvidia-smi、NVIDIA公式診断スイート DCGM、オープンソースの焼き込みテスト gpu-burn、インターコネクトテスト nccl-tests、CUDA同梱サンプル bandwidthTest。以下の6枚の判定カードでは、それぞれ「何を使うか / どの数値を見るか / どれくらいで合格・優秀・失敗か」を示す:
nvidia-smigpu-burn 3600 または dcgmi diag -r 3 · 30〜60分bandwidthTest(CUDA同梱サンプル)nccl-tests all_reduce ベンチマークvLLM 実モデルを起動して負荷計測基準の説明:合格/優秀ラインは当ライブラリが技術上の一般的基準に基づき整理したもの(帯域は公称値に対する比率、温度はデータセンターの一般的上限)。検品報告書の実測データの蓄積に応じて段階的に校正する。本表はいかなる検収の約束を構成するものではなく、詳細は契約の取り決めによる。当ライブラリの検品報告書の実測項目は本表の基準に従って記録される——NOT_EXECUTED は未実施を意味し、「未測定」そのものも重要な情報である。
輸送と納品LOGISTICS
| 項目 | 要点 |
|---|---|
| 形態と重量 | 8カード一体機で約 8U、機器重量は通常 100〜170kg(OEMと構成により変動、推算ベース) |
| 梱包 | 純正木箱と制震ブラケット、防湿・転倒防止表示付き |
| 越境コンプライアンス | 輸出規制対象:コンプライアンスに準拠した通関と輸入資格が前提条件。第三国経由の転送は高リスク行為 |
| 保険 | 貨物価値の全額投保が業界慣行 |
| 到着時の手順 | まず外観と封印を検査し、シリアル番号を照合してから通電——通電前の検証は省略できない |
OEM とバリエーションVENDORS
同一の HGX B300 基板でありながら、各社の一体機は形態・冷却・密度・サービスが異なる——選定はまず違いを見る:
| 一体機メーカー | 代表形態 | 差別化ポイント | 向いているケース |
|---|---|---|---|
| NVIDIA 純正 | DGX B300 | 公式の一体型納入、フルスタックソフトウェアとエンタープライズ支援 | 開梱即トレーニング、純正の裏付けを求める場合 |
| Supermicro 超微 | 8U 空冷 / 4U 液冷の2形態 | 形態が最も充実、納期とコスパに強み、経路保証付き | 自社データセンター構築、コスパ重視 |
| Gigabyte 技嘉 | G893 シリーズ(8U 空冷 / 4U 液冷) | 1ラックに32カード搭載可能、密度志向、受注生産の構成 | 1ラックあたりの密度を追求 |
| Dell Dell | PowerEdge XE9712(ラックレベル液冷) | ラックレベルの NVL72 アーキテクチャ + グローバル一流のサービス網 | 越境展開、サービス網を求める場合 |
| HPE / Lenovo | エンタープライズ製品ライン統合(液冷主体) | エンタープライズサービスとファイナンス方案が成熟、形態は保守的 | エンタープライズ顧客、運用の外部委託 |
AIXX Index · 展開四軸比較AIXX INDEX
| 一体機メーカー | 導入の容易さ | 保守のしやすさ | 性能密度 | 寿命見込み |
|---|---|---|---|---|
| NVIDIA 純正 | 95 | 90 | 80 | 85 |
| Supermicro 超微 | 88 | 82 | 85 | 82 |
| Gigabyte 技嘉 | 85 | 80 | 92 | 80 |
| Dell Dell | 90 | 92 | 88 | 86 |
| HPE / Lenovo | 86 | 90 | 84 | 85 |
指数は当ライブラリの推算ベース(0〜100、軸は「適用シーン」の展開四軸と同一)。スコアの根拠=各社公開の形態・冷却方案・サービス網の差異であり、実機検証とロットデータにより随時更新され、調達の約束を構成しない。具体的型番は各社の公式発表による。
用語カードGLOSSARY
HBM3e メモリ
GPUの横に積層された高帯域メモリで、AI学習の「備蓄倉庫」。B300 は1カード 288GB、8カード合計 2.3TB。
NVLink インターコネクト
カード間の専用高速チャネル(第5世代 1.8TB/s)。8基の GPU を1基のように協調動作させる。
SXM / NVL8
SXM は GPU の基板直付けパッケージ(挿し替えカードではない);NVL8 は8カード全結合基板形態を指し、HGX サーバーの計算コアである。
コールドプレート液冷 / CDU
コールドプレートがチップに密着して熱を吸収し、冷却液が配管を通じて熱を運び去る。CDU(分配ユニット)が分配と循環を担う——液冷データセンターの中核装備。
FP8
8ビット浮動小数点フォーマット。AI推論・学習の主流精度。モデルのVRAM占有量を推算する際、重みはほぼパラメータ数×1バイト。
MoE 混合エキスパート
「疎な活性化」の大規模モデルアーキテクチャ:総パラメータは大きい(例:DeepSeek R1 の 671B)が、推論ごとに活性化されるのは一部のみ(37B)。ただしデプロイ時は全パラメータをカードに載せる必要がある。
限界と論点LIMITS
- 価格のブラックボックスと米中価格差:北米経路の公開定価は約 $49.7万(≈3,580万元、2026-10取得)に対し、中国本土の現物は一般に 1,500万〜1,700万元で提示されている——同一仕様の一体機で4倍超の価格差があり、グローバル主流算力機種の中でも最も極端なプレミアムの一つ。プレミアムは三重の重なり:需要が供給を大きく上回る(大手が行列で奪い合い、生産能力は頭部顧客優先、個別買い手は長い順番待ち)、米国の対中禁止法案により正規供給が縮小、そして一人勝ちの NVIDIA が売り手として価格決定権を握る(Huawei などにはなお大きな追い上げ余地がある)。グレーゾーン経路の転売マージンとリスクプレミアムは次項と年表を参照。各者の帰属をめぐる論争は決着しておらず、当ライブラリはデータの日々記録のみを行う。
- 生産能力配分をめぐる論争:生産能力は配分を得た頭部顧客に優先供給され、中小買い手の待ち期間は年単位。「値上げ割り込み」と内部経路からの流出は業界メディアで繰り返し言及されており、NVIDIA は配分ルールを一度も公開していない——配分の不透明さがこの製品ライン最大のガバナンス論争である。
- 経路の混乱とリファービッシュリスク:現物市場には B200 を B300 と偽る、VRAM容量の虚偽表示、リファービッシュカードの新古偽装などの事例が存在する(検品機関の通報より。当ライブラリ註:出所不明の「新品」一体機はすべてシリアル番号と検品報告書の照合をすべき)。状態と真贋の検証は調達の必須手続きであり、選択肢ではない。
- 消費電力と導入ハードル:1カード 1100W、8カード一体機の消費電力は 10kW 級。既存のデータセンターでは一般に電源と冷却の改修が必要。空冷形態では冷却上限がそのまま性能上限となり、高標高・高温環境ではディレーティング運転が必要。
- 輸出規制と地政学リスク:B300 は米国の対中輸出規制対象であり、経路の合法性は輸入資格に依存する。規制政策の一回一回の調整が価格体系を直接再構築する(2026-07 の H200 対中承認はただちに H シリーズ価格の急落を引き起こした)——地政学政策が本機種最大の単一リスク要因である。
相場帯MARKET DATA
| 日付 | 基準 | 地域 | 参考価格帯 | 備考 |
|---|---|---|---|---|
| 2026-10-20 | 当ライブラリの相場帯 | 中国本土 | 1,257万〜1,662万元 | 販売中の提示価格レンジ(87件) |
| 2026-10-06 | 実測スナップショット | 中国本土 | 1,072万〜1,502万元 | 販売中の提示価格レンジ(30件) |
| 2026-10-07 | 実測スナップショット | 中国本土 | 1,072万〜1,502万元 | 販売中の提示価格レンジ(31件) |
| 2026-10-08 | 実測スナップショット | 中国本土 | 1,072万〜1,502万元 | 販売中の提示価格レンジ(31件) |
| 2026-10-09 | 実測スナップショット | 中国本土 | 1,072万〜1,506万元 | 販売中の提示価格レンジ(33件) |
| 2026-10-04 | アンカー価格 | 中国本土 | 1,580万〜1,700万元 | A/B 2種類の構成 |
| 2026-10-05 | 海外経路の定価 | 北米 | $496,728 から | 販売店の公開起売価格[3] |
| 2026-10 | 市場で把握されているレンジ | 中国本土 | 1,500万〜1,700万元 | 経路情報、当ライブラリ未検証 |
その他マーケットのリアルタイム帯GLOBAL
| マーケット | リアルタイム帯 | トレードホールへ直接 |
|---|---|---|
| シンガポール(SGD) | 592万 – 790万 | 106件の提示 › |
| 欧州(EUR) | 288万 – 394万 | 101件の提示 › |
| 日本(JPY) | 64,872万 – 90,240万 | 95件の提示 › |
| 中東(AED) | 1,431万 – 1,896万 | 92件の提示 › |
| 中国本土(CNY) | 1,257万 – 1,662万 | 87件の提示 › |
| 米ドル圏(USD) | 210万 – 294万 | 82件の価格情報 › |
各マーケットのリアルタイム販売帯(元通貨建て、ページ読み込み時にリアルタイム更新)。「N件の提示」をクリックすると取引ホールに直接アクセスでき、地域は自動選択されます。
注記:2025年6月以降は推定帯(B300の正式投入ペースから遡って推演、帯幅=状態・構成による変動)、2026年10月以降は実測スナップショットの日々記録(上表参照)。北米はチャネル表示価格の人民元換算、推定帯は投入時から現在までの現物希少性による上昇を遡及(約2倍)、2026年10月はチャネル表示価格 $496,728 をアンカー。当ライブラリの価格データの出典:AIXX 取引所(手数料ゼロのマッチング、取引には関与せず、成約価格も保有・推測しないため、データは中立的)。その他マーケットの推定帯は上場以来約2倍として遡及し、終点は当日の販売中実測スナップショットにアンカー。参考価格帯はトレンドの参考にのみ提供され、取引の申込みを構成するものではなく、実際の価格は出品者の提示価格によります。
価格イベント年表MILESTONES
動向と関連イベントTIMELINE
よくある質問FAQ
はい。FP8重みは約690GBで、総2.3TBのメモリによりフルスペックの単体デプロイが可能で、余裕も十分です(「モデル適合」参照)。
空冷 NVL8 構成はまさに既存のサーバールーム向けに設計されており、10kW級の給電で対応可能。液冷構成には設備の配套が必要です(「冷却形態の比較」参照)。
シルク印刷と公式ファームウェアのレポートを照合し、シリアル番号を独立チャネルでクロス検証してください。両世代は外観が非常に似ており、写真だけでは判断できません(「調達実務と落とし穴回避」参照)。
第一に供給より需要がはるかに大きい——巨大企業が列を作って買い殺し、生産能力は大手顧客を優先、個人買い手は長い順番待ちが必要。第二に米政府が中国向けに極めて厳しい禁止法を公布しており、正規チャネルでは購入できない。第三にNVIDIAが一人勝ちで技術面で断層的なリードを持ち(Huaweiなどにはまだ大きな追い上げ余地あり)。三重要因が重なり、現物価格差は4倍超(「限界と論争」およびマーケット帯参照、2026年10月ベース)。
生産中だが供給不足:生産能力は大手顧客を優先し、中小買い手の待ち期間は年単位。
関連項目SEE ALSO
機種比較と選定COMPARE
参考文献REFERENCES
- NVIDIA公式サイト — Blackwell Ultra / HGX B300 製品ページ https://www.nvidia.com/en-us/data-center/hgx/
- NVIDIA Newsroom — Blackwell Ultra プラットフォーム発表 https://nvidianews.nvidia.com/news/nvidia-blackwell-ultra-ai…
- マーケット帯データ — AIXX Exchange(当プラットフォームの販売中の提示価格とチャネル把握区間、毎日更新) /hall.html
- 米司法省発表 — California Man Arrested for Smuggling More Than $300 Million in Export-Controlled Computer Servers(2026年10月) https://www.justice.gov/opa/pr/california-man-arrested-smugg…