AIXX Pedia › Fiche modèle › B300

B300
Vue d'ensembleOVERVIEW
B300(nom complet NVIDIA B300, appartenant à la série « Blackwell Ultra ») est un GPU datacenter[1]publié par NVIDIA en 2025, version améliorée du B200 de 2024. Mémoire vidéo par carte 288GB HBM3e soit plus du triple du H100 de génération précédente (80 Go), puissance de calcul FP4 d'environ 1.1 PFLOPS(dense), consommation de la carte (TBP/TGP) 1100W[1]。
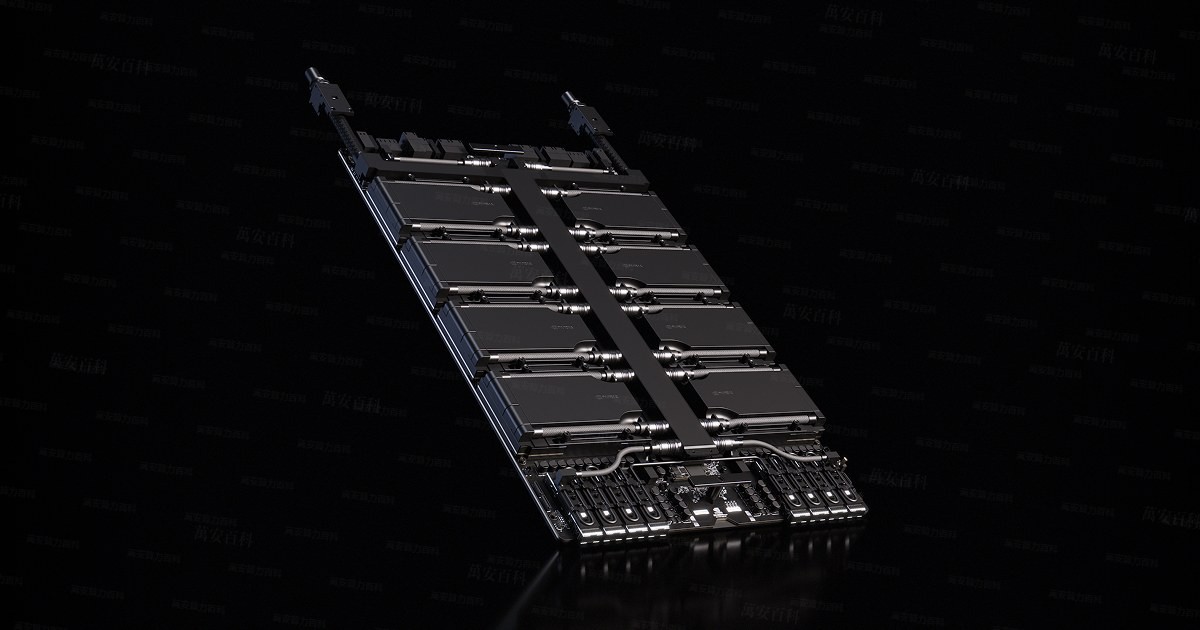
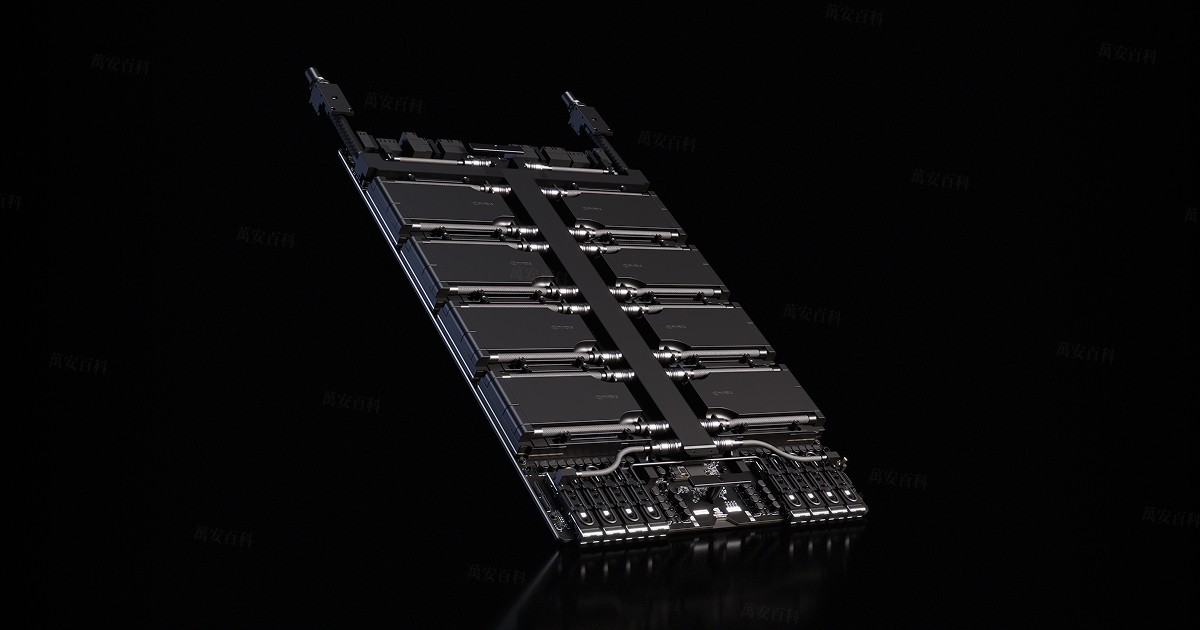
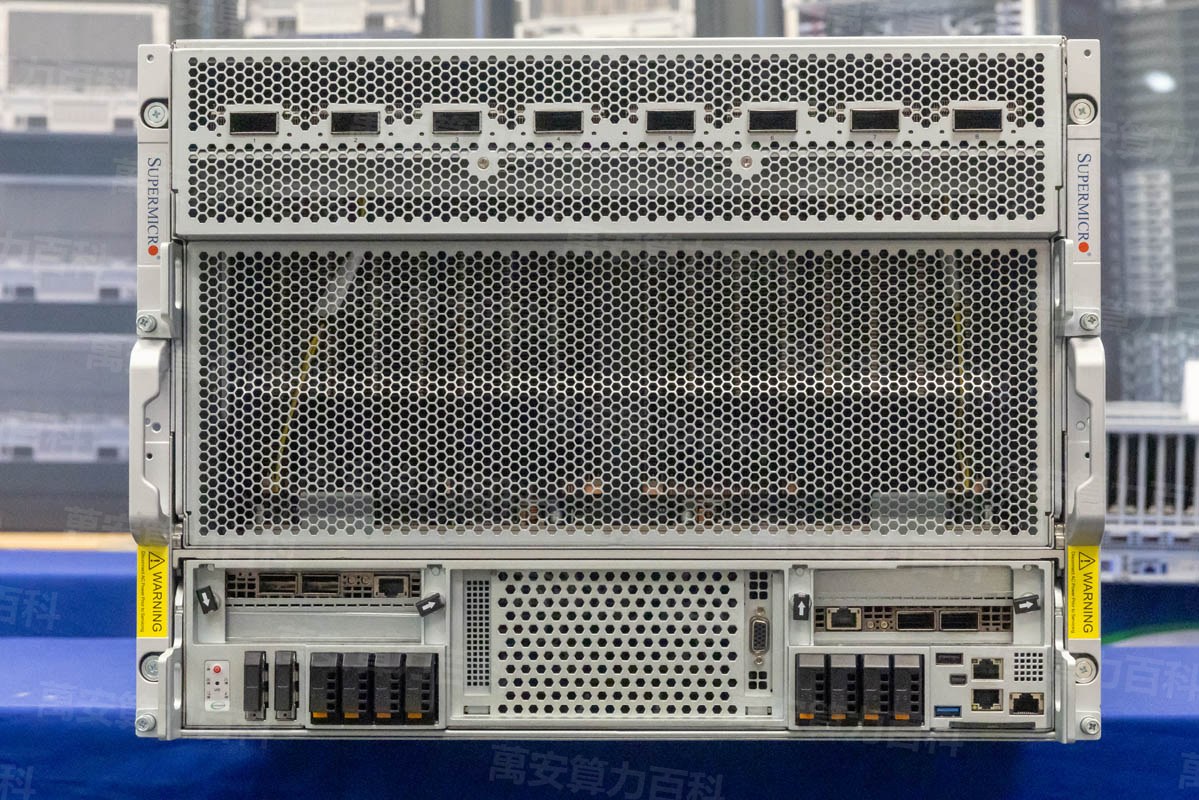
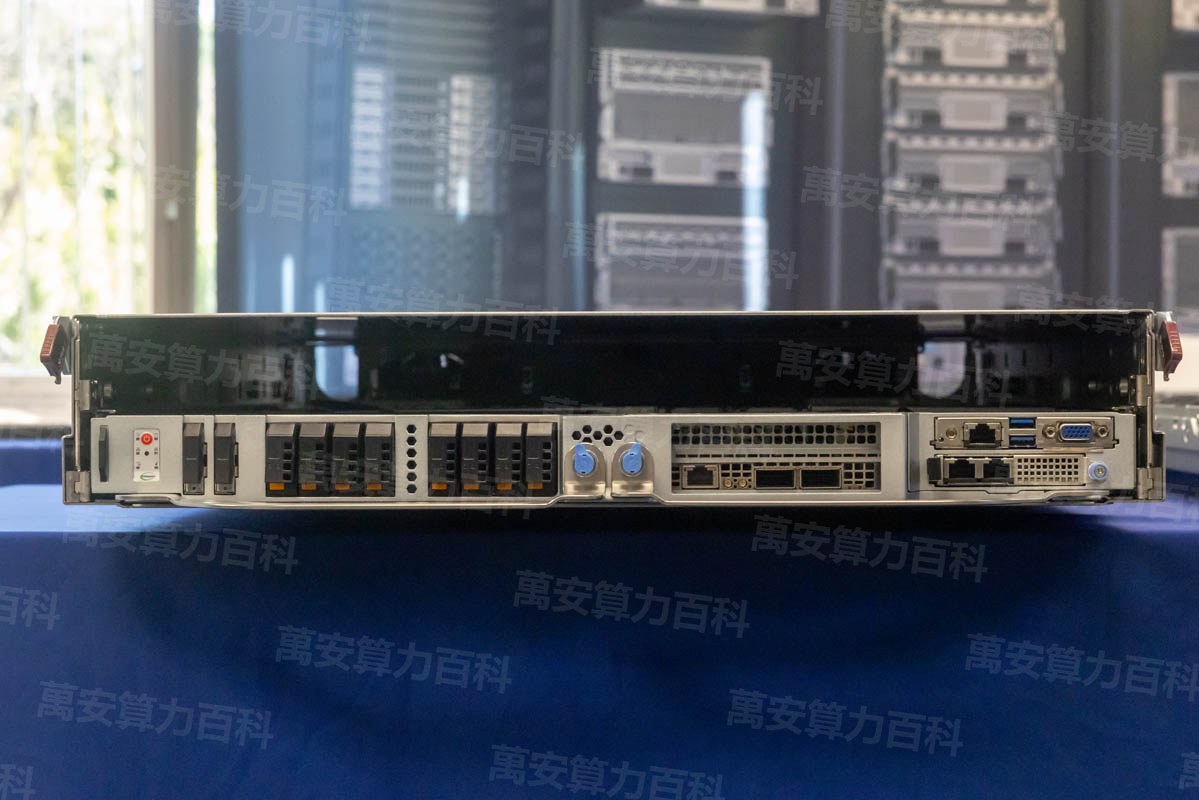
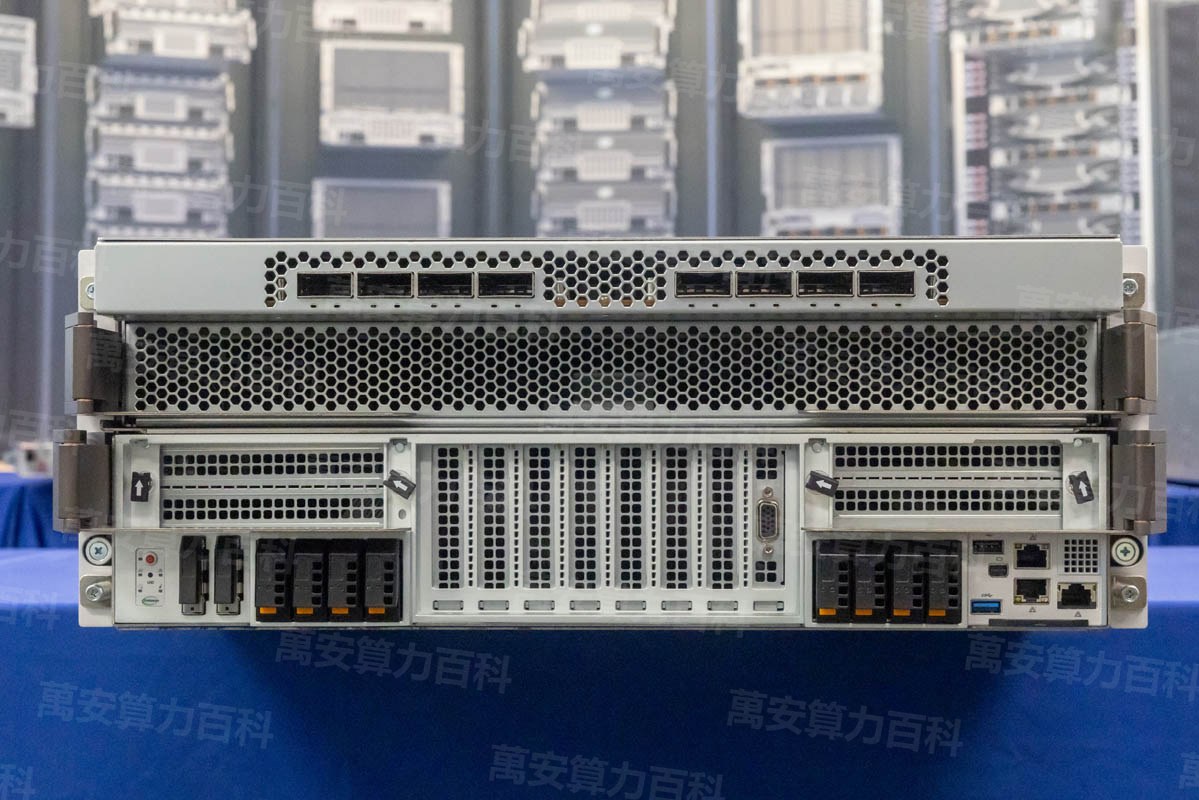
Le B300 est principalement vendu sous forme de systèmes complets et de plaques de base: système 8 GPU refroidi par air (NVL8), plaque 16 GPU refroidie par liquide (NVL16), et superpuce associée au CPU Grace (série GB300)[2]. Le système 8 GPU refroidi par air, qui ne nécessite pas de travaux d'adaptation en salle serveur liquide, est devenu le modèle Blackwell Ultra le plus disponible sur le marché du spot en Chine continentale.
Depuis le second semestre 2025, le B300 est en situation de pénurie en Chine continentale : la capacité de production est réservée par les grands fournisseurs cloud et les grands clients, aucun prix standard n'existe sur les canaux publics, et les prix spot dépassent nettement les tarifs affichés d'Amérique du Nord (données de marché dans le module « Bandeau marché » de cette fiche).[3]。
Cas d'usageFIT
AIXX Index(0–100) : estimation pondérée par cette base à partir des spécifications publiques — mémoire 40 % + interconnexion 30 % + écosystème 30 %, pondérations ajustées par scénario. 90+ niveau flagship · 75+ Excellent · 60+ utilisable · en dessous de 60, non pertinent. Méthode transparente et vérifiable, sans promesse de performance.
HistoriqueHISTORY
2022 — Lancement du H100, architecture Hopper de génération précédente, longtemps pilier du GPU datacenter.[1]
2024 — Annonce de l'architecture Blackwell, production du B200 ; lancement de la solution supernœud GB200 NVL72.
2025-03 — NVIDIA annonce à GTC le « Blackwell Ultra », c'est-à-dire le B300, avec expéditions prévues au second semestre 2025[1]。
Second semestre 2025 — Livraisons progressives des systèmes B300, début de circulation sur le marché spot chinois, prix opaque.
2026 — Le B300 NVL8 refroidi par air devient l'un des modèles haut de gamme les plus échangés sur le marché spot chinois ; la pénurie persiste.
Caractéristiques techniquesSPECIFICATIONS
| Élément | Spécifications |
|---|---|
| Cœur GPU | NVIDIA B300「Blackwell Ultra」SXM |
| Mémoire par carte | 288 Go HBM3e (2,3 To pour les 8 GPU) |
| Puissance de calcul FP4 | environ 1,1 PFLOPS (dense) / par carte |
| Interconnexion GPU-GPU | NVLink 5e génération · 1,8 To/s |
| Consommation de la carte (TBP/TGP) | 1100W |
| Formats de systèmes grand public | 8 GPU refroidi par air (NVL8) · 16 GPU refroidi par liquide (NVL16) · série superpuce GB300 |
| Génération précédente / équivalent | HGX H100 8 / HGX H200 8 (architecture Hopper) |
Spécifications selon la documentation publique officielle NVIDIA[1] ; les configurations complètes varient selon l'OEM et le lot.
Membres de la familleFAMILY
Systèmes et formats basés sur le B300 :
Comparatif des solutions de refroidissementAIR vs LIQUID
Sur la même plateforme B300, l'air et le liquide représentent deux voies de déploiement —la différence n'est pas la puissance, mais la salle serveur。


| Dimension | B300 NVL8 refroidi par air | HGX B300 NVL16 refroidi par liquide |
|---|---|---|
| Mode de refroidissement | Tout air (mur de ventilateurs) | Refroidissement liquide à plaque froide (CDU et circuits requis) |
| Exigences salle serveur | Salle existante suffisante, alimentation ~10 kW | Circuits liquides / CDU et évaluation de la charge au sol requis |
| Délai de déploiement | Quelques jours (mise en rack dès réception de l'alimentation) | Plusieurs semaines à mois (travaux inclus) |
| Échelle d'interconnexion GPU-GPU | 8 GPU NVLink full-mesh | 16 GPU NVLink full-mesh |
| Pour qui | Salles existantes, achats échelonnés, mise en service rapide | Salle liquide dédiée, clusters d'entraînement haute densité |
AIXX Index · déploiement en 4 dimensions
| Indice (0–100) | NVL8 air | NVL16 liquide |
|---|---|---|
| Facilité d'installation | 95 | 55 |
| Facilité de maintenance | 90 | 72 |
| Densité de performance | 70 | 95 |
| Espérance de vie | 82 | 88 |
Fond or clair = différence clé entre les deux formats. Les indices sont des estimations de cette base (méthode dans « À propos ») et varient selon les pondérations d'usage — l'AIXX Index global dépend du scénario, voir « Cas d'usage ».
Compatibilité des modèlesMODEL FIT
Ce tableau répond à une question :quelle taille de modèle cette machine peut-elle héberger. L'occupation mémoire est une estimation (poids ≈ nb de paramètres × octets/paramètre, FP8 ≈ 1 o/param, INT4 ≈ 0,5 o/param, avec marge pour le cache KV et les activations) ; en pratique, se référer aux mesures réelles.
| Modèle | Taille de paramètres | Estimation poids FP8 | Tient-il dans 2,3 To ? | AIXX Index | En une phrase |
|---|---|---|---|---|---|
| DeepSeek R1 | MoE 671B (37B actifs) | ≈690GB | Déploiement mono-nœud pleine capacité possible, marge confortable | 95 | L'un des véhicules privilégiés pour l'inférence de grands modèles |
| Kimi K2 | 1T MoE | ≈1.0TB | Oui, marge suffisante pour haute concurrence | 93 | Véhicule de classe transport pour MoE très grands |
| Qwen3 235B | 235B MoE | ≈235GB | Facile, plusieurs instances en parallèle | 96 | Pilier de production haute concurrence |
| Classe Llama 3 70B | 70B dense | ≈70GB | Une seule carte suffit | 88 | Multi-GPU surtout pour augmenter la concurrence |
| Modèles vidéo open source | Classe 10–20B | ≈10–20GB | Une seule carte suffit | 72 | Cartes selon le débit requis, large marge de performance |
Les spécifications des modèles évoluent vite ; tableau établi sur les données publiques d'octobre 2026. Mémoire MoE estimée avec l'ensemble des paramètres chargés. Niveaux : 90+ niveau flagship · 75+ Excellent · 60+ utilisable · en dessous de 60, non adapté. Une info obsolète ? Signalez-le viale canal de correctionsmerci.
GalerieGALLERY


Vidéo explicativeVIDEO
Machines réelles de la communauté · Source YouTubeCOMMUNITY HANDS-ON
La lecture directe peut être indisponible dans certaines régions
Logiciels et écosystèmeECOSYSTEM
Le premier kilomètre après l'achat : pilotes, frameworks et réseau d'interconnexion.
| Élément | Exigence / État des lieux |
|---|---|
| CUDA | 12.8 ou supérieur (minimum de la génération Blackwell) |
| Pilote | NVIDIA série 570 ou supérieure |
| Frameworks d'entraînement | PyTorch / TensorFlow supportent officiellement l'architecture Blackwell |
| Moteurs d'inférence | vLLM / SGLang / TensorRT-LLM sont tous adaptés |
| Accompagnement réseau | Un système 8 GPU exige une interconnexion 800G : cartes ConnectX-8 + commutation Quantum-800 / Spectrum-X |
| Système d'exploitation | Distributions Linux courantes (Ubuntu 22.04+ etc.) |
La pile logicielle évolue avec le temps, se référer aux publications officielles NVIDIA ; l'appariement pilote/CUDA est le piège le plus courant du premier kilomètre.
Achat pratique et pièges à éviterPROCUREMENT
Pour la réception d'équipements de grande valeur, la pratique du secteur consiste à poser ces sept questions d'emblée :
Trois arnaques courantes
Pour les équipements de grande valeur, faites appel à un inspecteur tiers et vérifiez la cohérence entre rapport d'inspection et numéros de série.
Comment faire un stress testBENCH TEST
Le « neuf » du marché spot doit être adossé à des mesures réelles. Tous les outils sont gratuits et publics : le pilote embarque nvidia-smi, la suite de diagnostic officielle NVIDIA DCGM, le burn-in open source gpu-burn, les tests d'interconnexion nccl-tests, les exemples fournis avec CUDA bandwidthTest. Les six cartes de référence ci-dessous précisent chacune « avec quoi / quel chiffre surveiller / qu'est-ce qui est conforme · excellent · fiasco » :
nvidia-smigpu-burn 3600 ou dcgmi diag -r 3 · 30–60 minutesbandwidthTest(échantillon intégré à CUDA)nccl-tests référence all_reducevLLM Lancer un vrai modèle en chargeNote de méthodologie : les seuils Conforme/Excellent sont établis par cette base selon les usages courants en ingénierie (bande passante en part de la valeur nominale, température selon les limites standard des datacenters) et seront progressivement calibrés avec les données réelles des rapports d'inspection ; ce tableau ne constitue aucun engagement de réception, seules les clauses contractuelles font foi.Les mesures du rapport d'inspection de cette base sont consignées selon les critères de ce tableau — NOT_EXECUTED signifie que le test n'a pas été effectué, et ce « non testé » est en soi une information importante.
Transport et livraisonLOGISTICS
| Étape | Points clés |
|---|---|
| Forme et poids | Châssis 8 cartes : environ 8U, poids total typiquement 100–170 kg (selon OEM et configuration, estimation) |
| Emballage | Caisse en bois d'origine avec supports antichoc, marquages anti-humidité et anti-basculement |
| Conformité transfrontalière | Produit soumis au contrôle des exportations : dédouanement conforme et licences d'importation sont des prérequis ; le transbordement via un tiers est à haut risque |
| Assurance | Assurer à hauteur de 100 % de la valeur est la pratique du secteur |
| Ordre de réception | Inspecter d'abord l'aspect et les scellés, recouper les numéros de série, puis seulement allumer — la vérification avant mise sous tension est incontournable |
OEM et variantesVENDORS
Même substrat HGX B300, mais chaque intégrateur se distingue par le format, le refroidissement, la densité et le service — commencez la sélection par ces différences :
| Intégrateur | Forme représentative | Points de différence | Pour qui |
|---|---|---|---|
| NVIDIA officiel | DGX B300 | Livraison intégrée officielle, pile logicielle complète et support de niveau entreprise | Pour un entraînement prêt à l'emploi et la caution du fabricant |
| Supermicro | Double format 8U refroidi par air / 4U refroidi par liquide | Gamme la plus complète, délais et rapport qualité-prix solides, garantie via canal | Datacenter en propre, recherche du meilleur rapport qualité-prix |
| Gigabyte | Série G893 (8U refroidi par air / 4U refroidi par liquide) | Jusqu'à 32 cartes par rack, orientation densité, configuration sur commande | Pour la densité par rack |
| Dell | PowerEdge XE9712 (refroidi par liquide au niveau rack) | Architecture NVL72 au niveau rack + réseau de service mondial de premier plan | Déploiement multinational, besoin d'un réseau de services |
| HPE / Lenovo | Intégration à la gamme entreprise (refroidi par liquide principalement) | Services entreprise et financement éprouvés, formats conservateurs | Clients entreprises, exploitation externalisée |
AIXX Index · comparaison de déploiement en quatre dimensionsAIXX INDEX
| Intégrateur | Facilité d'installation | Facilité de maintenance | Densité de performance | Espérance de vie |
|---|---|---|---|---|
| NVIDIA officiel | 95 | 90 | 80 | 85 |
| Supermicro | 88 | 82 | 85 | 82 |
| Gigabyte | 85 | 80 | 92 | 80 |
| Dell | 90 | 92 | 88 | 86 |
| HPE / Lenovo | 86 | 90 | 84 | 85 |
Les indices reposent sur les estimations de cette base (0–100 ; les dimensions correspondent aux quatre dimensions de déploiement de la section « cas d'usage »). Le fondement des scores = les écarts publics entre fabricants en matière de format, solution de refroidissement et réseau de service ; mis à jour au fil des vérifications sur machine réelle et des données par lot, sans valeur d'engagement d'achat. Les modèles concrets font foi selon les publications officielles de chaque fabricant.
Fiches terminologieGLOSSARY
Mémoire HBM3e
La mémoire à haute bande passante empilée à côté du GPU, c'est le « grenier » de l'entraînement IA. Le B300 offre 288 Go par carte, soit 2,3 To pour huit cartes.
Interconnexion NVLink
Le canal haut débit dédié entre cartes (cinquième génération, 1,8 To/s) fait coopérer huit GPU comme s'il n'y en avait qu'un.
SXM / NVL8
SXM désigne l'emballage GPU à montage direct sur carte (non enfichable) ; NVL8 désigne la forme à substrat à huit cartes totalement interconnectées, cœur de calcul des serveurs HGX.
Refroidissement liquide à plaque froide / CDU
La cold plate plaquée sur la puce capte la chaleur ; le liquide caloporteur l'évacue via des circuits, et la CDU (unité de distribution) gère répartition et circulation — l'équipement central d'une salle refroidie par liquide.
FP8
Format flottant 8 bits, précision dominante en inférence et entraînement IA ; pour estimer la VRAM d'un modèle, poids ≈ nombre de paramètres × 1 octet.
MoE — experts mixtes
Architecture de grands modèles à « activation clairsemée » : beaucoup de paramètres au total (ex. 671B pour DeepSeek R1), mais une seule partie activée à chaque inférence (37B). Au déploiement, tous les paramètres doivent néanmoins tenir en carte.
Limites et controversesLIMITS
- La boîte noire des prix et l'écart Chine–États-Unis: en Amérique du Nord, le prix public affiché est d'environ 497 000 $ soit ≈ 3,58 M¥ (collecté en octobre 2026), tandis que sur le marché spot de Chine continentale, les cotations tournent autour de 15 à 17 M¥— un écart de plus de 4x pour des machines de specs identiques, l'une des primes les plus extrêmes parmi les machines de calcul phares mondiales. Cette prime est triple : demande très supérieure à l'offre (les géants font la queue, la capacité priorise les têtes de file, les petits clients attendent longtemps), la loi américaine de blocage vers la Chine qui restreint l'offre officielle, et un monopole de fait de NVIDIA côté vendeur qui fixe les prix (Huawei et autres ont encore beaucoup de rattrapage à faire). Les surcoûts de réexpédition et primes de risque des circuits gris sont détaillés ci-dessous et dans la chronologie. Les attributions font débat ; cette base se contente d'enregistrer les données au fil des jours.
- Controverse sur l'allocation des capacités: la production priorise les grands clients alloués, et les délais d'attente des acheteurs de taille moyenne se comptent en années ; les « passe-droits payants » et les fuites par canaux internes sont régulièrement évoqués par la presse spécialisée, sans que NVIDIA n'ait jamais rendu ses règles d'allocation publiques — l'opacité de l'allocation est la plus grande controverse de gouvernance de cette gamme.
- Dérives de canal et risque de rénovation: le marché spot a connu des cas de B200 vendus comme B300, de VRAM gonflée, de cartes rénovées présentées comme neuves (selon les rapports d'organismes d'inspection ; note de cette base : toute machine « neuve » d'origine inconnue doit faire l'objet d'une vérification du numéro de série et d'un rapport d'inspection). La vérification de l'état et de l'authenticité est une étape obligatoire, pas une option.
- Consommation et barrière de déploiement: 1100 W par carte, environ 10 kW pour une machine à 8 cartes ; la plupart des salles existantes exigent des travaux d'alimentation et de refroidissement. En refroidi par air, le plafond thermique devient un plafond de performance ; en altitude et en ambiance chaude, un déclassement est nécessaire.
- Contrôle des exportations et variable géopolitique: le B300 est soumis au contrôle américain des exportations vers la Chine, et la légalité des circuits dépend des licences d'importation ; chaque ajustement de la politique de contrôle restructure directement l'échelle des prix (l'approbation du H200 pour la Chine en juillet 2026 a fait chuter les prix de la série H) — la géopolitique est la plus grande variable de risque unique de ce modèle.
Bande des prix du marchéMARKET DATA
| Date | Source | Région | Bande de prix de référence | Remarques |
|---|---|---|---|---|
| 2026-10-14 | Bande de marché de cette base | Chine continentale | 11,01 M¥ – 16,44 M¥ | Fourchette des prix en vente (73 offres) |
| 2026-10-06 | Instantané mesuré | Chine continentale | 10,72 M¥ – 15,02 M¥ | Intervalle des cotations en vente (30 sources) |
| 2026-10-07 | Instantané mesuré | Chine continentale | 10,72 M¥ – 15,02 M¥ | Intervalle des cotations en vente (31 sources) |
| 2026-10-08 | Instantané mesuré | Chine continentale | 10,72 M¥ – 15,02 M¥ | Intervalle des cotations en vente (31 sources) |
| 2026-10-09 | Instantané mesuré | Chine continentale | 10,72 M¥ – 15,06 M¥ | Intervalle des cotations en vente (33 sources) |
| 2026-10-04 | Prix d'ancrage | Chine continentale | 15,80 M¥ – 17,00 M¥ | Deux configurations A/B |
| 2026-10-05 | Tarif public des canaux à l'étranger | Amérique du Nord | À partir de 496 728 $ | Prix de départ public des distributeurs[3] |
| 2026-10 | Intervalle connu du marché | Chine continentale | 15 M¥ – 17 M¥ | Connu par les canaux, non vérifié par cette base |
Bandes en temps réel des autres marchésGLOBAL
| Marché | Bande en temps réel | Accès direct au hall |
|---|---|---|
| Singapour (SGD) | 1,34 M – 7,82 M | 83 offres › |
| Japon (JPY) | 140,9 M¥ – 909,02 M¥ | 81 offres › |
| Europe (EUR) | 640 k – 3,99 M | 80 offres › |
| Moyen-Orient (AED) | 3,09 M¥ – 18,71 M¥ | 76 offres › |
| Chine continentale (CNY) | 11,01 M¥ – 16,44 M¥ | 72 offres › |
| Zone dollar (USD) | 440 K¥ – 2,94 M¥ | 70 offres › |
Bandes en temps réel des ventes en cours par marché (prix en devise d'origine, rafraîchis au chargement de la page) ; cliquez sur « N cotations » pour accéder directement au hall d'échange avec la région présélectionnée.
Périmètre : à partir de juin 2025, bande estimée (rétro projetée d'après le rythme de mise sur marché du B300, l'intervalle traduit la variabilité état/configuration) ; à partir d'octobre 2026, instantanés mesurés journalisés (voir tableau ci-dessus) ; l'Amérique du Nord repose sur les tarifs convertis en RMB, la bande estimée rétroprojette le doublement de la rareté spot depuis la mise sur marché (environ x2), et octobre 2026 s'ancrage au tarif canal de 496 728 $. Source des données de prix de cette base : AIXX Exchange(mise en relation sans commission, sans participation aux transactions, ne connaît ni ne spéculé sur les prix de transaction — d'où sa neutralité). Les bandes estimées des autres marchés rétroprojettent un doublement approximatif depuis leur lancement, avec un point final ancré sur l'instantané mesuré du jour. La bande de prix de référence n'indique qu'une tendance, ne constitue aucune offre de transaction ; le prix réel est soumis au devis du vendeur.
Chronologie des étapes de prixMILESTONES
Actualités et événements associésTIMELINE
FAQFAQ
Oui. Les poids FP8 pèsent environ 690 Go, et les 2,3 To de mémoire totale permettent un déploiement complet en mono-machine avec une marge confortable (voir « Compatibilité des modèles »).
La version refroidi par air NVL8 est justement conçue pour les salles existantes : une alimentation de l'ordre de 10 kW suffit ; la version refroidi par liquide exige une infrastructure adaptée (voir « Comparatif des formats de refroidissement »).
Vérifier le marquage sérigraphié et le rapport du firmware officiel, et contre-vérifier le numéro de série via un canal indépendant ; les deux générations se ressemblent beaucoup, les photos seules ne suffisent pas (voir « Bonnes pratiques d'achat et pièges à éviter »).
D'abord, la demande dépasse largement l'offre — les géants se disputent les stocks, la capacité de production va en priorité aux grands clients et les acheteurs individuels font la queue longtemps ; ensuite, le gouvernement américain a promulgué des lois d'interdiction extrêmement strictes à l'encontre de la Chine, rendant l'achat impossible par les canaux officiels ; enfin, NVIDIA domine seul le marché avec une avance technologique abyssale (Huawei et d'autres ont encore beaucoup de rattrapage à faire). Ces trois facteurs cumulés, l'écart de prix au comptant dépasse 4 fois (voir « Limites et controverses » et la bande de marché, base 2026-10).
Oui, en production et en pénurie : la capacité va en priorité aux grands clients, et les délais d'attente pour les petits acheteurs se comptent en années.
Fiches associéesSEE ALSO
Comparaison des modèles et sélectionCOMPARE
RéférencesREFERENCES
- Site officiel NVIDIA — page produit Blackwell Ultra / HGX B300 https://www.nvidia.com/en-us/data-center/hgx/
- NVIDIA Newsroom — Annonce de la plateforme Blackwell Ultra https://nvidianews.nvidia.com/news/nvidia-blackwell-ultra-ai…
- Données de bande de cours — AIXX AIXX Pedia (offres en vente sur la plateforme et fourchettes de canal, mise à jour quotidienne) /hall.html
- Communiqué du Département de la Justice américain — California Man Arrested for Smuggling More Than $300 Million in Export-Controlled Computer Servers (2026-10) https://www.justice.gov/opa/pr/california-man-arrested-smugg…