AIXX Pedia › Ficha de modelo › B300

B300
Descripción generalOVERVIEW
B300(nombre completo NVIDIA B300, perteneciente a la serie «Blackwell Ultra») es la GPU de centro de datos[1]que NVIDIA lanzó en 2025, una versión mejorada del B200 de 2024. La memoria de la tarjeta 288GB HBM3e, más del triple que la generación anterior H100 (80GB); potencia de inferencia FP4 de aproximadamente 1.1 PFLOPS(denso); consumo de la tarjeta (TBP/TGP) 1100W[1]。
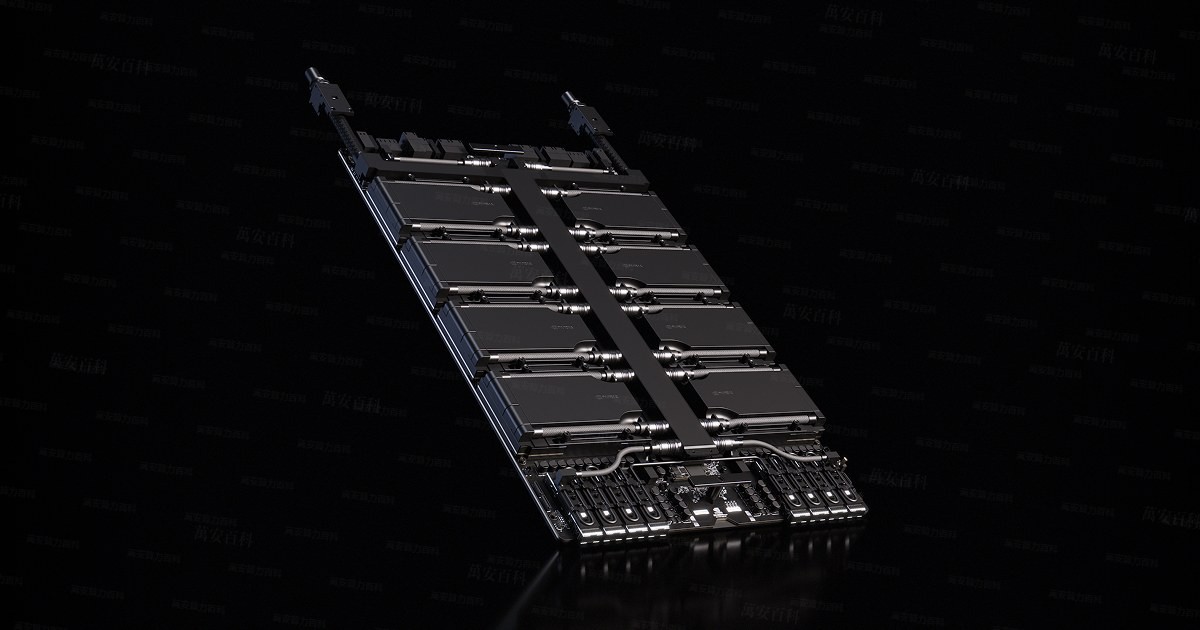
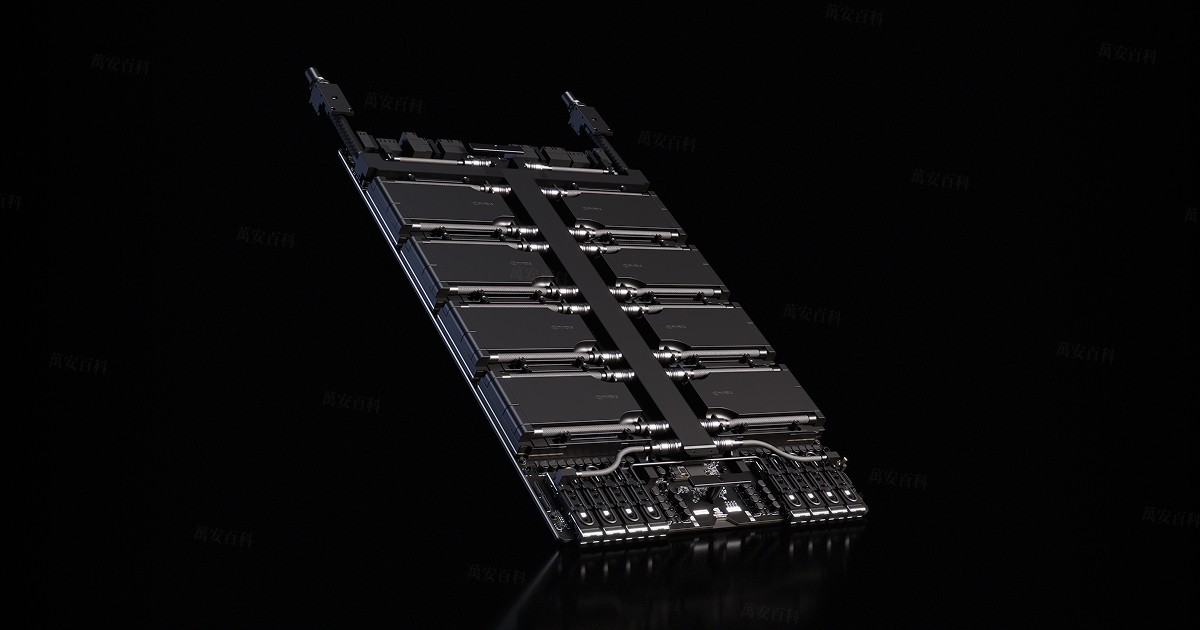
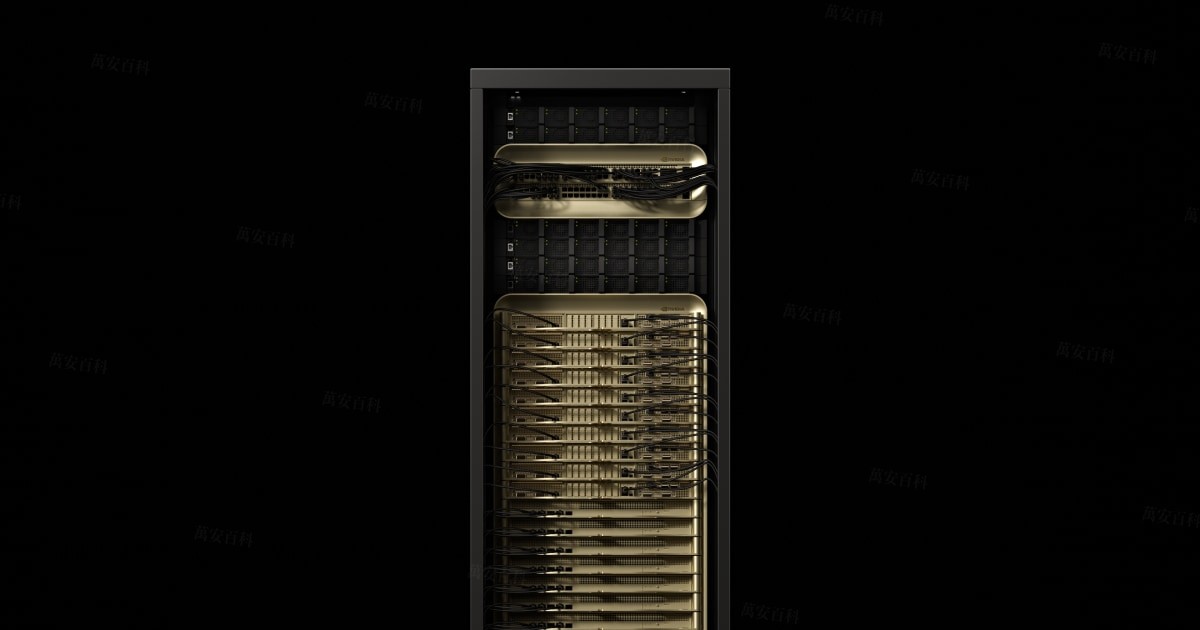
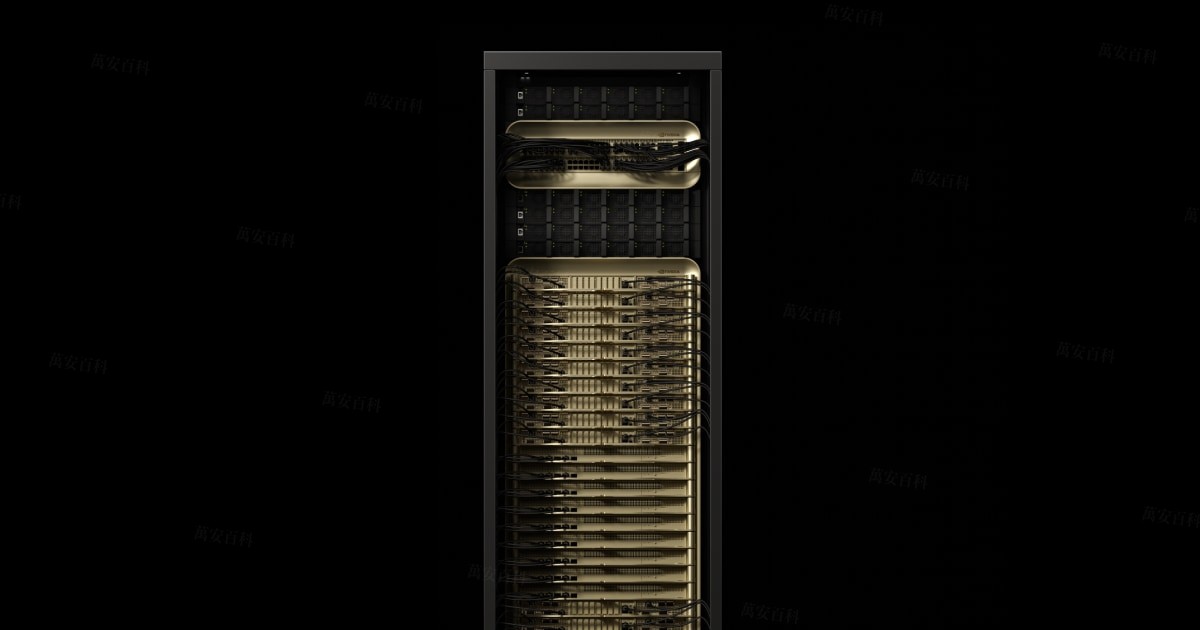
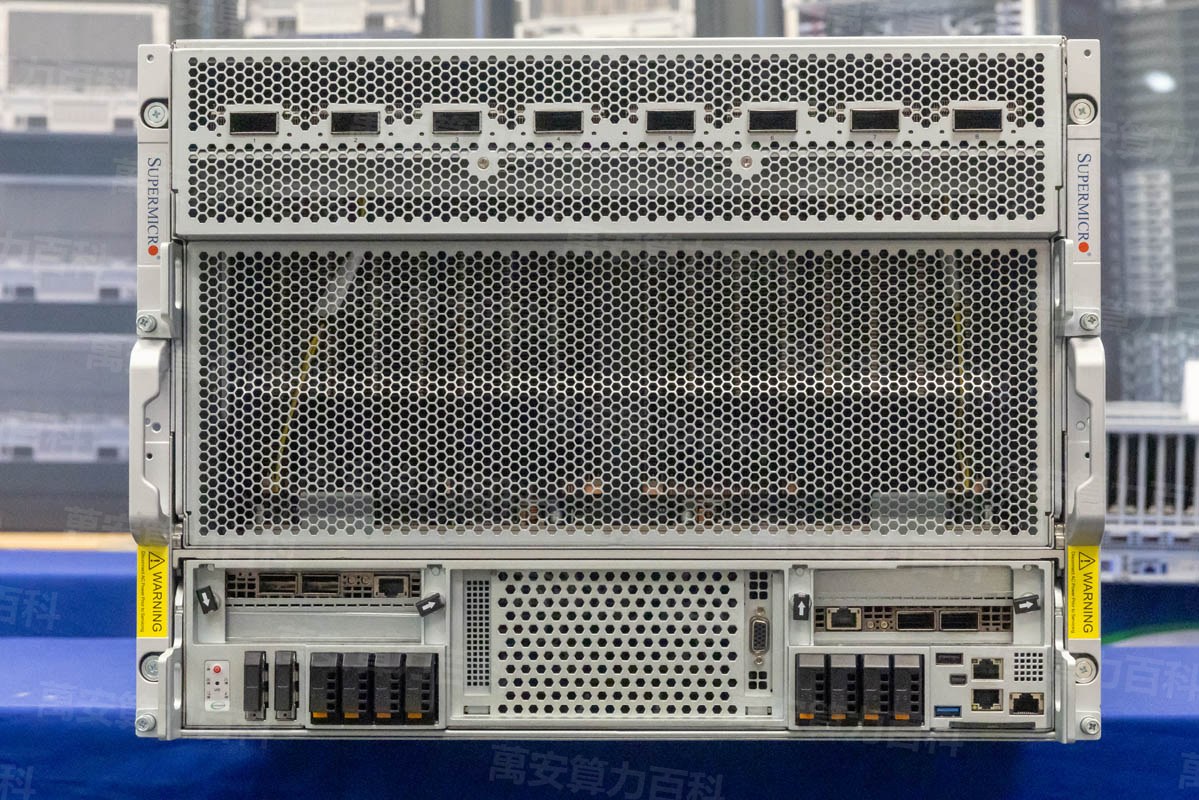
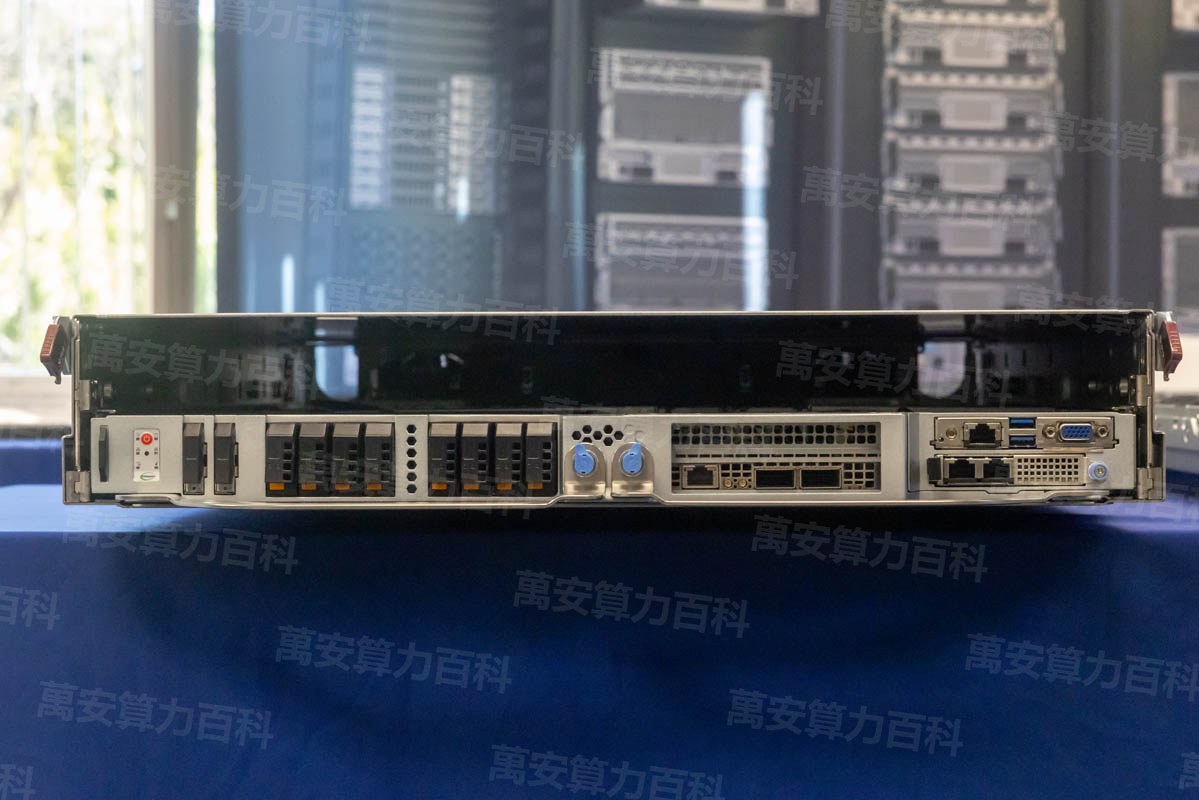
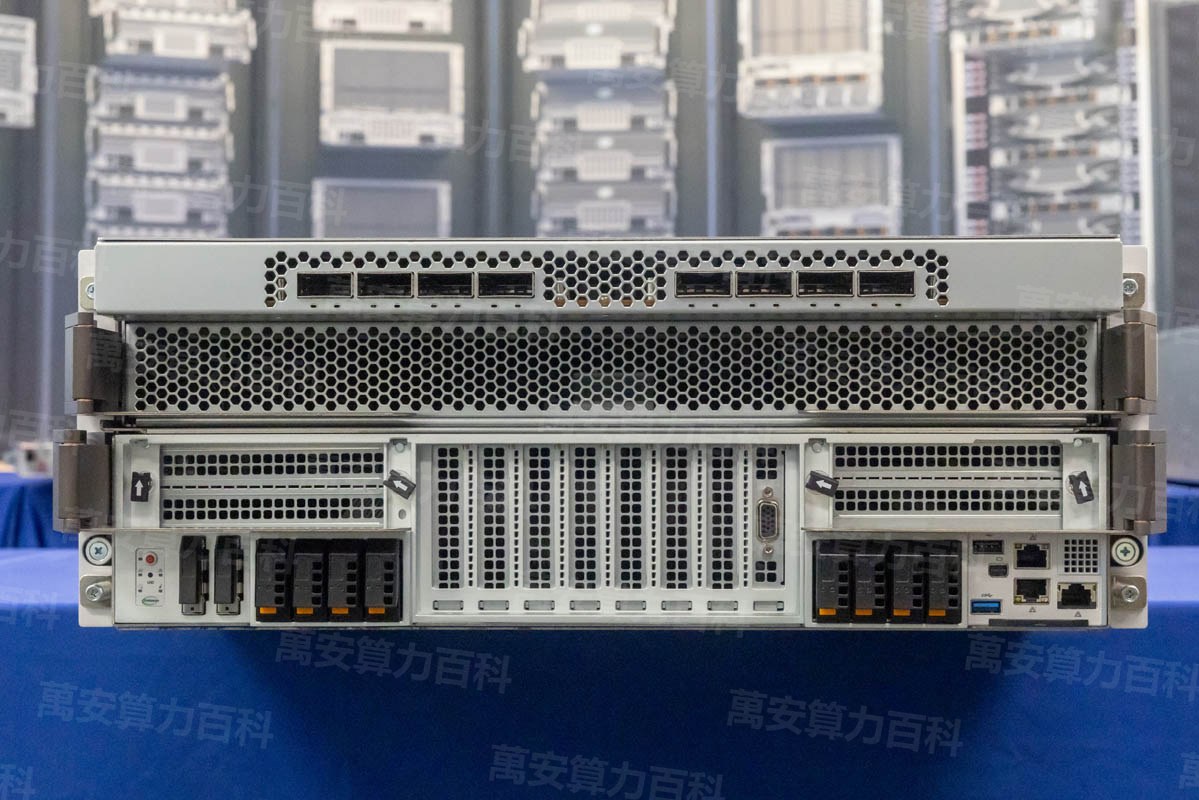
El B300 se vende principalmente en formatos de sistema completo y sustrato: sistema refrigerado por aire de 8 tarjetas (NVL8), sustrato refrigerado por líquido de 16 tarjetas (NVL16), y el formato de superchip combinado con CPU Grace (serie GB300)[2]. De ellos, el sistema de 8 tarjetas refrigerado por aire se ha convertido en el modelo Blackwell Ultra con mayor circulación en el mercado de stock de China continental, al no requerir la adaptación del data center a refrigeración líquida.
Desde la segunda mitad de 2025, el B300 se encuentra en escasez de oferta en China continental: la capacidad de producción está reservada por los grandes proveedores de nube y clientes clave, no existe precio estándar en canales públicos y el precio del stock supera significativamente las cotizaciones de los canales de Norteamérica (datos de mercado en el módulo «Franja de mercado» de esta ficha)[3]。
Escenarios de usoFIT
AIXX Index(0–100): esta base lo estima ponderando especificaciones públicas: memoria 40% + interconexión 30% + ecosistema 30%, ajustando pesos según el escenario. 90+ tope de gama · 75+ Excelente · 60+ utilizable · menos de 60, no aplicable. Metodología transparente y verificable; no constituye una promesa de rendimiento.
TrayectoriaHISTORY
2022 — Se lanza el H100 de arquitectura Hopper de la generación anterior, que ocupa durante años la posición principal en GPUs de centro de datos.[1]
2024 — Se presenta la arquitectura Blackwell y comienza la producción en masa del B200; se lanza la solución de supernodo GB200 NVL72.
2025-03 — NVIDIA presenta en GTC el «Blackwell Ultra», es decir, el B300, y anuncia su envío para la segunda mitad de 2025.[1]。
Segunda mitad de 2025 — Los sistemas B300 se entregan progresivamente; el canal de stock en China continental comienza a moverse y los precios se vuelven opacos.
2026 — El sistema refrigerado por aire B300 NVL8 se convierte en uno de los equipos de cómputo de gama alta con mayor volumen de transacciones en el mercado de stock de China continental; la escasez continúa.
Especificaciones técnicasSPECIFICATIONS
| Concepto | Especificaciones |
|---|---|
| Núcleo GPU | NVIDIA B300「Blackwell Ultra」SXM |
| Memoria por tarjeta (TBP/TGP) de memoria | 288GB HBM3e (2.3TB en total con ocho tarjetas) |
| Potencia de inferencia FP4 | ≈ 1.1 PFLOPS (denso) / por tarjeta |
| Interconexión GPU-GPU | NVLink de quinta generación · 1.8TB/s |
| Consumo de la tarjeta (TBP/TGP) | 1100W |
| Formatos de sistema habituales | 8 tarjetas refrigerado por aire (NVL8) · 16 tarjetas refrigerado por líquido (NVL16) · serie de superchips GB300 |
| Generación anterior / competencia directa | HGX H100 8 / HGX H200 8 (arquitectura Hopper) |
Las especificaciones se basan en la información pública oficial de AIXX[1]; la configuración del sistema varía según el OEM y el lote.
Miembros de la familiaFAMILY
Sistemas y formatos basados en el B300:
Comparativa de formatos de refrigeraciónAIR vs LIQUID
Sobre la misma plataforma B300, refrigerado por aire y refrigerado por líquido son dos rutas de despliegue:la diferencia no está en la potencia, sino en el data center。


| Dimensión | B300 NVL8 refrigerado por aire | HGX B300 NVL16 refrigerado por líquido |
|---|---|---|
| Método de refrigeración | Totalmente refrigerado por aire (muro de ventiladores del chasis) | Refrigeración líquida por placa fría (requiere CDU y tuberías) |
| Requisitos del data center | Sala existente es suficiente, alimentación de nivel 10kW | Requiere tuberías de refrigeración líquida / soporte de CDU y evaluación de carga |
| Tiempo de despliegue | Días (basta con suministro eléctrico para el rack) | Mes a nivel de distrito (incluye remodelación de sala) |
| Escala de interconexión GPU-GPU | 8 GPU con NVLink totalmente conectadas | 16 GPU con NVLink totalmente conectadas |
| Para quién es | Salas existentes, compras por etapas, puesta en marcha rápida | Sala propia refrigerada por líquido, clústeres de entrenamiento de alta densidad |
AIXX Index · Despliegue en cuatro dimensiones
| Índice (0–100) | NVL8 refrigerado por aire | NVL16 refrigerado por líquido |
|---|---|---|
| Facilidad de instalación | 95 | 55 |
| Comodidad de mantenimiento | 90 | 72 |
| Densidad de rendimiento | 70 | 95 |
| Expectativa de vida útil | 82 | 88 |
Fondo dorado claro = diferencias clave entre ambas formas. El índice sigue la metodología estimada de esta biblioteca (ver «Acerca de esta biblioteca») y varía según los pesos de uso: el AIXX Index integral depende del escenario, véase «Escenarios aplicables».
Adaptación de modelosMODEL FIT
Esta tabla responde a una pregunta:qué tamaño de modelo puede alojar esta máquina. La ocupación de memoria de vídeo es una estimación (pesos ≈ parámetros × bytes por parámetro, FP8 ≈ 1B/par, INT4 ≈ 0.5B/par, dejando además margen para la caché KV y las activaciones); el despliegue real debe basarse en mediciones.
| Modelo | Escala de parámetros | Estimación de pesos en FP8 | ¿Cabe en 2.3 TB? | AIXX Index | En una frase |
|---|---|---|---|---|---|
| DeepSeek R1 | MoE de 671B (37B activos) | ≈690GB | Despliegue completo en un solo nodo con amplio margen | 95 | Una de las plataformas preferidas para inferencia de grandes modelos |
| Kimi K2 | 1T MoE | ≈1.0TB | Cabe, con margen para alta concurrencia | 93 | Vehículo de capacidad para MoE ultragrande |
| Qwen3 235B | 235B MoE | ≈235GB | Con holgura, permite múltiples instancias en paralelo | 96 | Caballo de batalla para producción de alta concurrencia |
| Nivel Llama 3 70B | 70B denso | ≈70GB | Una sola GPU basta | 88 | Varias GPU sirven sobre todo para escalar concurrencia |
| Modelos de vídeo de código abierto | Nivel 10–20B | ≈10–20GB | Una sola GPU basta | 72 | Configure GPU según el rendimiento requerido; gran redundancia |
Las especificaciones de los modelos evolucionan rápido; esta tabla se elaboró con información pública de octubre de 2026; la memoria de los modelos MoE se estima con todos los parámetros cargados en GPU. Escalas: 90+ nivel insignia · 75+ Excelente · 60+ utilizable · bajo 60 no recomendado. ¿Detectó algo desactualizado? Avísenos porcanal de correccionescorrecciones.
Galería de imágenesGALLERY


Vídeo explicativoVIDEO
Equipos reales de la comunidad · Fuente YouTubeCOMMUNITY HANDS-ON
Es posible que no se pueda reproducir en algunas regiones
Software y ecosistemaECOSYSTEM
El primer kilómetro tras comprar las GPU: drivers, frameworks y red de interconexión.
| Concepto | Requisito / estado actual |
|---|---|
| CUDA | 12.8 o superior (requisito mínimo para la generación Blackwell) |
| Controlador | Serie NVIDIA 570 o superior |
| Frameworks de entrenamiento | Soporte oficial de la arquitectura Blackwell en PyTorch / TensorFlow |
| Motores de inferencia | vLLM / SGLang / TensorRT-LLM ya adaptados |
| Red complementaria | Equipos de 8 tarjetas requieren interconexión de 800G: NIC ConnectX-8 + conmutación Quantum-800 / Spectrum-X |
| Sistema operativo | Distribuciones Linux convencionales (Ubuntu 22.04+, entre otras) |
Las versiones del stack de software evolucionan con el tiempo; prevalece lo publicado oficialmente por NVIDIA. La compatibilidad entre el driver y CUDA es el primer tropiezo más habitual.
Consejos de compra y errores a evitarPROCUREMENT
En la inspección de equipos de alto valor, la práctica habitual del sector es plantear primero estas siete preguntas:
Tres fraudes frecuentes
En compras de equipos de alto valor se recomienda recurrir a una inspección por terceros y verificar la coherencia entre el informe y el número de serie.
Cómo realizar pruebas de estrésBENCH TEST
El «nuevo» del mercado de stock debe respaldarse con pruebas reales. Todas las herramientas son gratuitas y públicas: el driver incluye de serie nvidia-smi, la suite de diagnóstico oficial de NVIDIA DCGM, la Prueba de burn-in de código abierto gpu-burn, las pruebas de interconexión nccl-tests y los ejemplos incluidos en CUDA bandwidthTest. A continuación, seis fichas de casos con todo lo necesario: «con qué probar / qué cifra vigilar / qué se considera Aprobado, Excelente o Fiasco»:
nvidia-smigpu-burn 3600 o dcgmi diag -r 3 · 30–60 minutosbandwidthTest(muestras incluidas en CUDA)nccl-tests Benchmark all_reducevLLM Ejecutar un modelo real con cargaNota de criterio: las líneas de Aprobado/Excelente de esta tabla fueron elaboradas según criterios de ingeniería de uso común (el ancho de banda como porcentaje del valor nominal, la temperatura según el límite habitual en centros de datos) y se irán calibrando progresivamente con los datos del ancho de banda medido en los informes de inspección acumulados; esta tabla no constituye ningún compromiso de aceptación, y lo específico está sujeto a lo acordado en el contrato.Las mediciones del informe de inspección de esta base de datos se registran según el criterio de esta tabla: NOT_EXECUTED indica que la prueba no se realizó, y el «no testeado» en sí también es información relevante.
Transporte y entregaLOGISTICS
| Etapa | Puntos clave |
|---|---|
| Formato y peso | Sistema completo de 8 tarjetas: aprox. 8U; peso total habitual de 100–170kg (según OEM y configuración, estimación) |
| Embalaje | Caja de madera original con soportes antivibración, señalización antihumedad y anti-volcado |
| Cumplimiento transfronterizo | Objeto de controles de exportación: el despacho aduanero conforme y las licencias de importación son requisitos previos; el transbordo por terceros países es una práctica de alto riesgo |
| Seguro | La práctica habitual del sector es asegurar por el 100% del valor de la mercancía |
| Orden de llegada | Primero inspeccione el aspecto exterior y los precintos, verifique los números de serie y solo entonces encienda el equipo: la comprobación previa a la energización no es opcional |
OEM y variantesVENDORS
Sobre una misma base HGX B300, cada fabricante se diferencia en factor de forma, refrigeración, densidad y servicio: al elegir, mire primero las diferencias:
| Fabricante de sistemas | Factor de forma representativo | Puntos de diferencia | Para quién es |
|---|---|---|---|
| NVIDIA (oficial) | DGX B300 | Entrega integral oficial del fabricante, pila de software completa y soporte de nivel empresarial | Para quien quiere entrenar nada más desembalar y respaldo del fabricante original |
| Supermicro | Doble formato: 8U refrigerado por aire / 4U refrigerado por líquido | La gama más completa en formatos, con plazos de entrega y relación calidad-precio sólidos, garantía de canal | Centro de datos propio, se busca relación calidad-precio |
| Gigabyte | Serie G893 (8U refrigerado por aire / 4U refrigerado por líquido) | Hasta 32 GPUs por rack, orientado a densidad, configuración bajo pedido | Quien prioriza la densidad por rack |
| Dell | PowerEdge XE9712 (refrigerado por líquido a nivel de rack) | Arquitectura NVL72 a nivel de rack + red de servicio global de primer nivel | Despliegues multinacionales, se necesita red de servicios |
| HPE / Lenovo | Integración en la línea de productos empresariales (predomina el refrigerado por líquido) | Servicios empresariales y soluciones financieras consolidadas, formatos conservadores | Clientes corporativos, operación externalizada |
AIXX Index · Comparativa de despliegue en cuatro dimensionesAIXX INDEX
| Fabricante de sistemas | Facilidad de instalación | Comodidad de mantenimiento | Densidad de rendimiento | Expectativa de vida útil |
|---|---|---|---|---|
| NVIDIA (oficial) | 95 | 90 | 80 | 85 |
| Supermicro | 88 | 82 | 85 | 82 |
| Gigabyte | 85 | 80 | 92 | 80 |
| Dell | 90 | 92 | 88 | 86 |
| HPE / Lenovo | 86 | 90 | 84 | 85 |
El índice sigue el criterio de estimación de esta biblioteca (0–100, con dimensiones coincidentes con las cuatro de despliegue de «Escenarios de uso»); la base de puntuación son las diferencias públicas de cada fabricante en formato, solución de refrigeración y red de servicios, y se actualiza con verificaciones en unidades reales y datos por lote; no constituye un compromiso de compra. Los modelos específicos se rigen por las publicaciones oficiales de cada fabricante.
Fichas de términosGLOSSARY
Memoria HBM3e
Memoria de alto ancho de banda apilada junto a la GPU: es el «granero» del entrenamiento de IA. Una tarjeta B300 ofrece 288 GB y ocho tarjetas suman 2,3 TB.
Interconexión NVLink
Canal dedicado de alta velocidad entre tarjetas (quinta generación, 1,8 TB/s) que permite a las ocho GPU trabajar en coordinación como si fueran una sola.
SXM / NVL8
SXM es el encapsulado de montaje directo de la GPU en placa (no tarjetas extraíbles); NVL8 designa el formato de base con ocho tarjetas totalmente interconectadas, el núcleo de cómputo de los servidores HGX.
Refrigeración líquida por placa fría / CDU
La placa fría absorbe el calor pegada al chip, el líquido refrigerante lo transporta por tuberías y la CDU (unidad de distribución) se encarga de repartirlo y hacerlo circular: el equipamiento esencial de una sala refrigerada por líquido.
FP8
Formato de coma flotante de 8 bits, la precisión dominante en inferencia y entrenamiento de IA; al estimar la memoria de un modelo, los pesos ≈ número de parámetros × 1 byte.
MoE (mezcla de expertos)
Arquitectura de modelos grandes con «activación dispersa»: muchísimos parámetros totales (como los 671B de DeepSeek R1), pero en cada inferencia solo se activa una parte (37B). Al desplegar, todos los parámetros deben residir igualmente en las tarjetas.
Limitaciones y controversiasLIMITS
- La caja negra de los precios y la brecha entre EE. UU. y China: en canales norteamericanos el precio público de lista ronda los $497.000 (≈ 3,58 millones de CNY, capturado en octubre de 2026), mientras que el stock en China continental se ofrece habitualmente entre 15 y 17 millones de CNY——La diferencia de precio entre equipos completos de la misma especificación supera 4 veces, siendo uno de los casos de sobreprecio más extremos entre las principales máquinas de cómputo del mundo. El sobreprecio es una triple superposición: demanda muy superior a la oferta (los gigantes hacen fila para comprar, la capacidad de producción prioriza a los grandes clientes, los clientes minoristas esperan largas colas), el endurecimiento de la legislación estadounidense que prohíbe el suministro oficial a China, y el poder de fijación de precios de un vendedor casi monopolista como NVIDIA (Huawei y otros aún tienen un amplio margen de catch-up); los recargos de reexportación y la prima de riesgo de los canales grises se detallan en el siguiente punto y en la cronología. Las partes no se ponen de acuerdo en las causas; esta base de datos solo registra los datos día a día.
- Disputa por la asignación de capacidad: la capacidad se prioriza para los grandes clientes ya asignados, y los plazos de espera de compradores medianos y pequeños se miden en años; los medios del sector mencionan repetidamente el «colarse pagando más» y las fugas por canales internos, y NVIDIA nunca ha hecho públicas sus reglas de asignación —la falta de transparencia en la asignación es la mayor controversia de gobernanza de esta línea de producto.
- Caos de canal y riesgo de reacondicionados: en el mercado de stock existen casos de B200 vendidos como B300, capacidades de memoria falseadas y tarjetas reacondicionadas pasadas por nuevas (según avisos de organismos de inspección; nota de esta biblioteca: cualquier equipo «nuevo» de origen dudoso debe someterse a verificación de número de serie e informe de inspección). Verificar el estado y la autenticidad es un trámite necesario de la compra, no una opción.
- Consumo y barreras de despliegue: 1100 W por tarjeta y del orden de 10 kW por equipo de 8 tarjetas; las salas existentes suelen requerir mejoras eléctricas y de refrigeración. En el formato refrigerado por aire, el techo térmico es el techo de rendimiento, y en grandes altitudes o ambientes calurosos hay que operar con reducción de potencia.
- Control de exportaciones y variable geopolítica: el B300 está sujeto al control de exportaciones estadounidense hacia China, y la legalidad del canal depende de licencias de importación; cada ajuste de la política de control reconfigura directamente el sistema de precios (la aprobación del H200 para su entrada en China en julio de 2026 provocó un desplome de los precios de la serie H) —la política geopolítica es la mayor variable de riesgo aislada de este modelo.
Franja de mercadoMARKET DATA
| Fecha | Criterio | Región | Banda de Precio de referencia | Observaciones |
|---|---|---|---|---|
| 2026-10-14 | Banda de mercado de esta biblioteca | China continental | ¥11,01 M – 16,44 M | Rango de precios en venta (73 ofertas) |
| 2026-10-06 | Instantánea medida | China continental | 10,72 – 15,02 millones de CNY | Rango de cotizaciones en venta (30 puntos) |
| 2026-10-07 | Instantánea medida | China continental | 10,72 – 15,02 millones de CNY | Rango de cotizaciones en venta (31 puntos) |
| 2026-10-08 | Instantánea medida | China continental | 10,72 – 15,02 millones de CNY | Rango de cotizaciones en venta (31 puntos) |
| 2026-10-09 | Instantánea medida | China continental | 10,72 – 15,06 millones de CNY | Rango de cotizaciones en venta (33 puntos) |
| 2026-10-04 | Precio ancla | China continental | ¥15,80 M – 17,00 M | Configuraciones A/B |
| 2026-10-05 | Precio de lista en canales de ultramar | Norteamérica | Desde $496.728 | Precio de salida público del canal[3] |
| 2026-10 | Rango conocido del mercado | China continental | ¥15,00 M – 17,00 M | Según fuentes del canal, sin verificación por AIXX AIXX Pedia |
Bandas en tiempo real de otros mercadosGLOBAL
| Mercado | Banda en tiempo real | Ir a la sala |
|---|---|---|
| Singapur (SGD) | 1,34 M – 7,82 M | 83 ofertas › |
| Japón (JPY) | 141,09 M – 909,02 M | 81 ofertas › |
| Europa (EUR) | 0,64 M – 3,99 M | 80 ofertas › |
| Oriente Medio (AED) | 3,09 M – 18,71 M | 76 ofertas › |
| China continental (CNY) | 11,01 M – 16,44 M | 72 cotizaciones › |
| Zona dólar (USD) | 440 k – 2,94 M | 70 ofertas › |
Bandas en venta en tiempo real por mercado (en la moneda original, actualizadas al cargar la página); pulsa «N cotizaciones» para ir directo a la sala de trading con la región ya seleccionada.
Nota: desde 06-2025 es una banda estimada (retroextrapolada según el ritmo de entrada oficial del B300 al mercado, con ancho de banda sujeto a variaciones de estado/configuración); desde 10-2026 son instantáneas medidas registradas día a día (véase la tabla anterior); Norteamérica se convierte del precio de lista del canal a RMB, y la banda estimada se retroextrapola según la subida por escasez de stock desde su lanzamiento (aprox. el doble), anclada en 10-2026 al precio de lista de canal de $496.728. Fuente de los datos de precios de AIXX AIXX Pedia:AIXX Exchange(intermediación sin comisión, no participa en transacciones y no conoce ni especula con los precios de cierre, de ahí su neutralidad). Las bandas estimadas de otros mercados se retroextrapolan con un aumento aproximado del doble desde su lanzamiento, anclando el punto final en la instantánea medida en venta de ese día. La banda de precio de referencia es solo para orientación de tendencia, no constituye ninguna oferta de transacción; el precio real está sujeto a la cotización del vendedor.
Hitos de precios claveMILESTONES
Novedades y eventos relacionadosTIMELINE
Preguntas frecuentesFAQ
Sí. Los pesos en FP8 ocupan unos 690 GB, y los 2,3 TB de memoria total permiten un despliegue completo en un solo nodo con holgura de sobra (véase «Compatibilidad de modelos»).
La variante de refrigerado por aire en formato NVL8 está pensada precisamente para salas existentes: basta una alimentación de nivel 10 kW; la variante refrigerado por líquido requiere instalaciones específicas (véase «Comparativa de formatos de disipación»).
Verifica el serigrafiado y el informe del firmware oficial, y contrasta el número de serie por canales independientes; ambas generaciones son muy parecidas exteriormente y las fotos por sí solas no son fiables (véase «Prácticas de compra y cómo evitar trampas»).
Primero, la demanda supera con mucho la oferta: los gigantes hacen fila por hacerse con unidades, la capacidad de producción va prioritariamente a los grandes clientes y los compradores minoristas esperan largos turnos. Segundo, el Gobierno de EE. UU. ha promulgado leyes de prohibición sumamente estrictas hacia China, y no se puede comprar por canales oficiales. Tercero, NVIDIA domina el mercado con una ventaja tecnológica abismal (Huawei y otros aún tienen un largo camino por recorrer). Con estos tres factores sumados, la diferencia de precio en el mercado spot supera las 4 veces (véanse «Limitaciones y controversias» y la franja de mercado, cifras de 2026-10).
Sigue en producción con demanda insatisfecha: la capacidad se destina prioritariamente a los grandes clientes, y los ciclos de espera para compradores medianos y pequeños se miden en años.
Fichas relacionadasSEE ALSO
Comparativa de modelos y selecciónCOMPARE
ReferenciasREFERENCES
- Sitio oficial de NVIDIA — Página de producto Blackwell Ultra / HGX B300 https://www.nvidia.com/en-us/data-center/hgx/
- NVIDIA Newsroom — Lanzamiento de la plataforma Blackwell Ultra https://nvidianews.nvidia.com/news/nvidia-blackwell-ultra-ai…
- Franja de mercado — AIXX Compute Exchange (precios de venta en esta plataforma e intervalos conocidos de canal, actualización diaria) /hall.html
- Departamento de Justicia de EE. UU. — California Man Arrested for Smuggling More Than $300 Million in Export-Controlled Computer Servers (2026-10) https://www.justice.gov/opa/pr/california-man-arrested-smugg…