AIXX Pedia › Modelleintrag › B300

B300
Überblick OVERVIEW
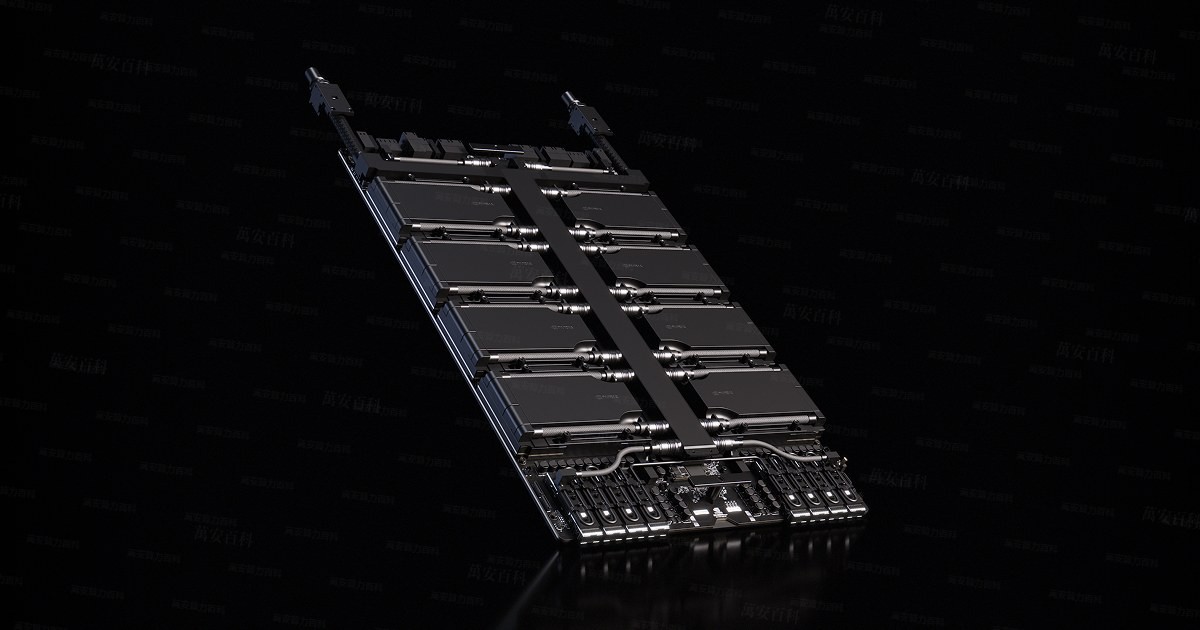
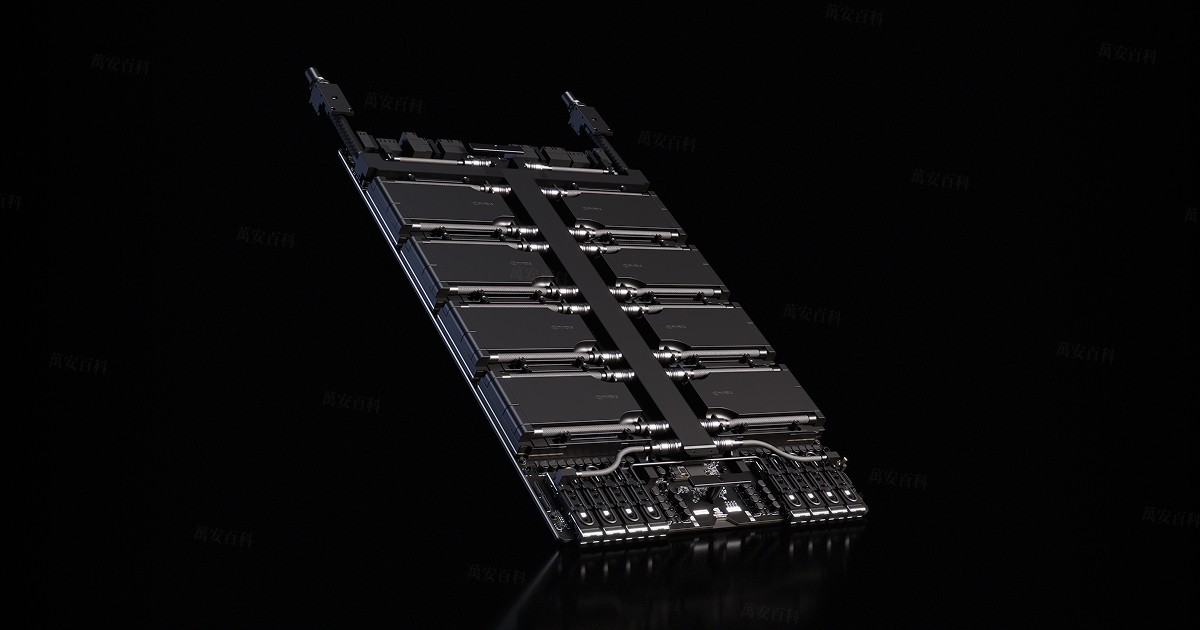
B300 (vollständig NVIDIA B300, Teil der Serie「Blackwell Ultra」) ist eine von NVIDIA 2025 vorgestellte Datacenter-GPU[1]und die aufgewertete Version des B200 aus dem Jahr 2024. Board-Power (TBP/TGP)-Speicher pro Karte 288GB HBM3e , mehr als dreimal so viel wie beim Vorgänger H100 (80 GB); FP4-Inferenzleistung rund 1.1 PFLOPS (dicht), Board-Power (TBP/TGP) 1100W[1]。
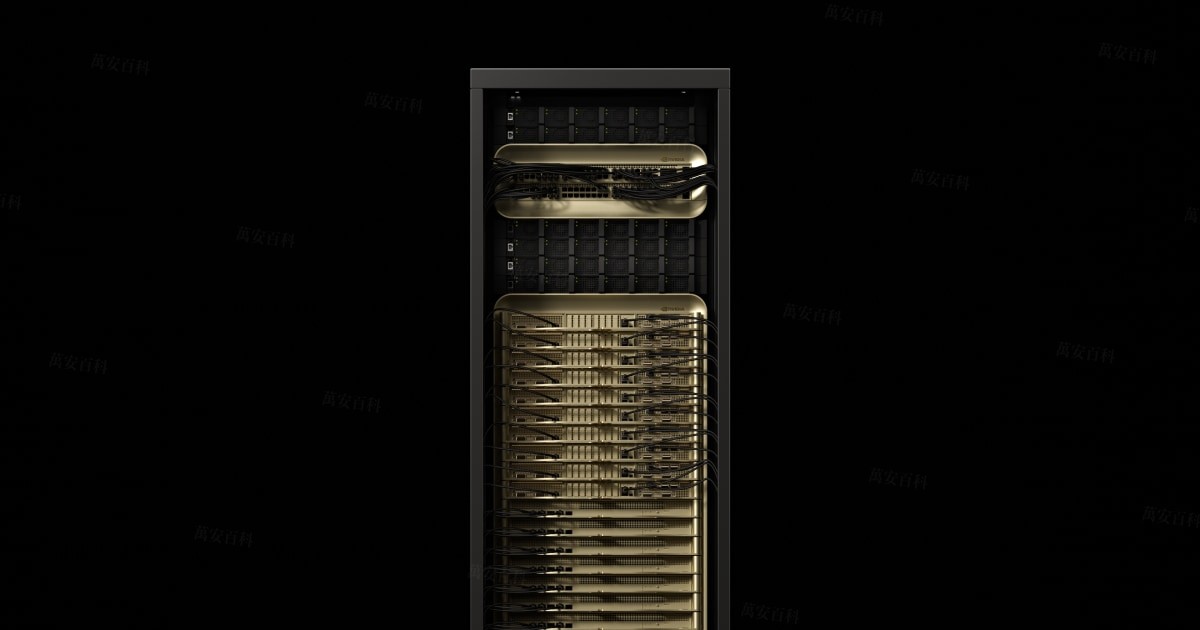
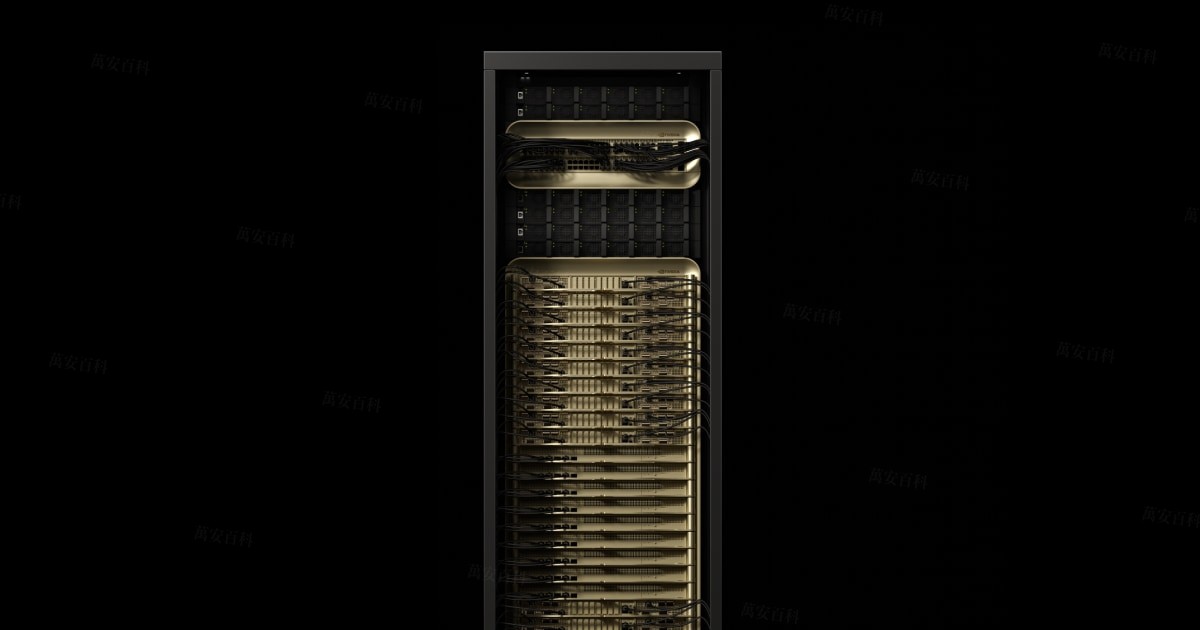
Der B300 wird überwiegend als komplettes System oder Basisboard verkauft: 8-GPU-luftgekühlte Systeme (NVL8), 16-GPU-flüssigkeitsgekühlte Basisboards (NVL16) sowie als Superchip-Variante kombiniert mit der Grace-CPU (GB300-Serie)[2]. Das 8-GPU-luftgekühlte System erfordert keinen Umbau auf Flüssigkeitskühlung im Rechenzentrum und ist daher die am häufigsten verfügbar gehandelte Blackwell-Ultra-Konfiguration auf dem chinesischen Festland.
Seit der zweiten Jahreshälfte 2025 ist der B300 auf dem chinesischen Festland knapp : Die Kapazitäten sind von großen Cloud-Anbietern und Großkunden reserviert, es gibt keine offiziellen Listenpreise, und Spotpreise liegen deutlich über den nordamerikanischen Preisangaben (Marktdaten siehe Modul「Marktlage」dieses Eintrags)[3]。
Einsatzszenarien FIT
AIXX Index (0–100): Die Datenbank gewichtet öffentliche Spezifikationen – Speicher 40 % + Interconnect 30 % + Ökosystem 30 %, je nach Szenario angepasst. 90+ Flaggschiff · 75+ Ausgezeichnet · 60+ brauchbar · unter 60 ungeeignet. Methodik transparent und überprüfbar, keine Leistungszusage.
Historie HISTORY
2022 — Erscheinen des Vorgängers H100 mit Hopper-Architektur, über Jahre die dominierende Datacenter-GPU.[1]
2024 — Vorstellung der Blackwell-Architektur, Serienstart des B200; Vorstellung des Supernode-Konzepts GB200 NVL72.
2025-03 — NVIDIA kündigt auf der GTC「Blackwell Ultra」alias B300 an, Auslieferung ab der zweiten Jahreshälfte 2025[1]。
Zweite Jahreshälfte 2025 — Erste B300-Systeme werden ausgeliefert, der Spothandel auf dem chinesischen Festland beginnt, Preise werden intransparent.
2026 — Das B300-NVL8-luftgekühlte System wird zu einem der umsatzstärksten High-End-Rechensysteme auf dem chinesischen Spotmarkt; die Knappheit hält an.
Technische Daten SPECIFICATIONS
| Position | Spezifikation |
|---|---|
| GPU-Chip | NVIDIA B300「Blackwell Ultra」SXM |
| Speicher pro Karte | 288 GB HBM3e (2,3 TB bei acht Karten) |
| FP4-Inferenzleistung | ca. 1,1 PFLOPS (dicht) / pro Karte |
| GPU-zu-GPU-Interconnect | NVLink der fünften Generation · 1,8 TB/s |
| Board-Power (TBP/TGP) | 1100W |
| Übliche Systemformen | 8 GPU luftgekühlt (NVL8) · 16 GPU flüssigkeitsgekühlt (NVL16) · GB300-Superchip-Serie |
| Vorgänger / Vergleichsprodukt | HGX H100 8 / HGX H200 8 (Hopper-Architektur) |
Spezifikationen gemäß offiziellen NVIDIA-Angaben[1]; Systemkonfigurationen variieren je nach OEM und Charge.
Familienmitglieder FAMILY
Auf B300 basierende System- und Plattformformen:
Vergleich der Kühlvarianten AIR vs LIQUID
Beide basieren auf der B300-Plattform – Luft- und Flüssigkeitskühlung sind zwei getrennte Bereitstellungswege: Der Unterschied liegt nicht in der Rechenleistung, sondern im Rechenzentrum 。


| Dimension | B300 NVL8 luftgekühlt | HGX B300 NVL16 flüssigkeitsgekühlt |
|---|---|---|
| Kühlart | Voll luftgekühlt (Gehäuse-Lüfterwand) | Kaltplatten-Flüssigkeitskühlung (CDU und Leitungen erforderlich) |
| Anforderungen an das Rechenzentrum | Bestehendes Rechenzentrum genügt, ca. 10 kW Stromversorgung | Flüssigkeitsleitungen / CDU und Tragfähigkeitsprüfung erforderlich |
| Bereitstellungszeit | Tage (nach Stromanschluss sofort im Rack) | Wochen bis Monate (inkl. Rechenzentrumsumbau) |
| GPU-zu-GPU-Interconnect-Umfang | 8 GPUs voll vernetzt via NVLink | 16 GPUs voll vernetzt via NVLink |
| Für wen geeignet | Bestandsrechenzentren, gestaffelte Beschaffung, schneller Start | Eigene flüssigkeitsgekühlte Rechenzentren, hochdichte Trainingscluster |
AIXX Index · Deployment in vier Dimensionen
| Index (0–100) | Luftgekühlt NVL8 | Flüssigkeitsgekühlt NVL16 |
|---|---|---|
| Installationsfreundlichkeit | 95 | 55 |
| Wartungsfreundlichkeit | 90 | 72 |
| Leistungsdichte | 70 | 95 |
| Lebensdauererwartung | 82 | 88 |
Hellgoldener Hintergrund = zentrale Unterschiede zwischen den beiden Varianten. Indizes nach der Schätzmethodik dieser Datenbank (siehe「Über diese Datenbank」), gewichtungsabhängig – der Gesamtwert des AIXX Index variiert je nach Szenario, siehe「Einsatzszenarien」.
Modellkompatibilität MODEL FIT
Diese Tabelle beantwortet eine Frage: Wie große Modelle passen auf diese Maschine . Die Speicherwerte sind Schätzungen (Gewicht ≈ Parameterzahl × Bytes pro Parameter, FP8 ≈ 1 B/Parameter, INT4 ≈ 0,5 B/Parameter, plus Reserven für KV-Cache und Aktivierungen); maßgeblich sind die Messwerte im realen Einsatz.
| Modell | Parameterumfang | FP8-Gewichtsschätzung | Passt in 2,3 TB? | AIXX Index | Auf einen Blick |
|---|---|---|---|---|---|
| DeepSeek R1 | 671B MoE (37B aktiv) | ≈690GB | Vollständige Einzelserver-Bereitstellung möglich, mit reichlich Reserve | 95 | Eine der ersten Wahl für LLM-Inferenz |
| Kimi K2 | 1T MoE | ≈1.0TB | Passt, Reserven reichen für hohe Parallelität | 93 | Transportklasse-Fahrzeug für sehr große MoE-Modelle |
| Qwen3 235B | 235B MoE | ≈235GB | Mühelos, mehrere Instanzen parallel möglich | 96 | Arbeitstier für hochparallele Produktionsumgebungen |
| Llama 3 70B-Klasse | 70B dicht | ≈70GB | Einzelne GPU genügt | 88 | Mehrere GPUs vor allem für Skalierung des Durchsatzes |
| Open-Source-Videomodelle | 10–20B-Klasse | ≈10–20GB | Einzelne GPU genügt | 72 | GPUs nach Durchsatzbedarf auslegen, große Leistungsreserve |
Modellspezifikationen iterieren schnell; diese Tabelle basiert auf öffentlich verfügbaren Angaben vom Oktober 2026. Der VRAM-Bedarf von MoE-Modellen wurde unter Annahme abgelegt werden aller Parameter im Speicher geschätzt. Einstufung: 90+ Flaggschiff-Niveau · 75+ Ausgezeichnet · 60+ brauchbar · unter 60 nicht geeignet. Veraltet? Gerne über den Korrekturkanal hinweisen.
Bildergalerie GALLERY


Videoerklärung VIDEO
Community-Hardware · Quelle: YouTube COMMUNITY HANDS-ON
In einigen Regionen ist die Wiedergabe ggf. nicht möglich
Software & Ökosystem ECOSYSTEM
Die erste Meile nach dem GPU-Kauf: Treiber, Frameworks und Interconnect-Netzwerk.
| Position | Anforderung / Status |
|---|---|
| CUDA | 12.8 oder höher (Mindestanforderung der Blackwell-Generation) |
| Treiber | NVIDIA 570er-Serie oder höher |
| Trainings-Frameworks | PyTorch / TensorFlow unterstützen die Blackwell-Architektur offiziell |
| Inferenz-Engines | vLLM / SGLang / TensorRT-LLM sind alle angepasst |
| Netzwerkausstattung | 8-GPU-Systeme benötigen 800G Interconnect: ConnectX-8 NICs + Quantum-800 / Spectrum-X Switching |
| Betriebssystem | Gängige Linux-Distributionen (Ubuntu 22.04+ etc.) |
Die Softwarestack-Versionen entwickeln sich weiter; maßgeblich sind die offiziellen NVIDIA-Veröffentlichungen. Die Übereinstimmung von Treiber- und CUDA-Version ist die häufigste Stolperfalle der ersten Meile.
Beschaffung & Stolperfallen PROCUREMENT
Beim Wareneingang von High-Value-Geräten gehört es zur Branchenpraxis, diese sieben Fragen vorab zu stellen:
Die drei häufigsten Betrugsmaschen
Beim Kauf von High-Value-Geräten sollte eine Drittanbieter-Prüfung hinzugezogen werden, um Bericht und Seriennummer auf Übereinstimmung zu kontrollieren.
Stresstests BENCH TEST
Das „Neu“ auf dem Spot-Markt braucht belastbare Messwerte. Alle Tools sind frei verfügbar: Treiber bringt nvidia-smi mit, dazu NVIDIAs offizielles Diagnosepaket DCGM , Open-Source-Burn-in-Test gpu-burn , Interconnect-Tests nccl-tests und die CUDA-Beispiele bandwidthTest . Die folgenden sechs Urteilskarten liefern jeweils: womit messen / worauf achten / was gilt als Bestanden · Ausgezeichnet · Flop:
nvidia-smigpu-burn 3600 oder dcgmi diag -r 3 · 30–60 MinutenbandwidthTest(CUDA-Musterbeispiele)nccl-tests all_reduce-BenchmarkvLLM Echtes Modell unter Last fahrenMethodik-Hinweis: Die Grenzwerte für „Bestanden“/„Ausgezeichnet“ wurden in dieser Bibliothek nach gängigen Ingenieursstandards zusammengestellt (Bandbreite als Anteil des Nennwerts, Temperatur nach branchenüblichen Datacenter-Limits) und werden mit zunehmenden Prübericht-Messdaten schrittweise kalibriert; diese Tabelle stellt keinerlei Abnahmeverprechen dar, maßgeblich sind die vertraglichen Vereinbarungen. Die Messpunkte der Prüfberichte dieser Bibliothek werden nach genau dieser Tabelle erfasst – NOT_EXECUTED bedeutet: Punkt nicht geprüft. Auch das „nicht getestet“ ist eine wichtige Information.
Versand & Auslieferung LOGISTICS
| Abschnitt | Kernpunkte |
|---|---|
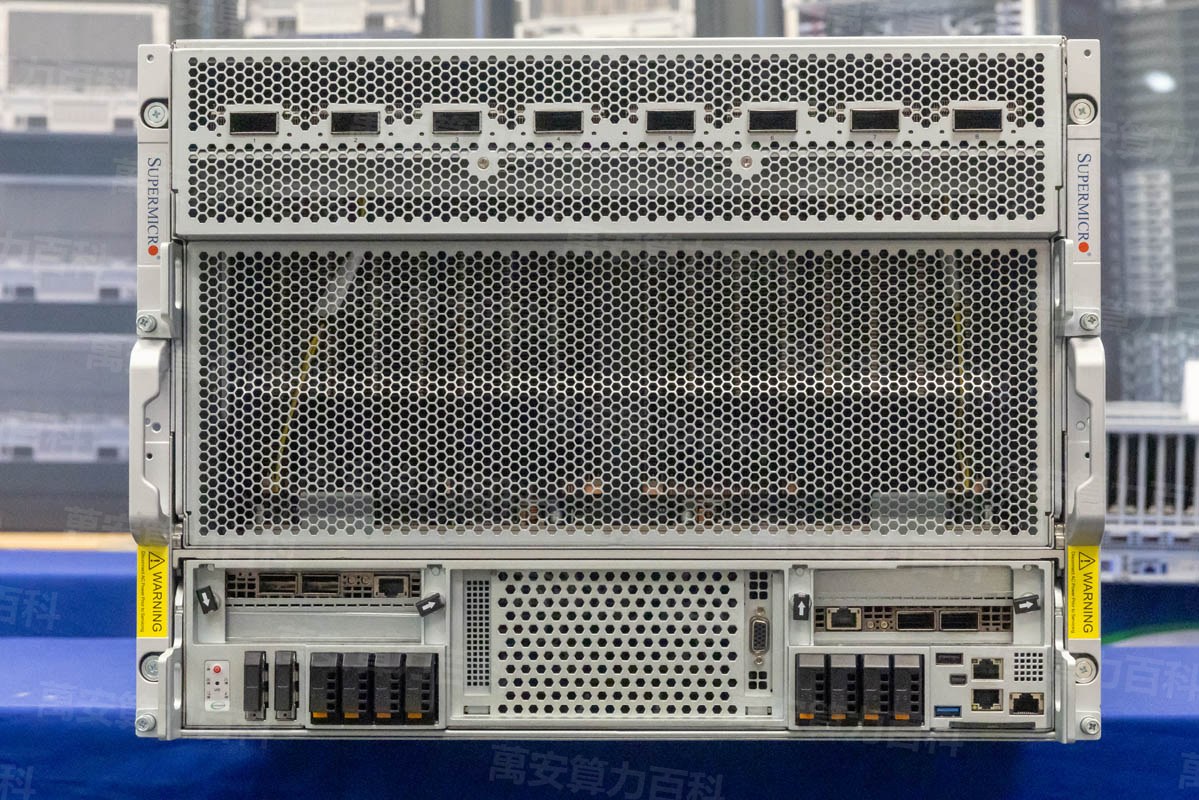
| Formfaktor und Gewicht | 8-Karten-System ca. 8U, Gesamtgewicht üblicherweise 100–170 kg (je nach OEM und Konfiguration, Schätzwert) |
| Verpackung | Original-Holzkiste mit stoßgedämpfter Halterung, Kennzeichnung gegen Feuchtigkeit und Umkippen |
| Grenzüberschreitende Konformität | Unterliegt Exportkontrollen: Konforme Zollabwicklung und Importlizenz sind Voraussetzung; Umleitung über Drittländer ist hochriskant |
| Versicherung | Vollversicherung zum Warenwert ist Branchenstandard |
| Vorgehen bei Ankunft | Zuerst Optik und Siegel prüfen, Seriennummern abgleichen, dann einschalten – die Prüfung vor dem Einschalten ist unverzichtbar |
OEM & Varianten VENDORS
Gleiches HGX B300-Substrat – die Systeme der Hersteller unterscheiden sich in Formfaktor, Kühlung, Dichte und Service. Bei der Auswahl zuerst die Unterschiede ansehen:
| Systemhersteller | Typischer Formfaktor | Unterscheidungsmerkmale | Für wen geeignet |
|---|---|---|---|
| NVIDIA offiziell | DGX B300 | Offizielle Komplettlieferung, Full-Stack-Software und Enterprise-Support | Für Training ab Auspacken und Herstellerrückdeckung |
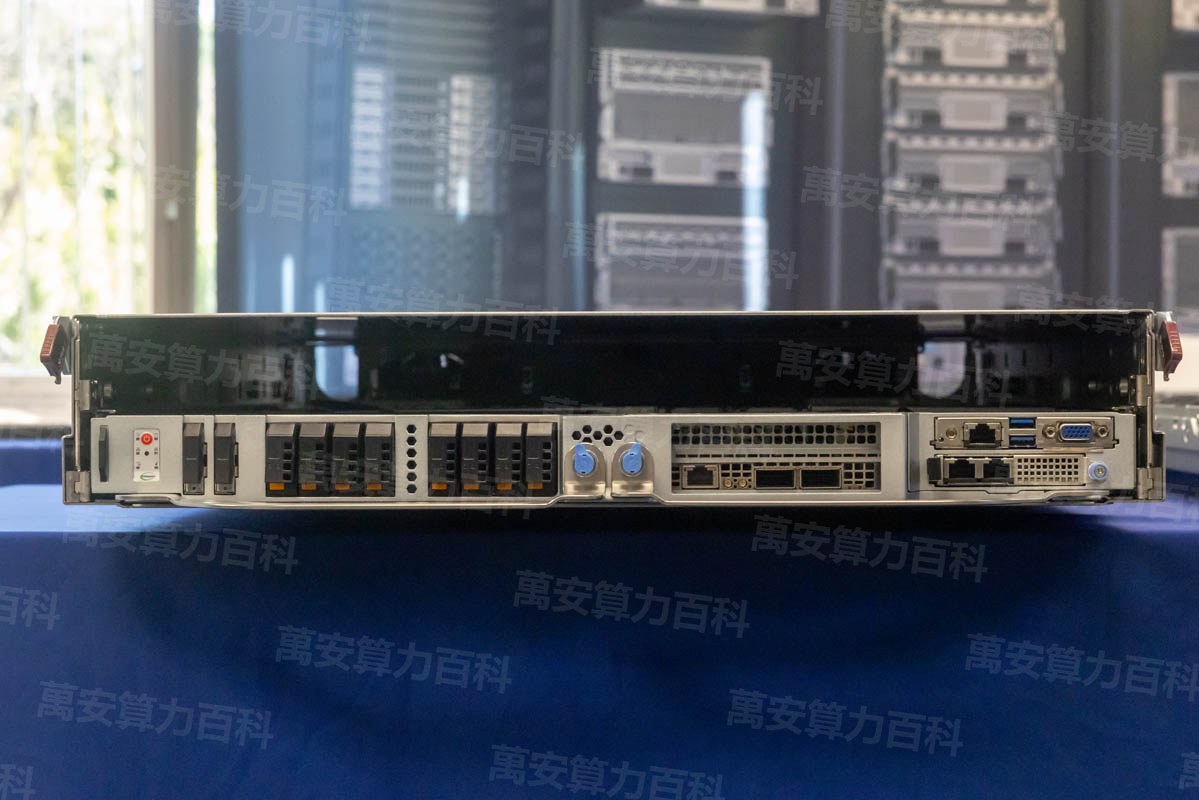
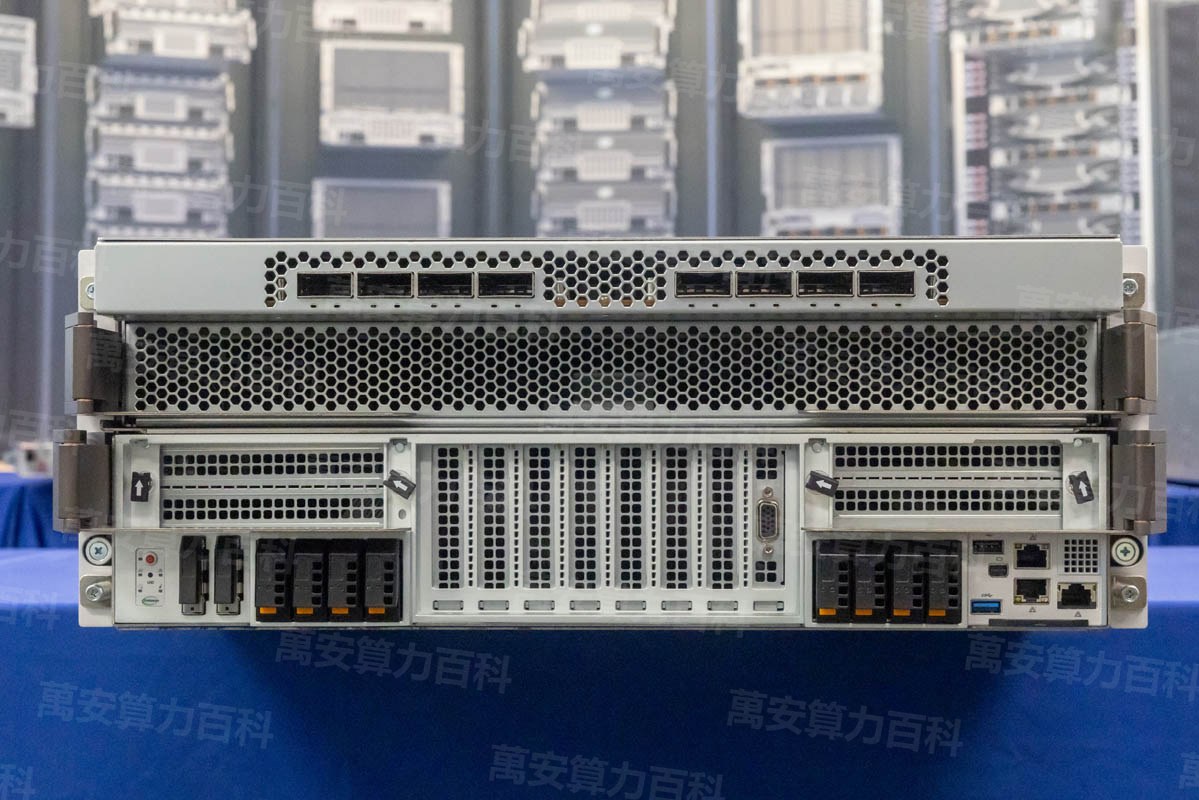
| Supermicro | 8U luftgekühlt / 4U flüssigkeitsgekühlt, beide Varianten | Breitestes Formfaktor-Angebot, starke Lieferzeiten und Preisleistung, Kanalgarantie | Eigenes Rechenzentrum, Preisleistung im Fokus |
| Gigabyte | G893-Serie (8U luftgekühlt / 4U flüssigkeitsgekühlt) | Bis zu 32 Karten pro Rack, dichteorientiert, konfiguriert nach Bestellung | Maximale Dichte pro Rack |
| Dell | PowerEdge XE9712 (Rack-Flüssigkeitskühlung) | Rack-Level-NVL72-Architektur + globales Service-Netz erster Klasse | Grenzüberschreitende Deployments, Servicenetz gewünscht |
| HPE / Lenovo | Integration in Enterprise-Produktlinien (überwiegend flüssigkeitsgekühlt) | Ausgereifte Enterprise-Services und Finanzierungslösungen, konservativer Formfaktor | Enterprise-Kunden, ausgelagerte Betriebsführung |
AIXX Index · Vierdimensionaler Deployment-Vergleich AIXX INDEX
| Systemhersteller | Einfache Installation | Wartungsfreundlichkeit | Leistungsdichte | Lebensdauererwartung |
|---|---|---|---|---|
| NVIDIA offiziell | 95 | 90 | 80 | 85 |
| Supermicro | 88 | 82 | 85 | 82 |
| Gigabyte | 85 | 80 | 92 | 80 |
| Dell | 90 | 92 | 88 | 86 |
| HPE / Lenovo | 86 | 90 | 84 | 85 |
Der Index ist eine Schätzung dieser Bibliothek (0–100, Dimensionen deckungsgleich mit den vier Deployment-Dimensionen unter „Geeignete Szenarien“); Grundlage sind die öffentlich dokumentierten Unterschiede der Hersteller bei Formfaktor, Kühlung und Servicenetz, aktualisiert durch Verifikation an realen Systemen und Chargendaten, ohne Beschaffungszusage. Maßgeblich sind die offiziellen Angaben der Hersteller.
Glossarkarten GLOSSARY
HBM3e-Speicher
Hochbandbreitenspeicher, direkt neben der GPU gestapelt – der „Vorratsspeicher“ für KI-Training. Pro B300-Karte 288 GB, zusammen 2,3 TB bei acht Karten.
NVLink-Interconnect
Dedizierter Hochgeschwindigkeitskanal zwischen den Karten (fünfte Generation, 1,8 TB/s), der acht GPUs wie eine zusammenarbeiten lässt.
SXM / NVL8
SXM ist eine Onboard-Direktverdrahtung der GPU (kein Steckkartenformat); NVL8 bezeichnet das Substrat-Layout mit vollständig vernetzten acht Karten und bildet den Rechenkern eines HGX-Servers.
Kaltplatten-Flüssigkeitskühlung / CDU
Kaltplatten nehmen die Wärme direkt am Chip auf, Kühlflüssigkeit transportiert sie über Leitungen ab, die CDU (Kühlmittel-Vertialeinheit) regelt Verteilung und Kreislauf – die zentrale Infrastruktur flüssigkeitsgekühlter Rechenzentren.
FP8
8-Bit-Fließkommaformat, die dominierende Präzision für KI-Inferenz und Training; zur Abschätzung des Speicherbedarfs gilt: Gewichte ≈ Parameteranzahl × 1 Byte.
MoE – Mixture of Experts
Architektur mit „spärlicher Aktivierung“: große Gesamtparameterzahl (z. B. DeepSeek R1 mit 671B), aber pro Inferenz wird nur ein Teil aktiviert (37B). Beim Deployment müssen dennoch alle Parameter auf den Karten liegen.
Grenzen & Kontroversen LIMITS
- Preis-Intransparenz und Preisgefälle zwischen USA und China :In nordamerikanischen Kanälen liegt die offizielle Listenpreisangabe bei rund $497.000 (≈3,58 Mio. CNY, abgerufen 2026-10), während Spotpreise auf dem chinesischen Festland allgemein mit 15,0–17,0 Mio. CNY liegen – ein Preisgefälle von über 4× für identische Systeme, eine der extremsten Aufschläge unter den globalen etablierten Rechenzentrum-Systemen. Der Aufschlag speist sich aus drei Faktoren: Bedarf übersteigt Angebot bei Weitem (Giganten bestellen mit Vorlauf, Kapazität bevorzugt Großabnehmer, Kleinkunden warten endlos), die US-Einschränkungsgesetze gegenüber China verknappen reguläre Lieferungen, und NVIDIAs Quasi-Monopol gibt dem Verkäufer die Preisbildungsmacht (Huawei & Co. haben noch erheblichen Aufholbedarf). Zu den Risikoaufschlägen der Graukanäle siehe unten und die Chronik. Die Akteure streiten über die Ursachen – diese Bibliothek dokumentiert lediglich täglich die Daten.
- Kapazitätsverteilungsstreit :Kapazität geht bevorzugt an zugewiesene Großkunden, für mittlere und kleine Käufer liegen die Wartezeiten im Jahresbereich; „Aufschlag fürs Vordrängen“ und Abflüsse aus internen Kanälen werden von Fachmedien wiederholt erwähnt, NVIDIA hat die Verteilungsregeln nie offengelegt – die intransparente Verteilung ist der größte Governance-Konflikt dieser Produktlinie.
- Kanalchaos und Aufarbeitungsrisiko :Auf dem Spot-Markt sind Fälle dokumentiert, in denen B200 als B300 ausgegeben, Speicherkapazität falsch deklariert oder Aufarbeitungskarten als Neuware verkauft wurden (Meldungen von Prüfinstitutionen; Hinweis dieser Bibliothek: Bei „neuen“ Systemen unbekannter Herkunft sollten Seriennummer und Prüfbericht stets verifiziert werden). Zustands- und Echtheitsprüfung ist ein Pflichtschritt der Beschaffung, keine Option.
- Leistungsaufnahme und Deployment-Hürden :1100 W pro Karte, ~10 kW für das 8-Karten-System – Bestandsrechenzentren benötigen meist Anpassungen bei Strom und Kühlung; bei luftgekühlten Varianten setzt die Kühlungsgrenze auch der Leistung die Grenze, in Höhenlagen und bei hohen Temperaturen ist mit Derating zu rechnen.
- Exportkontrollen und geopolitische Variablen :Das B300 unterliegt den US-Exportkontrollen gegenüber China, die Legitimität der Kanäle hängt von Importlizenzen ab; jede Anpassung der Kontrollpolitik stellt die Preisstruktur direkt um (die Zulassung des H200 für China im Juli 2026 löste einen massiven Einbruch der H-Serie-Preise aus) – die Geopolitik ist die größte einzelne Risikogröße dieses Modells.
Marktlage MARKET DATA
| Datum | Kategorie | Region | Referenzpreisspanne | Anmerkung |
|---|---|---|---|---|
| 2026-10-20 | Marktspanne dieser Bibliothek | Festlandchina | 12,57–16,62 Mio. CNY | Angebotsspanne laufender Verkäufe (87 Stellen) |
| 2026-10-06 | Mess-Snapshot | Festlandchina | 10,72–15,02 Mio. CNY | Angebotsspanne laufender Verkäufe (30 Stellen) |
| 2026-10-07 | Mess-Snapshot | Festlandchina | 10,72–15,02 Mio. CNY | Angebotsspanne laufender Verkäufe (31 Stellen) |
| 2026-10-08 | Mess-Snapshot | Festlandchina | 10,72–15,02 Mio. CNY | Angebotsspanne laufender Verkäufe (31 Stellen) |
| 2026-10-09 | Mess-Snapshot | Festlandchina | 10,72–15,06 Mio. CNY | Angebotsspanne laufender Verkäufe (33 Stellen) |
| 2026-10-04 | Ankerpreis | Festlandchina | ¥15,8 Mio. – 17 Mio. | Zwei Konfigurationen: A/B |
| 2026-10-05 | Listpreis im Überseekanal | Nordamerika | ab $496.728 | Öffentlicher Einstiegspreis des Händlers[3] |
| 2026-10 | Marktkenntnisspanne | Festlandchina | ¥15 Mio. – 17 Mio. | Händlerangabe, ohne Bestätigung durch diese Datenbank |
Weitere Echtzeit-Marktspannen GLOBAL
| Markt | Echtzeitspanne | Direkt zur Handelsplattform |
|---|---|---|
| Singapur (SGD) | 5,92 Mio. – 7,90 Mio. | 106 Angebote › |
| Europa (EUR) | 2,88 Mio. – 3,94 Mio. | 101 Angebote › |
| Japan (JPY) | 648,72 Mio. – 902,40 Mio. | 95 Angebote › |
| Naher Osten (AED) | 14,31 Mio. – 18,96 Mio. | 92 Angebote › |
| Festlandchina (CNY) | 12,57 Mio. – 16,62 Mio. | 87 Angebote › |
| US-Dollar-Raum (USD) | 2,10 Mio. – 2,94 Mio. | 81 Angebote › |
Echtzeit-Angebotsspannen der einzelnen Märkte (in Originalwährung, aktualisiert beim Laden der Seite); ein Klick auf „N Angebote“ führt direkt in die Handelsplattform mit automatisch ausgewählter Region.
Methodik: Ab Juni 2025 Schätzband (rückwirkend aus dem Markteintritt von B300 abgeleitet, Bandbreite = Schwankungen durch Zustand/Konfiguration); ab Oktober 2026 täglich erfasste Benchmark-Snapshots (siehe Tabelle oben). Nordamerika: Händlerlistenpreis in RMB umgerechnet; das Schätzband basiert auf der Preissteigerung durch Spot-Verknappung seit Markteintritt (etwa Verdopplung), verankert im Oktober 2026 beim Händlerlistenpreis von $496.728. Preisdatenquelle dieser Datenbank: AIXX Börse (provisionsfreie Vermittlung, keine Beteiligung an Transaktionen; keine Kenntnis und keine Spekulation über Abschlusspreise – daher neutrale Daten). Die Schätzbänder der übrigen Märkte basieren auf einer rückwirkend angenommenen etwaigen Verdopplung seit Markteinführung, mit Endpunkt am jeweiligen Tages-Snapshot der verfügbaren Angebote. Das Referenzpreisband dient ausschließlich der Trendbetrachtung und stellt kein Kaufangebot dar; der tatsächliche Preis richtet sich nach dem Angebot des Verkäufers.
Wichtige Preisereignisse MILESTONES
Aktuelles & verwandte Ereignisse TIMELINE
FAQ FAQ
Ja. Die FP8-Gewichte umfassen rund 690 GB; mit insgesamt 2,3 TB Videospeicher ist eine vollwertige Bereitstellung auf einem einzelnen System mit reichlich Reserve möglich (siehe „Modellkompatibilität“).
Die luftgekühlte NVL8-Bauform wurde genau für Bestandsrechenzentren entwickelt; eine Stromversorgung im 10-kW-Bereich genügt. Die flüssigkeitsgekühlte Variante erfordert entsprechende Infrastruktur (siehe „Vergleich der Kühlformen“).
Aufdruck mit offiziellen Firmware-Angaben abgleichen und die Seriennummer über unabhängige Kanäle kreuzweise verifizieren; beide Generationen sehen extrem ähnlich aus – allein Fotos sind nicht verlässlich (siehe „Beschaffungspraxis und Fallstricke“).
Erstens übersteigt die Nachfrage das Angebot bei Weitem – Konzerne reihen sich für Ware ein, Kapazitäten gehen bevorzugt an Großkunden, Kleinkäufer warten lange. Zweitens haben die USA äußerst scharfe Verbote gegen China erlassen, sodass reguläre Käufe unmöglich sind. Drittens ist NVIDIA technisch konkurrenzlos führend (Huawei & Co. haben noch erheblichen Aufholbedarf). Diese drei Faktoren zusammen ergeben eine Spotpreis-Differenz von über 4× (siehe „Grenzen und Kontroversen“ sowie das Marktdatenband, Stand Oktober 2026).
Ja, und die Nachfrage übersteigt das Angebot: Kapazitäten gehen vorrangig an Großkunden, für kleinere Abnehmer betragen die Wartezeiten mehrere Jahre.
Verwandte Einträge SEE ALSO
Modellvergleich und Auswahl COMPARE
Quellen REFERENCES
- NVIDIA-Website – Blackwell Ultra / HGX B300 Produktseite https://www.nvidia.com/en-us/data-center/hgx/
- NVIDIA Newsroom – Ankündigung der Blackwell-Ultra-Plattform https://nvidianews.nvidia.com/news/nvidia-blackwell-ultra-ai…
- Marktdatenband – AIXX Börse (Angebote dieser Plattform und Händlerspannen, täglich aktualisiert) /hall.html
- Mitteilung des US-Justizministeriums – California Man Arrested for Smuggling More Than $300 Million in Export-Controlled Computer Servers (Oktober 2026) https://www.justice.gov/opa/pr/california-man-arrested-smugg…