موسوعة AIXX › مقالة الطراز › B300

B300
نظرة عامة OVERVIEW
B300 (الاسم الكامل NVIDIA B300، ينتمي إلى سلسلة «Blackwell Ultra»)أطلقتها NVIDIA في عام 2025، وهو GPU لمراكز البيانات[1]، ويُعد نسخة مطوّرة من B200 الصادر عام 2024. ذاكرة اللوحة الواحدة 288GB HBM3e ، أي أكثر من ثلاثة أضعاف الجيل السابق H100 (80GB)، وقدرة الاستدلال بـ FP4 تبلغ نحو 1.1 PFLOPS (كثيف)، واستهلاك طاقة اللوحة (TBP/TGP) 1100W[1]。
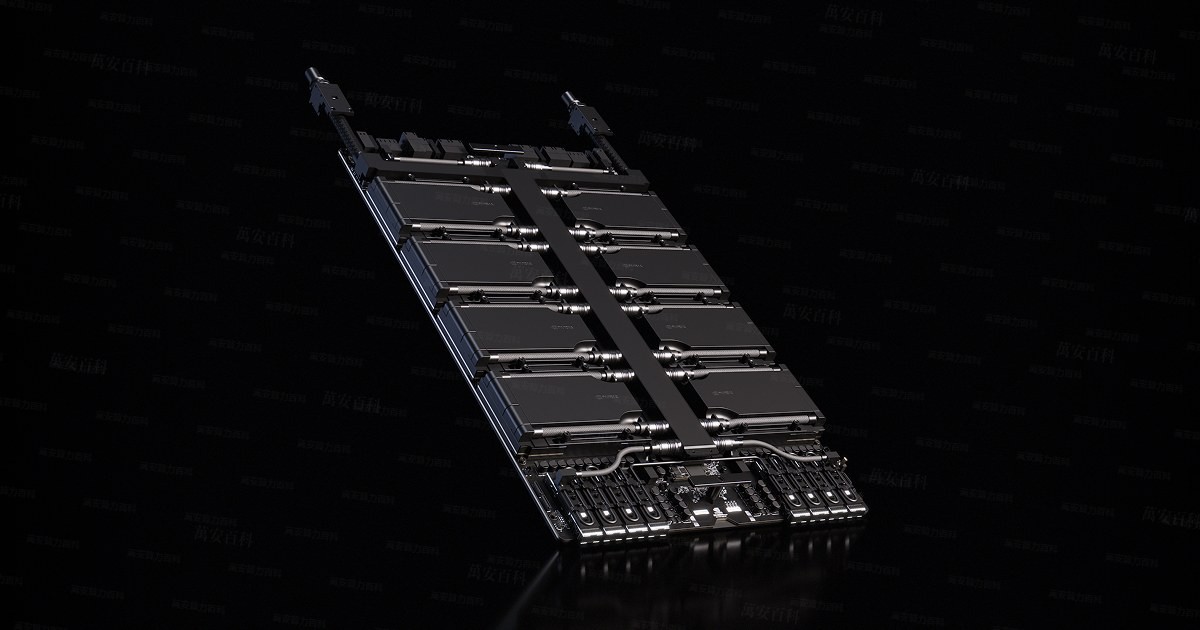
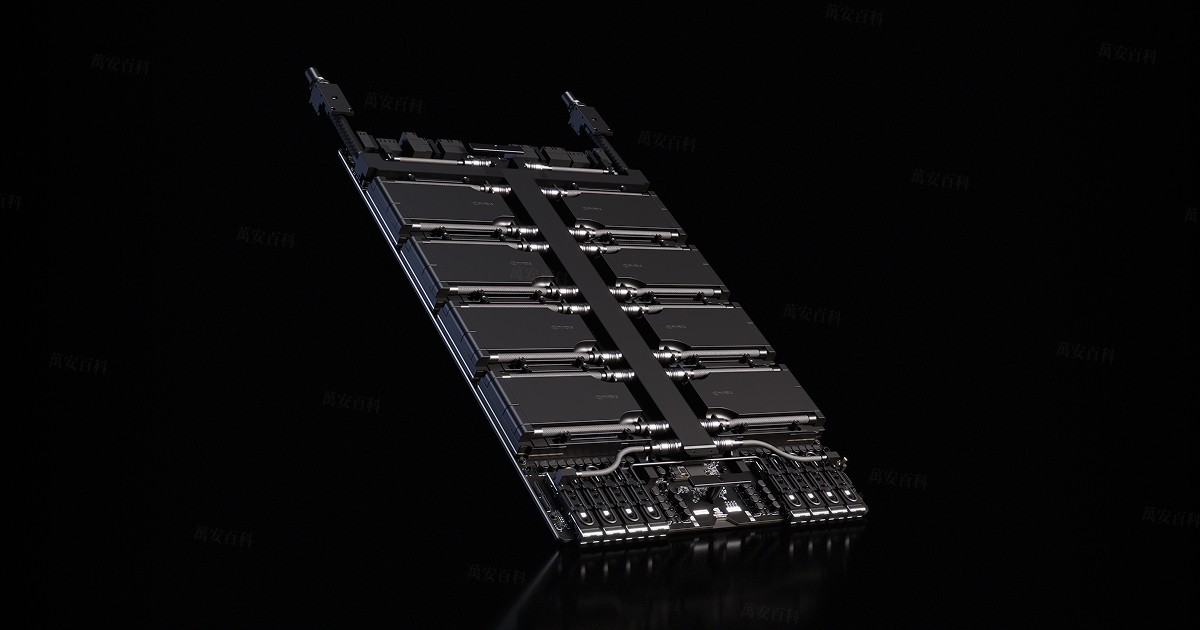
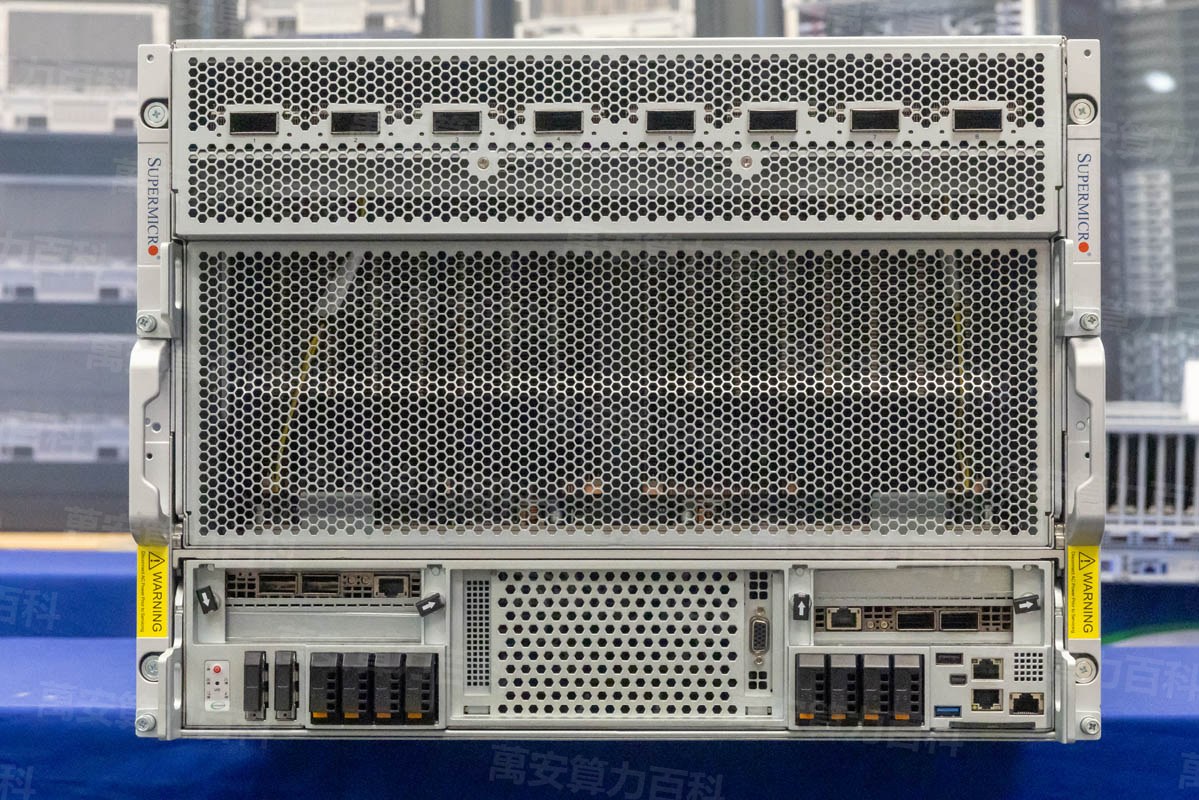
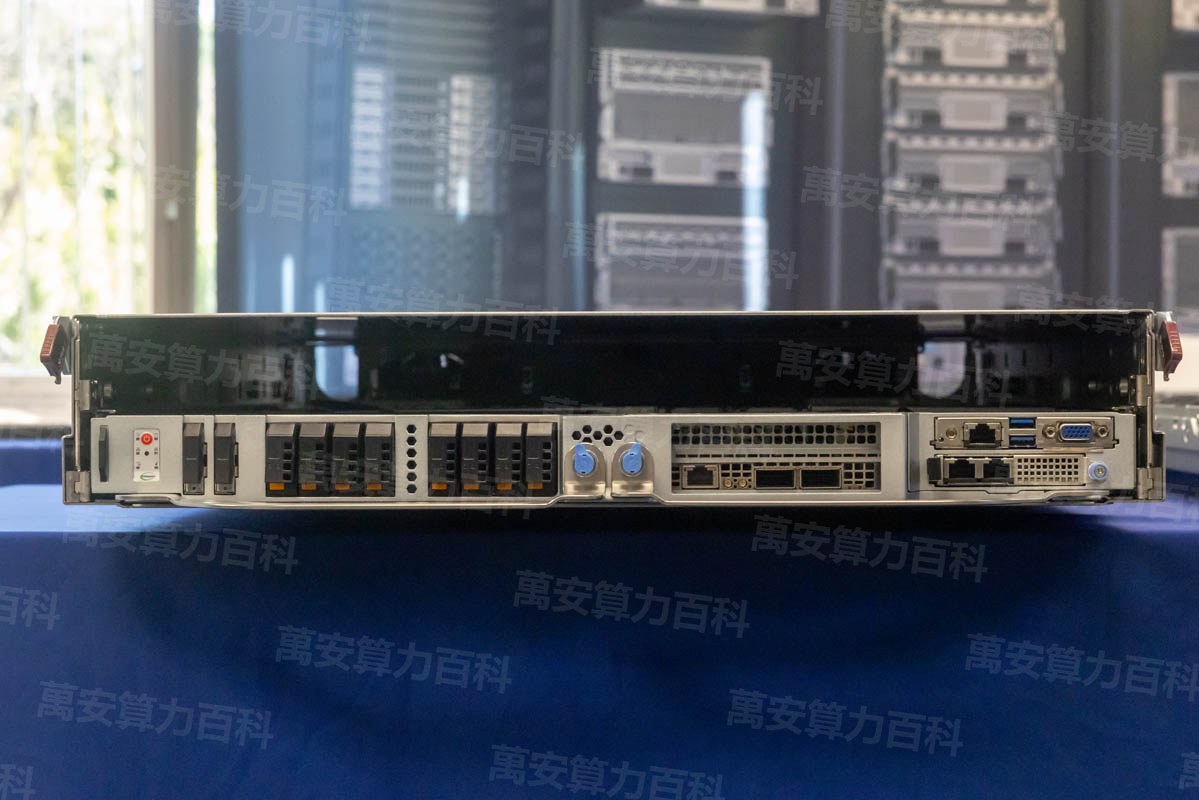
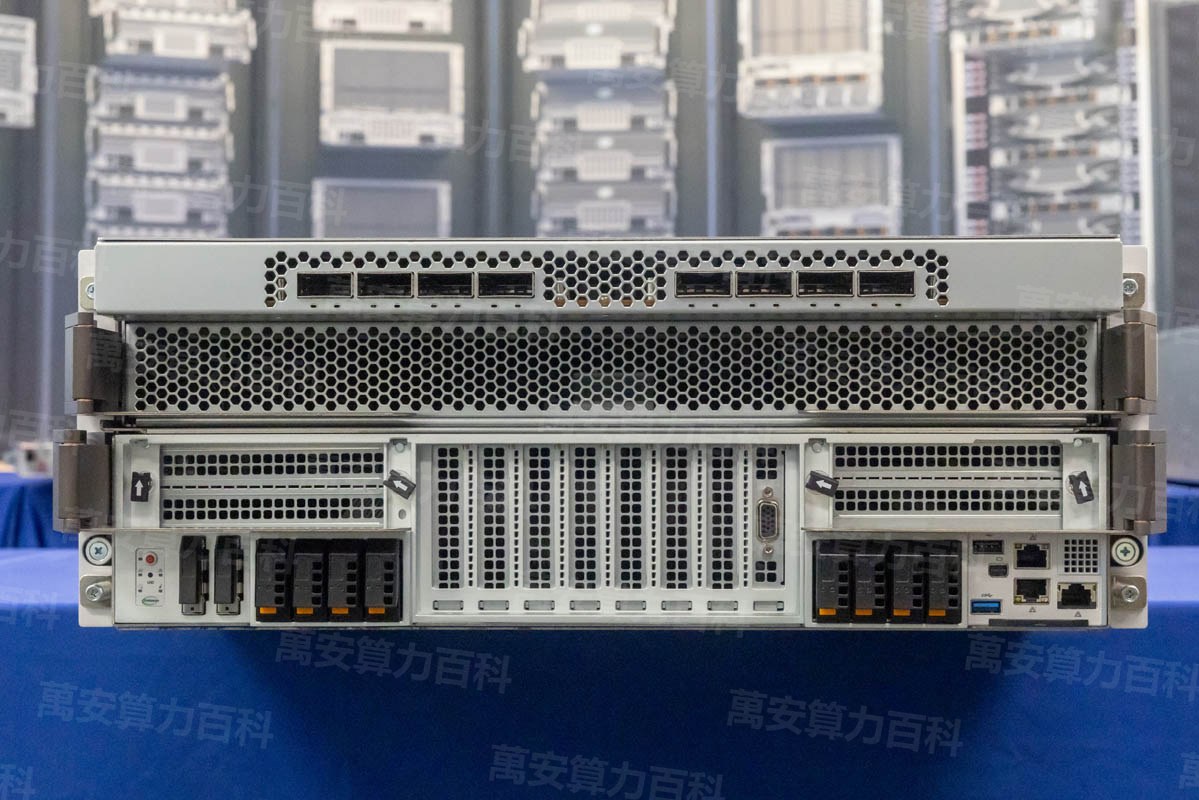
يُباع B300 بشكل رئيسي بصيغ الأنظمة الكاملة واللوحات الأساسية :نظام هوائي بثماني بطاقات (NVL8)، ولوحة أساسية بتبريد سائل بـ 16 بطاقة (NVL16)، بالإضافة إلى صيغة Superchip المدمجة مع معالج Grace CPU (سلسلة GB300)[2]. ونظرًا لأن النظام الهوائي بثماني بطاقات لا يتطلب تعديلات على غرفة التبريد السائل، فقد أصبح طراز Blackwell Ultra الأكثر تداولًا في السوق الصينية.
منذ النصف الثاني من 2025، يعاني B300 في السوق الصينية من شحّ في المعروض :حُجزت الطاقة الإنتاجية من كبرى مزودي السحابة والعملاء الكبار، ولا توجد أسعار معيارية في القنوات العامة، وتتجاوز الأسعار الفورية بشكل ملحوظ الأسعار المعلنة في أمريكا الشمالية (بيانات السوق في وحدة «شريط الأسعار» من هذه المقالة)[3]。
حالات الاستخدام FIT
AIXX Index (0–100):تحتسب هذه المكتبة بوزن مرجّح وفق المواصفات العامة——ذاكرة 40% + الربط البيني 30% + النظام البيئي 30%، مع تعديل الأوزان حسب الاستخدام. 90+ فئة الرائدة · 75+ ممتاز · 60+ صالح للاستخدام · أقل من 60 غير مناسب. منهجية شفافة وقابلة للتحقق، ولا تُعد وعدًا بالأداء.
التطور التاريخي HISTORY
2022 — إطلاق الجيل السابق H100 بمعمارية Hopper، الذي هيمن على موقع GPU الرئيسي في مراكز البيانات لسنوات.[1]
2024 — إطلاق معمارية Blackwell وبدء الإنتاج الكمي لـ B200؛ وتقديم حل العقدة الفائقة GB200 NVL72.
2025-03 — أعلنت NVIDIA في مؤتمر GTC عن «Blackwell Ultra» أي B300، مع إعلان الشحن في النصف الثاني من 2025[1]。
النصف الثاني من 2025 — بدأ تسليم أنظمة B300 تدريجيًا، وبدأ التداول في القنوات الفورية بالسوق الصينية مع غياب شفافية الأسعار.
2026 — أصبح النظام الهوائي B300 NVL8 واحدًا من أكثر طرازات الحوسبة عالية الأداء تداولًا في السوق الفورية بالصين؛ ويستمر شحّ المعروض.
المواصفات التقنية SPECIFICATIONS
| البند | المواصفة |
|---|---|
| نواة GPU | NVIDIA B300「Blackwell Ultra」SXM |
| ذاكرة اللوحة الواحدة | 288GB HBM3e (بإجمالي 2.3TB للثماني بطاقات) |
| قدرة الاستدلال FP4 | نحو 1.1 PFLOPS (كثيف) / لكل بطاقة |
| الربط البيني بين بطاقات الرسوميات | الجيل الخامس من NVLink · 1.8TB/s |
| استهلاك طاقة اللوحة (TBP/TGP) | 1100W |
| صيغ الأنظمة الرئيسية | نظام هوائي بثماني بطاقات (NVL8) · نظام تبريد سائل بـ 16 بطاقة (NVL16) · سلسلة Superchip GB300 |
| الجيل السابق / المنافس المباشر | HGX H100 8 / HGX H200 8 (معمارية Hopper) |
المواصفات وفقًا للمعلومات الرسمية المنشورة من NVIDIA[1]؛ وتختلف تهيئة الأنظمة بحسب OEM والدفعات.
أفراد العائلة FAMILY
الأنظمة والصيغ المبنية على B300:
مقارنة أنظمة التبريد AIR vs LIQUID
المنصتان الهوائية والسائلة تنتميان لنفس منصة B300، لكنهما مساران نشر مختلفان—— الفرق ليس في القدرة الحوسبية، بل في غرفة الخوادم 。


| المعيار | B300 NVL8 تبريد هوائي | HGX B300 NVL16 تبريد سائل |
|---|---|---|
| طريقة التبريد | تبريد هوائي بالكامل (جدار مراوح الهيكل) | التبريد السائل بالصفيحة الباردة (يتطلب CDU وأنابيب) |
| متطلبات غرفة الخوادم | الغرفة الحالية كافية، مع تغذية كهربائية بحدود 10kW | يتطلب أنابيب تبريد سائل / تجهيزات CDU وتقييم تحمل الأرضية |
| مدة النشر | أيام (يُرفع على الرف فور وصول الكهرباء) | أسابيع إلى أشهر (بما يشمل تعديل غرفة الخوادم) |
| نطاق الربط البيني بين بطاقات الرسوميات | ربط NVLink كامل لـ 8 بطاقات | ربط NVLink كامل لـ 16 بطاقة |
| لمن يناسب | غرف الخوادم القائمة، الشراء على مراحل، الإطلاق السريع | غرفة تبريد سائل خاصة، عناقيد تدريب عالية الكثافة |
AIXX Index · النشر بأربعة أبعاد
| المؤشر (0–100) | NVL8 هوائي | NVL16 سائل |
|---|---|---|
| سهولة التركيب | 95 | 55 |
| سهولة الصيانة | 90 | 72 |
| كثافة الأداء | 70 | 95 |
| العمر المتوقع | 82 | 88 |
الخلفية الذهبية الفاتحة = عناصر الفروق الجوهرية بين الصيغتين. المؤشرات وفق منهجية تقدير هذه المكتبة (المنهجية في «عن هذه المكتبة»)، وتتغير حسب أوزان الاستخدام——يختلف AIXX Index الإجمالي بحسب السيناريو، انظر «حالات الاستخدام».
توافق النماذج MODEL FIT
يجيب هذا الجدول عن سؤال واحد: ما حجم النموذج الذي تتسع له هذه الآلة . أرقام احتلال الذاكرة تقديرية (الوزن ≈ عدد المعاملات × بايتات لكل معامل، FP8 ≈ 1B/معامل وINT4 ≈ 0.5B/معامل، مع حجز هامش لذاكرة KV التخزينية والتنشيطات)، والنشر الفعلي يخضع للاختبار الميداني.
| النموذج | حجم المعاملات | تقدير أوزان FP8 | هل تتسع في 2.3TB | AIXX Index | جملة واحدة |
|---|---|---|---|---|---|
| DeepSeek R1 | 671B MoE (37B مُنشَّط) | ≈690GB | قابل للنشر الكامل على جهاز واحد بهامش وفير | 95 | أحد الخيارات المفضلة لاستدلال النماذج الضخمة |
| Kimi K2 | 1T MoE | ≈1.0TB | قابل للتثبيت، والهامش يدعم التزامن العالي | 93 | وسيلة نقل بمستوى النقل الفعلي لنماذج MoE العملاقة |
| Qwen3 235B | 235B MoE | ≈235GB | بسهولة، ويمكن تشغيل عدة نسخ بالتوازي | 96 | العمود الفقري للإنتاج عالي التزامن |
| مستوى Llama 3 70B | 70B كثيف | ≈70GB | بطاقة واحدة كافية لاستيعابه | 88 | البطاقات المتعددة تُستخدم أساسًا لتوسيع سعة التزامن |
| نماذج فيديو مفتوحة المصدر | فئة 10–20B | ≈10–20GB | بطاقة واحدة كافية | 72 | تُخصَّص البطاقات حسب حاجة الإنتاجية، مع هامش أداء كبير |
تتطور مواصفات النماذج بسرعة، وقد أُعِدَّ هذا الجدول بناءً على البيانات المتاحة علنًا حتى 2026-10؛ ويُقاس استهلاك ذاكرة نماذج MoE بتثبيت جميع المعاملات على البطاقات. التقديرات: 90+ مستوى رائد · 75+ ممتاز · 60+ قابل للاستخدام · أقل من 60 غير مناسب. لاحظت معلومة قديمة؟ يسعدنا تلقي تصحيحاتك عبر قناة التصحيحات شكرًا لك.
معرض الصور GALLERY


شرح بالفيديو VIDEO
أجهزة حقيقية من المجتمع · المصدر YouTube COMMUNITY HANDS-ON
قد يتعذّر التشغيل المباشر في بعض المناطق
البرمجيات والنظام البيئي ECOSYSTEM
أول كيلومتر بعد شراء البطاقات: التعريفات وأُطر العمل وشبكة الربط البيني.
| البند | المتطلبات / الوضع الحالي |
|---|---|
| CUDA | 12.8 فأعلى (الحد الأدنى المطلوب لجيل Blackwell) |
| التعريفات | NVIDIA سلسلة 570 فأحدث |
| أُطر التدريب | PyTorch / TensorFlow تدعمان بنية Blackwell رسميًا |
| محركات الاستدلال | vLLM / SGLang / TensorRT-LLM متوافقة جميعها |
| البنية الشبكية | الأجهزة ثماني البطاقات تتطلب ربطًا بسرعة 800G: بطاقة ConnectX-8 + تبديل Quantum-800 / Spectrum-X |
| نظام التشغيل | التوزيعات الرئيسية لنظام Linux (مثل Ubuntu 22.04+) |
تتطور إصدارات حزمة البرمجيات مع الزمن، والمرجع هو ما تصدره NVIDIA رسميًا؛ وتوافق التعريفات مع إصدار CUDA هو أكثر نقاط الفشل شيوعًا في أول كيلومتر.
أمور الشراء والتحذيرات PROCUREMENT
في مرحلة فحص المعدات عالية القيمة، من العادات المهنية طرح هذه الأسئلة السبعة مسبقًا:
ثلاث عمليات احتيال شائعة
يُنصح بإشراك جهة فحص طرف ثالث في شراء المعدات عالية القيمة للتحقق من اتساق التقرير مع الرقم التسلسلي.
كيفية اختبار الضغط BENCH TEST
وصف «الجديد» في سوق السلع المتوفرة فورًا يجب أن يكون مدعومًا باختبارات فعلية. الأدوات كلها مجانية ومتاحة للعموم: أداة nvidia-smi المرفقة مع التعريفات، وحزمة التشخيص الرسمية من NVIDIA DCGM ، وأداة اختبار الإجهاد مفتوحة المصدر gpu-burn ، واختبار الربط البيني nccl-tests ، والأمثلة المرفقة مع CUDA bandwidthTest وفيما يلي ست بطاقات أحكام، توفّر كل منها: «ما الأداة / أي رقم تراقب / ما حد النجاح·التميّز·الفشل»:
nvidia-smigpu-burn 3600 أو dcgmi diag -r 3 · 30–60 دقيقةbandwidthTest(عينة مدمجة من CUDA)nccl-tests اختبار all_reducevLLM تشغيل نموذج حقيقي وقياس الأداءمنهجية القياس: خطا «ناجح/ممتاز» معدّان وفق الممارسات الهندسية المتعارف عليها في هذه المكتبة (النطاق الترددي كنسبة من القيمة الاسمية، ودرجة الحرارة وفق الحد الشائع في مراكز البيانات)، ويتم معايرتهما تدريجيًا مع تراكم بيانات تقرير الفحص المقاسة؛ هذا الجدول لا يشكل أي التزام بالقبول، والمعتمد هو ما ينص عليه العقد. البنود المقاسة في تقارير الفحص بهذه المكتبة تُسجَّل وفق منهجية هذا الجدول—NOT_EXECUTED تعني أن البند لم يُنفَّذ، و«لم يُختبر» بحد ذاته معلومة مهمة.
الشحن والتسليم LOGISTICS
| البند | النقطة الأساسية |
|---|---|
| الشكل والوزن | جهاز 8 بطاقات يستهلك نحو 8U، ووزنه الكلي عادة 100–170 كجم (حسب OEM والتكوين، تقدير) |
| التغليف | صناديق خشبية أصلية مع حوامل مضادة للاهتزاز وعلامات الحماية من الرطوبة والانقلاب |
| الامتثال عبر الحدود | بند خاضع لقيود التصدير: التخليص الجمركي النظامي وتراخيص الاستيراد شرطان مسبقان، وإعادة الشحن عبر دولة ثالثة سلوك عالي المخاطر |
| التأمين | التأمين بكامل قيمة الشحنة هو العرف المهني |
| ترتيب الاستلام | فحص المظهر والأختام أولًا، ومطابقة الأرقام التسلسلية، ثم تشغيل الجهاز—لا يجوز إسقاط التحقق قبل التشغيل |
OEM والنسخ المشتقة VENDORS
نفس لوحة HGX B300 الأساس، لكن الفرق بين أجهزة الشركات في الشكل والتبريد والكثافة والخدمة—ابدأ الاختيار من الفروقات:
| الشركة المصنعة | الشكل الممثل | نقاط الفرق | لمن يناسب |
|---|---|---|---|
| NVIDIA الرسمي | DGX B300 | تسليم متكامل رسمي، برمجيات متكاملة ودعم بمستوى المؤسسات | لمن يريد تدريبًا فوريًا خارج الصندوق وضمان الشركة الأم |
| Supermicro سوبرميكرو | شكلان: 8U تبريد هوائي / 4U تبريد سائل | أوسع تشكيلة أشكال، مواعيد تسليم قوية وأفضل قيمة مقابل السعر، ضمان عبر القنوات | بناء مركز بيانات ذاتي، والاهتمام بالقيمة مقابل السعر |
| Gigabyte جيجابايت | سلسلة G893 (8U تبريد هوائي / 4U تبريد سائل) | حتى 32 بطاقة في حامل واحد، توجه نحو الكثافة، تكوين حسب الطلب | لمن يسعى لأقصى كثافة في الحامل |
| Dell ديل | PowerEdge XE9712 (تبريد سائل على مستوى الحامل) | معمارية NVL72 على مستوى الحامل + شبكة خدمة عالمية من الطبقة الأولى | نشر عابر للدول والاهتمام بشبكة الخدمة |
| HPE / Lenovo | تكامل خطوط منتجات المؤسسات (تبريد سائل بالدرجة الأولى) | خدمات مؤسسية وحلول مالية ناضجة، أشكال تقليدية | عملاء المؤسسات، والاستعانة بجهات خارجية للصيانة |
AIXX Index · مقارنة النشر بأربعة أبعاد AIXX INDEX
| الشركة المصنعة | سهولة التركيب | سهولة الصيانة | كثافة الأداء | العمر المتوقع |
|---|---|---|---|---|
| NVIDIA الرسمي | 95 | 90 | 80 | 85 |
| Supermicro سوبرميكرو | 88 | 82 | 85 | 82 |
| Gigabyte جيجابايت | 85 | 80 | 92 | 80 |
| Dell ديل | 90 | 92 | 88 | 86 |
| HPE / Lenovo | 86 | 90 | 84 | 85 |
المؤشر وفق منهجية تقديرية لهذه المكتبة (0–100، الأبعاد مطابقة لأبعاد النشر الأربعة في «سيناريوهات الاستخدام»)، وأساس التنقيط = الاختلافات المنشورة لكل شركة في الشكل وحلول التبريد وشبكة الخدمة، ويُحدَّث مع التحقق الفعلي وبيانات الدفعات، ولا يشكل أي التزام بالشراء. النماذج المحددة وفق الإعلانات الرسمية لكل شركة.
بطاقات المصطلحات GLOSSARY
ذاكرة HBM3e
ذاكرة عالية النطاق الترددي مكدسة بجانب GPU، وهي «مخزن الغذاء» لتدريب الذكاء الاصطناعي. بطاقة B300 بسعة 288GB، والثماني معًا 2.3TB.
ربط NVLink
قناة عالية السرعة مخصصة بين البطاقات (الجيل الخامس 1.8TB/s)، تجعل وحدات GPU الثماني تعمل بتناغم كأنها واحدة.
SXM / NVL8
SXM هي تغليف مثبت مباشرة على اللوحة للـ GPU (وليست بطاقة قابلة للإدخال)؛ وNVL8 تشير إلى شكل اللوحة الأساس بالربط الكامل بين البطاقات الثماني، وهي النواة الحسابية لخوادم HGX.
التبريد السائل بالصفيحة الباردة / CDU
الصفيحة الباردة تلتصق بالرقاقة لامتصاص الحرارة، وسائل التبريد ينقل الحرارة عبر الأنابيب، ووحدة CDU (وحدة توزيع السوائل) مسؤولة عن التوزيع والدوران—البنية الأساسية لغرف الحاسبات المبردة سائلًا.
FP8
تنسيق فاصلة عائمة بدقة 8 بت، الدقة السائدة في استدلال وتدريب الذكاء الاصطناعي؛ عند تقدير استهلاك الذاكرة للنموذج، الأوزان ≈ عدد المعاملات × 1 بايت.
MoE الخبراء المختلطون
معمارية نماذج كبيرة بـ«تفعيل متناثر»: عدد المعاملات الكلي ضخم (مثل 671B في DeepSeek R1)، لكن كل استدلال يفعّل جزءًا منها فقط (37B). وعند النشر تظل جميع المعاملات بحاجة إلى التحميل على البطاقات.
الحدود والجدل LIMITS
- صندوق الأسعار الأسود وفارق الأسعار بين الصين وأمريكا : السعر المعلن العلني في قنوات أمريكا الشمالية نحو $49.7×10⁴ (≈3.58 مليون يوان، بيانات أُلتقطت في 2026-10)، بينما تُسعَّر الأجهزة المتوفرة فوريًا في البر الرئيسي الصيني عادة بـ 15–17 مليون يوان —فارق سعر يتجاوز 4 أضعاف لنفس مواصفات الجهاز، وهو من أقصى العلاوات بين آلات الحوسبة السائدة عالميًا. العلاوة تراكم من ثلاث طبقات: طلب يفوق العرض بفارق كبير (العمالقة في طوابير انتظار، والطاقة الإنتاجية تُخصص للكبار، والعملاء الأفراد في طوابير طويلة)، وتشديد قانون المنع الأمريكي على الصين للإمداد النظامي، وهيمنة NVIDIA الفردية التي تمنحها سلطة التسعير (ولا تزال الفجوة أمام منافسين مثل Huawei واسعة). أما هوامش إعادة التصدير وعلاوات المخاطر في القنوات الرمادية فراجع البند التالي والسجل الزمني. الاتهامات بين الأطراف متعارضة، وهذه المكتبة تكتفي بتسجيل البيانات يومًا بيوم.
- جدل توزيع الطاقة الإنتاجية : الطاقة الإنتاجية تُخصص أولًا للعملاء الكبار الحاصلين على نصيبهم، بينما تُقاس فترات انتظار المشترين المتوسطين والصغار بالسنوات؛ وتتكرر في وسائل الإعلام المتخصصة إشارات إلى «الدفع زيادة لتخطي الطابور» وتسرب القنوات الداخلية، ولم تُعلن NVIDIA قط قواعد التوزيع— غموض التوزيع هو أكبر جدل حوكمة في خط المنتجات هذا.
- فوضى القنوات ومخاطر البطاقات المجددة : توجد في سوق التوريد الفوري حالات تزييف B200 بدل B300، وتضخيم سعة الذاكرة، وبيع بطاقات مجددة على أنها جديدة (وفق إبلاغ جهات فحص، وملاحظة هذه المكتبة: أي جهاز «جديد» من مصدر مجهول يجب التحقق من رقمه التسلسلي وتقرير الفحص). التحقق من الحالة والأصالة إجراء إلزامي في الشراء وليس خيارًا.
- الاستهلاك وعتبة النشر : 1100 وات للبطاقة، واستهلاك الجهاز الكامل ببطاقاته الثماني في مستوى 10 كيلوواط، وغرف الحاسبات القائمة تحتاج عمومًا إلى تحديث التغذية الكهربائية والتبريد؛ سقف التبريد في الشكل المبرَّد هوائيًا هو سقف الأداء نفسه، والبيئات المرتفعة أو الحارة تتطلب تشغيلًا بتخفيض الحمل.
- قيود التصدير ومتغيرات الجغرافيا السياسية : B300 خاضع لقيود التصدير الأمريكية على الصين، ومشروعية قنواته تعتمد على تراخيص الاستيراد؛ وكل تعديل في سياسة القيود يعيد رسم منظومة الأسعار مباشرة (موافقة 2026-07 على دخول H200 إلى الصين أحدثت هبوطًا حادًا في أسعار سلسلة H)—السياسة الجيوسياسية هي أكبر متغير مخاطر فردي في هذا النموذج.
شريط الأسعار MARKET DATA
| التاريخ | المنهجية | المنطقة | نطاق السعر المرجعي | ملاحظات |
|---|---|---|---|---|
| 2026-10-21 | نطاق أسعار هذه المكتبة | البر الرئيسي الصيني | 12.57 – 16.62 مليون يوان | نطاق الأسعار المعروضة (87 نقطة) |
| 2026-10-06 | لقطة الأسعار المقاسة | البر الرئيسي الصيني | 10.72 – 15.02 مليون يوان | نطاق الأسعار المعروضة (30 نقطة) |
| 2026-10-07 | لقطة الأسعار المقاسة | البر الرئيسي الصيني | 10.72 – 15.02 مليون يوان | نطاق الأسعار المعروضة (31 نقطة) |
| 2026-10-08 | لقطة الأسعار المقاسة | البر الرئيسي الصيني | 10.72 – 15.02 مليون يوان | نطاق الأسعار المعروضة (31 نقطة) |
| 2026-10-09 | لقطة الأسعار المقاسة | البر الرئيسي الصيني | 10.72 – 15.06 مليون يوان | نطاق الأسعار المعروضة (33 نقطة) |
| 2026-10-04 | السعر المرجعي المرساة | البر الرئيسي الصيني | 15.8 – 17 مليون يوان | إعدادان: A/B |
| 2026-10-05 | السعر المعلن في القنوات الخارجية | أمريكا الشمالية | انطلاقاً من 496,728 دولاراً | سعر الانطلاق المعلن لدى الموزعين[3] |
| 2026-10 | نطاق معلومات السوق | البر الرئيسي الصيني | 15 – 17 مليون يوان | من القنوات، دون تحقق من المنصة |
النطاقات اللحظية لأسواق أخرى GLOBAL
| السوق | النطاق اللحظي | الدخول المباشر إلى القاعة |
|---|---|---|
| سنغافورة (SGD) | 5.92 – 7.90 مليون | 107 عرضًا للأسعار › |
| أوروبا (EUR) | 2.88 – 3.94 مليون | 101 عرض › |
| اليابان (JPY) | 648.72 – 902.40 مليون | 95 عرضاً › |
| الشرق الأوسط (AED) | 14.31 – 18.96 مليون | 92 عرضاً › |
| الصين القارية (CNY) | 12.57 – 16.62 مليون | 87 عرضاً › |
| منطقة الدولار (USD) | 2.10 – 2.94 مليون | 82 عرضاً › |
النطاقات اللحظية المعروضة للبيع في كل سوق (بعملاتها الأصلية، تُحدَّث لحظياً مع تحميل الصفحة)؛ بالنقر على «N عروض» تصل مباشرة إلى قاعة التداول مع اختيار المنطقة تلقائياً.
المنهجية: منذ 2025-06 نطاق تقديري (مستنبط رجعياً وفق وتيرة دخول B300 الرسمي للسوق، مع هامش تقلب حسب الحالة/الإعداد)، ومنذ 2026-10 لقطات اختبار موثقة يومياً (انظر الجدول أعلاه)؛ أمريكا الشمالية بسعر القنوات المعلن محولاً إلى اليوان، والنطاق التقديري مستنبط رجعياً وفق ارتفاع الندرة النقدية منذ الدخول للسوق (نحو الضعف)، مع تثبيت سعر القنوات عند 496,728 دولاراً في 2026-10. مصدر بيانات الأسعار: AIXX Exchange مطابقة الصفقات بدون عمولة، ولا تشارك في التداول ولا تمتلك أو تخمّن أسعار الصفقات، ولذلك تبقى البيانات محايدة. النطاقات التقديرية لبقية الأسواق مستنبطة رجعياً بمعامل نحو الضعف منذ الإطلاق، مع تثبيت النهاية عند لقطة البيع اللحظية لليوم المعني. نطاق السعر المرجعي للاتجاه العام فقط ولا يشكل عرضاً تعاقدياً، والسعر الفعلي يخضع لعرض البائع.
أبرز محطات الأسعار MILESTONES
أخبار وأحداث مرتبطة TIMELINE
الأسئلة الشائعة FAQ
نعم. أوزان FP8 تعادل نحو 690 جيجابايت، وذاكرة 2.3 تيرابايت الإجمالية تتيح نشراً كاملاً على جهاز واحد بهامش واسع (انظر «توافق النماذج»).
نسخة التبريد الهوائي NVL8 صُممت خصيصاً للغرف القائمة، ويكفيها تغذية بمستوى 10kW؛ أما نسخة التبريد السائل فتتطلب بنية تحتية مناسبة (انظر «مقارنة أنظمة التبريد»).
تحقق من الطباعة الظاهرة والتقارير الرسمية للبرامج الثابتة، وعابِر الرقم التسلسلي عبر قنوات مستقلة؛ الشكل الخارجي للجيلين متشابه جداً، ولا يمكن الاعتماد على الصور وحدها (انظر «ممارسات الشراء وتجنّب الأخطاء»).
أولاً، الطلب يفوق العرض بفارق كبير — الشركات الكبرى تتنافس على المنتجات، والطاقة الإنتاجية تُوجَّه للعملاء الأكبر، والمشtrialت الفردية تنتظر طويلاً؛ ثانياً، القوانين الأمريكية الحظرية المشددة للغاية تجعل الشراء عبر القنوات الرسمية مستحيلاً؛ ثالثاً، هيمنة NVIDIA المطلقة وتفوقها التقني الفاصل (مع بقاء فجوة كبيرة أمام pursuit مثل Huawei). بتراكم العوامل الثلاثة، يتجاوز فارق الأسعار النقدية 4 أضعاف (انظر «الحدود والجدل» ونطاق السوق، بمعطيات 2026-10).
نعم، وهو في حالة عجز عرض عن الطلب: الطاقة الإنتاجية تُخصص أولاً للعملاء الكبار، وانتظار المشترين متوسطي الحجم يُقاس بالسنوات.
مقالات ذات صلة SEE ALSO
مقارنة الطرازات والاختيار COMPARE
المراجع REFERENCES
- الموقع الرسمي لـ NVIDIA — صفحة منتج Blackwell Ultra / HGX B300 https://www.nvidia.com/en-us/data-center/hgx/
- غرفة أخبار NVIDIA — إطلاق منصة Blackwell Ultra https://nvidianews.nvidia.com/news/nvidia-blackwell-ultra-ai…
- بيانات نطاق السوق — AIXX Exchange (أسعار العرض لدى المنصة ونطاقات القنوات، تحديث يومي) /hall.html
- بيان وزارة العدل الأمريكية — California Man Arrested for Smuggling More Than $300 Million in Export-Controlled Computer Servers (2026-10) https://www.justice.gov/opa/pr/california-man-arrested-smugg…